First Principles of LLMs & RL · Article 05 · Article précédent
Note de rédaction : les idées et le matériau initial sont de moi. ChatGPT a aidé à la rédaction, à la révision, aux vérifications numériques, à la figure et à la traduction.
De l’attention sélective à la lecture dynamique dans les réseaux récurrents
L’article précédent transformait le texte en vecteurs. Il reste maintenant à comprendre comment un modèle détermine quelles informations disponibles utiliser à une étape donnée.
L’Attention propose une manière d’aborder cette question. Mais avant d’en faire un calcul, partons de quelque chose de plus familier : l’attention humaine.
1. De l’attention humaine à une lecture guidée par un besoin
Imaginez une conversation avec un ami dans un café. Sa voix, la discussion à la table voisine, le bruit de la machine à café et le téléphone posé sur la table peuvent tous devenir des objets d’attention. Pour l’instant, vous voulez comprendre ce que votre ami explique : la conversation passe au premier plan. Changez d’objectif — retrouver le téléphone que vous venez de poser, par exemple — et les informations prioritaires changent aussi.
Retenons d’abord un aspect de l’attention humaine : parmi plusieurs informations disponibles, certaines bénéficient d’un traitement relativement prioritaire, tandis que d’autres passent à l’arrière-plan. Cette sélectivité occupe également une place centrale dans les descriptions psychologiques classiques de l’attention.1
Passer à l’arrière-plan ne signifie pas être totalement effacé. Et porter son attention sur quelque chose ne relève pas toujours d’un choix volontaire : un changement inattendu peut interrompre ce que nous étions en train de suivre. Cet article ne cherche pas à réunir tous les phénomènes attentionnels sous une seule métaphore. Il se concentre sur une sélection liée au but du moment : ce que j’essaie de faire influence les informations auxquelles il importe de prêter attention maintenant.1
La même distinction peut se rendre concrète dans la lecture.
Une même phrase, plusieurs objectifs de lecture
Considérons cette phrase :
Felix a laissé le carnet bleu dans la salle de réunion hier.
Elle mentionne une personne, un moment, un objet, une couleur, une action et un lieu. Avant d’en faire une entrée de modèle, imaginons que nous cherchions nous-mêmes à répondre à des questions à son sujet.
Si nous cherchons le carnet, la question est « Où a-t-il été laissé ? ». L’expression « dans la salle de réunion » apporte l’information directement pertinente. Savoir que le carnet est bleu n’est pas la priorité immédiate.
Si plusieurs carnets sont devant nous et que la question devient « De quelle couleur est celui que Felix a laissé ? », alors « bleu » devient le détail qui permet de l’identifier. Ce qui compte n’est plus seulement un lieu, mais la relation entre un objet et sa couleur.
Les mots n’ont pas changé ; l’information à extraire pour accomplir la tâche, si. Ni « bleu » ni « salle de réunion » ne possède une importance valable une fois pour toutes. Un détail peu utile pour trouver le lieu peut répondre directement à la question de la couleur.
Il s’agit d’une situation de lecture illustrative, pas d’une expérience d’oculométrie. Nous n’avons mesuré aucun ensemble de poids attentionnels pour chaque mot dans l’esprit d’une personne. L’exemple rend simplement tangible la dépendance de la pertinence à l’égard du besoin présent.
Prêter attention au contenu pertinent ne suffit pas à le comprendre
On ne peut pas non plus réduire ce processus au repérage d’un mot apparemment pertinent qui fournirait immédiatement la réponse.
Modifions légèrement la phrase :
Felix n’a pas laissé le carnet bleu dans la salle de réunion hier.
« Salle de réunion » apparaît toujours, mais nous ne pouvons plus répondre que le carnet y a été laissé. La phrase nie une action ; elle ne précise pas où le carnet se trouve réellement.
Déterminer quelles informations reçoivent de l’attention et comprendre les relations entre ces informations sont deux questions liées, mais distinctes. Pour répondre à une question de lieu, « n’a pas » peut compter davantage qu’un autre nom bien visible. Les relations entre la personne, l’objet, l’action et le lieu ne peuvent pas non plus être perdues.
Sélectionner ne signifie donc pas nécessairement ne retenir qu’un mot. Une réponse peut demander plusieurs éléments à la fois, plutôt qu’un fragment isolé découpé dans la phrase.
Transformer cette intuition en question de conception
Ces situations suggèrent une exigence pour un modèle de calcul :
Garder un ensemble d’informations accessibles, faire intervenir la tâche ou l’état actuel dans la manière de les lire, puis utiliser le résultat pour la décision suivante.
C’est une idée de conception inspirée de l’attention sélective, pas une reproduction complète de la cognition humaine. Nous n’avons pas établi que le cerveau attribue à chaque mot un poids numérique dont la somme vaut un. L’expérience de la lecture ne suffit pas à dériver le Softmax ni une formule particulière d’Attention.
Dans un modèle, le « besoin actuel » n’est pas forcément une question explicite. Il peut être représenté par l’état du modèle et le contenu en cours de génération. Comment comparer cet état aux informations disponibles, puis en tirer une lecture, reste à préciser par l’architecture.
Pour comprendre l’intérêt d’une telle conception, regardons d’abord comment les modèles de séquence stockaient et utilisaient le contexte avant l’ajout d’un mécanisme d’attention.
2. Les modèles utilisaient le contexte avant l’Attention
Dans l’article 04, la consultation de la table d’embeddings fournissait un vecteur à chaque token. Mais des consultations indépendantes ne permettaient pas à une position de lire le contenu d’une autre.
Une approche antérieure au Transformer est le réseau neuronal récurrent, ou RNN : il traite l’entrée dans l’ordre et met un état à jour à chaque étape. Soit une séquence source de T tokens ; x_j désigne le token à la position j, e_src la table d’embeddings de la langue source et h_j l’état obtenu après le traitement de cette position. Une récurrence schématique est :
\[h_j=f_{\mathrm{enc}}\bigl(h_{j-1},e_{\mathrm{src}}(x_j)\bigr).\]La même fonction de mise à jour s’applique à chaque étape. L’état actuel dépend de l’entrée courante et peut également conserver l’influence des entrées précédentes. Les LSTM et GRU sont des structures récurrentes à portes ; un LSTM distingue en plus son état caché de son état de cellule. L’équation abstraite ci-dessus ne décrit pas toutes leurs opérations internes. L’idée nécessaire ici est que la mise à jour récurrente d’un état peut incorporer le contexte précédent dans la représentation actuelle.23
L’Attention n’a donc pas inventé la possibilité pour les tokens d’utiliser le contexte. Elle a changé la manière de lire les informations, plutôt que de créer la première interaction entre positions d’une séquence.
Prenons une tâche de traduction, en traitant provisoirement les mots comme des tokens :
Source : I | like | cats
Cible  : 我 | 喜欢 | 猫
Un modèle encodeur–décodeur élémentaire lit la phrase source, l’encode dans une représentation de largeur fixe, puis laisse le décodeur produire la séquence cible à partir de cette représentation. L’article de 2014 Sequence to Sequence Learning with Neural Networks utilisait un encodeur LSTM et un décodeur LSTM.3
Pour rendre l’interface visible, représentons schématiquement ce résumé fixe par :
\[c=h_T.\]Cela ne reproduit pas le transfert de chaque couche et de chaque état dans un LSTM empilé. Nous isolons l’interface : l’information source passe par une représentation de largeur fixe avant d’être utilisée par le décodeur. L’état propre au décodeur évolue pendant la génération, sans pour autant lui donner automatiquement un accès renouvelé à chaque position source.
Des mots cibles différents peuvent demander des détails différents de la source. Générer « 我 » et générer « 猫 » ne nécessite pas forcément les mêmes éléments. Une phrase plus longue peut encore contenir davantage de relations à préserver.
Demander à un résumé de conserver à l’avance tous les détails potentiellement utiles n’est pas la même chose que permettre au modèle de relire la source selon le besoin du moment.
Une largeur fixe ne prouve pas qu’il soit mathématiquement impossible d’encoder une phrase longue. La question concerne la manière dont les modèles concrets représentent, conservent et retrouvent les informations. Bahdanau et ses collègues ont considéré la représentation de longueur fixe comme un goulot d’étranglement potentiel et proposé une autre interface de lecture.4
3. D’un résumé fixe à une source que l’on peut relire
Conservons les représentations produites par l’encodeur à toutes les positions sources :
\[h_1,h_2,\ldots,h_T.\]Ces vecteurs ne sont pas nécessairement les embeddings bruts ; ils peuvent déjà contenir du contexte. L’encodeur de Bahdanau est bidirectionnel : les états des deux directions sont concaténés pour former une annotation à chaque position. Une représentation peut donc contenir des informations sur les mots voisins, plutôt que sur le seul mot isolé.4
À chaque token cible à générer, le décodeur utilise son état actuel pour former un nouveau vecteur de contexte à partir de cet ensemble de représentations sources.
Le changement essentiel n’est pas un résumé plus long, mais un résumé que l’on peut recalculer à chaque étape de génération.
Le vecteur lu à chaque étape peut toujours avoir une dimension fixe. Il s’appuie désormais sur un ensemble accessible de représentations dont la taille augmente avec la longueur de la source.
Un travail classique de cette approche en traduction est Neural Machine Translation by Jointly Learning to Align and Translate, de Bahdanau, Cho et Bengio : prépublication en 2014, puis article à ICLR 2015. Le qualifier simplement d’« attention LSTM » masquerait un détail important : ses expériences utilisent des unités à portes de type GRU. Luong et ses collègues ont étudié des architectures d’attention fondées sur des LSTM en 2015.45
Ce n’est pas non plus le seul point de départ historique de toute l’attention en apprentissage automatique. D’autres voies existaient, notamment en vision : Mnih et ses collègues ont étudié en 2014 un modèle récurrent sélectionnant des régions d’image de manière séquentielle. Nous suivons ici la lecture souple dans les encodeurs–décodeurs parce qu’elle mène directement aux modèles de langage, sans prétendre identifier un « premier » universel.6
LSTM et GRU définissent comment mettre un état à jour. L’Attention définit comment lire le contenu d’un ensemble de représentations disponibles. Ces mécanismes peuvent fonctionner ensemble.
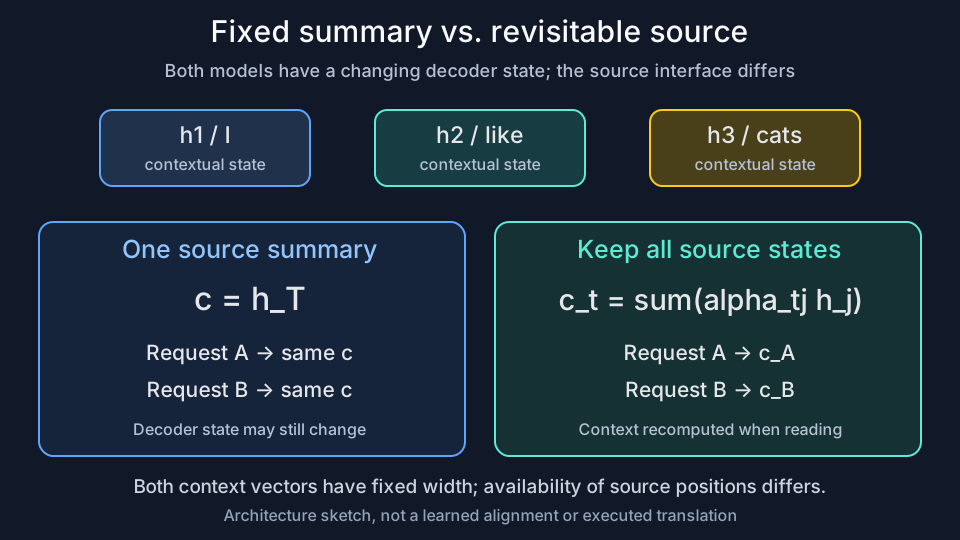
L’état du décodeur de base peut lui aussi évoluer. L’attention rend les positions sources conservées directement accessibles pour une nouvelle lecture ; les vecteurs de contexte gardent une dimension fixe. Ce schéma n’est pas un alignement appris.
4. De l’état actuel à des poids de lecture
Notons sₜ₋₁ l’état dont le décodeur dispose avant de générer le token cible t. C’est un vecteur calculé par le modèle, pas une instruction écrite à la main lui demandant de « faire attention aux chats ».
En suivant un ordre de calcul de type Bahdanau, comparons cet état à chaque représentation source à l’aide d’une fonction de score entraînable a_φ :
\[e_{tj}=a_\phi(s_{t-1},h_j),\qquad j=1,\ldots,T.\]Le symbole φ regroupe les paramètres de cette fonction. Chaque score eₜⱼ est un nombre réel qui intervient dans la participation d’une position source à la lecture courante. Il n’est pas encore une probabilité et n’a pas d’unité sémantique intrinsèque.
Choisissons le Softmax pour convertir ces scores en poids de lecture :
\[\alpha_{tj} = \frac{\exp(e_{tj})} {\sum_{k=1}^{T}\exp(e_{tk})}.\]Avec au moins une position source et des scores finis, les poids sont strictement positifs et leur somme vaut un. Ils permettent de combiner les représentations sources en un vecteur de contexte pour cette étape :
\[\boxed{ c_t=\sum_{j=1}^{T}\alpha_{tj}h_j }\]Ce sont les trois opérations de la soft attention étudiée ici : comparer l’état actuel au contenu disponible, normaliser les scores, puis lire le contenu par une combinaison pondérée. Bahdanau décrit ce mécanisme comme un alignement souple qui varie au cours de la génération cible.47
La somme porte sur les positions sources, pas sur le vocabulaire de sortie. Ces poids déterminent comment combiner les informations sources. Le décodeur doit ensuite produire une distribution différente, cette fois sur les tokens cibles possibles.
Les poids d’attention ne sont pas des probabilités du prochain token, et le vecteur de contexte n’est pas une distribution de probabilité. C’est un vecteur de même dimension que les représentations sources ; ses composantes peuvent être négatives et n’ont pas à totaliser un.
Le Softmax n’est pas la seule possibilité mathématique. Une somme pondérée directement par les scores bruts est calculable, mais elle autorise des poids négatifs et une échelle totale arbitraire. Avec des poids non négatifs et normalisés, cette lecture particulière devient une combinaison convexe des vecteurs sources. Changer la normalisation change donc l’opération de lecture.
Cela éclaire aussi le mot « soft ». Nous ne sélectionnons pas d’abord une seule position pour ne lire qu’elle. Plusieurs positions contribuent continûment : une petite modification des poids fait varier continûment le contexte lu. Sélectionner de manière discrète la position au score maximal est différent. Loin d’une frontière de sélection, de petites variations ne changent rien au choix ; à la frontière, le choix saute. Le même gradient ordinaire ne peut pas simplement traverser cette règle de sélection. Une sélection dure reste entraînable, mais demande un autre traitement ; l’apprentissage par renforcement a par exemple été employé en attention visuelle.6
Il subsiste une différence avec l’idée quotidienne de « ne regarder que ce qui compte » : cette attention souple globale calcule généralement encore un score pour chaque position source. L’agrégation est sélective ; le calcul ne devient pas automatiquement parcimonieux ni moins coûteux.
5. Comment l’attention initiale calculait-elle la compatibilité ?
La fonction de score reste à définir. Il faut permettre à l’état du décodeur et à une représentation source de déterminer ensemble une valeur scalaire.
L’attention de Bahdanau utilise pour cela un petit réseau feed-forward, aujourd’hui couramment appelé attention additive. Nous écrivons explicitement un biais. Pour garder une orientation cohérente des matrices, les états individuels sont ici des vecteurs colonnes.7
Soient d_h la dimension des représentations sources, d_s celle de l’état du décodeur et d_a la largeur de la couche intermédiaire de calcul du score. Les paramètres sont :
\[\begin{aligned} W_s&\in\mathbb R^{d_a\times d_s},\qquad W_h\in\mathbb R^{d_a\times d_h},\\ v,b&\in\mathbb R^{d_a}. \end{aligned}\]Le score s’écrit :
\[\boxed{ e_{tj} = v^\top\tanh\!\left(W_s s_{t-1}+W_hh_j+b\right) }\]Les deux matrices projettent des entrées éventuellement de dimensions différentes dans un espace intermédiaire commun. Leur somme traverse une non-linéarité appliquée coordonnée par coordonnée ; le produit scalaire avec v donne un nombre. On peut entraîner ces paramètres sans définir au préalable une échelle humaine de pertinence sémantique.
Le tanh ne sert pas seulement à donner à la formule l’apparence d’un réseau neuronal. Retirons-le un instant en conservant une simple addition linéaire.
Le score devient :
\[e_{tj} = v^\top W_s s_{t-1}+v^\top b+v^\top W_hh_j.\]À l’étape cible t fixée, l’état du décodeur apporte seulement une constante ajoutée à tous les scores sources. L’article 01 a montré que le Softmax ne change pas sous un décalage additif commun. Les poids se réduisent donc à :
\[\alpha_{tj} = \frac{\exp(v^\top W_hh_j)} {\sum_k\exp(v^\top W_hh_k)}.\]Dans cette construction particulière dépourvue de non-linéarité, l’influence de l’état actuel du décodeur sur les poids de lecture disparaît complètement. La lecture ne dépend plus de la demande courante.
La non-linéarité permet aux deux entrées d’agir conjointement sur les scores, au lieu de ne fournir qu’un décalage commun ensuite éliminé par la normalisation. Cela ne fait pas de tanh la seule solution : une interaction multiplicative peut aussi rendre la compatibilité dépendante de l’état. Il s’agit de comprendre pourquoi cette construction demande davantage que l’addition de deux scores linéaires.
Les paramètres de score sont partagés entre les étapes cibles et les positions sources. Même lorsque les paramètres appris restent fixes, changer l’état actuel peut changer les poids de lecture.
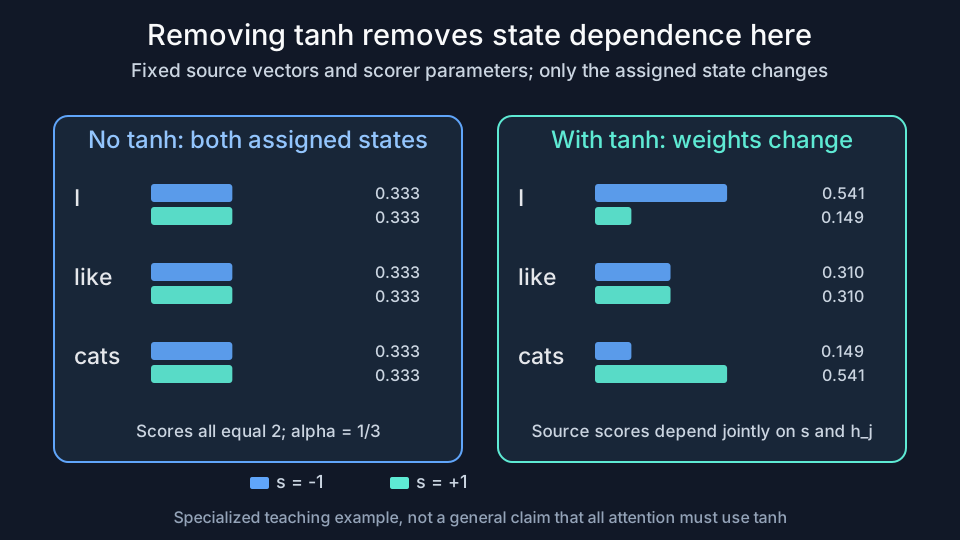
Pour ces représentations et paramètres précis, enlever tanh donne les mêmes poids uniformes pour les deux états assignés. Avec tanh, les poids changent. Aucun état ne représente une étape effectivement exécutée du décodeur.
6. Lire le même contenu autrement depuis un autre état
Prenons un petit exemple entièrement calculable.
Les trois positions sources portent les étiquettes I, like et cats. Nous fixons leurs représentations bidimensionnelles à la main. Ce ne sont ni des embeddings préentraînés ni des états cachés extraits d’un véritable modèle de traduction :
| Position source | Représentation pédagogique (coordonnées d’un vecteur colonne) |
|---|---|
1 : I | (2, 0) |
2 : like | (1, −1) |
3 : cats | (0, −2) |
Pour l’exemple, réduisons l’état du décodeur à un scalaire s et choisissons :
\[\begin{aligned} W_s&=\begin{bmatrix}1\\1\end{bmatrix}, & W_h&=\begin{bmatrix}1&0\\0&1\end{bmatrix},\\ v&=\begin{bmatrix}1\\-1\end{bmatrix}, & b&=\begin{bmatrix}0\\0\end{bmatrix}. \end{aligned}\]En notant hⱼ,₁ et hⱼ,₂ les deux coordonnées de la représentation source, le score se développe en :
\[e_j(s) = \tanh(s+h_{j,1})-\tanh(s+h_{j,2}).\]Fixons s = −1 pour l’état A et s = 1 pour l’état B, sans rien changer d’autre :
| Source | Score A | Poids A | Score B | Poids B |
|---|---|---|---|---|
I | 1.5232 | 0.5414 | 0.2335 | 0.1491 |
like | 0.9640 | 0.3095 | 0.9640 | 0.3095 |
cats | 0.2335 | 0.1491 | 1.5232 | 0.5414 |
Avec les poids non arrondis, les deux vecteurs de contexte valent approximativement :
\[c_A\approx \begin{bmatrix} 1.392334\\-0.607666 \end{bmatrix}, \qquad c_B\approx \begin{bmatrix} 0.607666\\-1.392334 \end{bmatrix}.\]La lecture change parce que son état actuel change, pas parce que nous réentraînons les paramètres ou modifions la phrase source.
En faisant varier s sur un intervalle, nous pouvons voir comment les poids répondent à cet état :
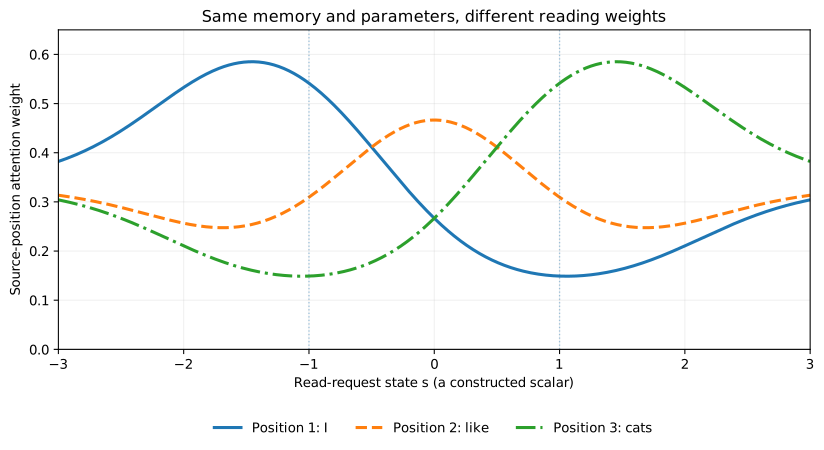
L’abscisse est un état de lecture construit, pas le temps d’entraînement ni les étapes exécutées d’un décodeur. Chaque point réévalue la même fonction d’attention ; ces courbes ne sont pas des alignements linguistiques mesurés.
L’exemple établit une seule chose : ce calcul différentiable peut lire différemment le même contenu selon l’état actuel. Il ne prouve pas que s = −1 signifie « sur le point de traduire 我 », ni que le modèle comprend la phrase.
Un poids élevé ne représente pas non plus automatiquement l’importance causale complète d’un mot d’entrée. Sa représentation peut déjà inclure d’autres mots, et le contexte lu sera encore transformé. Un contre-exemple simple est un ensemble de vecteurs sources tous identiques : n’importe quelle pondération de somme un produit le même contexte.
Les poids d’attention décrivent comment ce nœud du calcul combine le contenu. Ils ne suffisent pas, à eux seuls, à expliquer toute la prédiction.
7. Comment apprendre où regarder sans étiquettes d’alignement ?
Nous avons fixé les paramètres de score de l’exemple. Qu’est-ce qui les rendrait utiles dans un modèle entraîné ?
Le signal d’apprentissage vient toujours de l’objectif de prédiction des articles précédents.
Notons y_t le token cible à l’étape t. Dans un modèle suivant l’ordre de lecture de Bahdanau, le décodeur calcule d’abord c_t, puis le combine à son état précédent et à l’embedding du token cible précédent pour mettre son état à jour. Notons e_tgt la consultation d’embedding de la langue cible. Schématiquement :
\[s_t = f_{\mathrm{dec}}\bigl(s_{t-1},e_{\mathrm{tgt}}(y_{t-1}),c_t\bigr).\]Le token y₀ marque le début de la séquence. La couche de sortie utilise ensuite l’état du décodeur et d’autres informations disponibles pour former une distribution sur le vocabulaire cible. L’équation expose les dépendances ; elle ne reproduit pas chaque détail des couches de sortie de l’article d’origine.47
Soit U la longueur de la cible, la source conservant ses T tokens. Regroupons tous les paramètres entraînables sous θ, y compris les paramètres de score φ. Les deux séquences n’ont pas besoin d’avoir la même longueur. Pour une paire source–cible, la perte peut s’écrire :
\[\mathcal L(\theta) = -\sum_{t=1}^{U} \log p_\theta(y_t\mid y_{<t},x_{1:T}).\]La cible réelle y_t sert à calculer la perte. Elle n’est pas fournie en avance comme réponse au mécanisme d’attention de cette même étape. Pendant l’entraînement, on peut fournir les tokens cibles réels précédents : c’est le teacher forcing. Fournir le passé n’est pas la même chose que révéler le token à prédire maintenant.7
Les gradients de prédiction se propagent de la sortie vers le contexte, les poids de lecture, le réseau de score et les représentations de l’encodeur. Dans ce cadre, le calcul des scores peut être entraîné avec le modèle de traduction sans étiqueter séparément la position source correspondant à chaque mot cible.4
Une partie de cette relation se dérive directement. Considérons le contexte actuel comme un nœud du graphe de calcul, gardons les vecteurs sources fixes et écrivons le gradient reçu des calculs suivants sous forme de vecteur colonne :
\[g_t=\frac{\partial\mathcal L}{\partial c_t}.\]En dérivant le Softmax et la somme pondérée, la sensibilité de cette lecture à un score source est :
\[\frac{\partial c_t}{\partial e_{tj}} = \alpha_{tj}(h_j-c_t).\]Appliquons alors la règle de chaîne de l’article 03 :
\[\boxed{ \frac{\partial\mathcal L}{\partial e_{tj}} = \alpha_{tj}\,g_t^\top(h_j-c_t) }\]Cela explique une partie de ce qu’« apprendre où regarder » veut dire. Si augmenter légèrement le score d’une position déplaçait le contexte dans une direction réduisant la perte, le gradient local de ce score favoriserait ce changement. Il se propage ensuite dans les paramètres partagés du calcul de score.
Nous venons de calculer le gradient passant par une opération de lecture, avec des représentations sources fixes. L’entraînement complet modifie aussi ces représentations, et les mises à jour des paramètres dépendent d’autres calculs du décodeur et d’autres exemples. Rien ne garantit que chaque mise à jour rende l’alignement plus conforme à l’intuition humaine.
La prédiction finale est supervisée ; la manière de lire reçoit son signal d’apprentissage par l’effet qu’elle produit sur cette prédiction.
8. De l’attention initiale à une autre architecture
L’Attention ne se résume plus à une formule QKV particulière.
Dans le modèle que nous venons de construire, un RNN produit les représentations sources, le décodeur fournit l’état courant et l’attention combine les informations en fonction de ces deux éléments. La récurrence n’a pas disparu : le mécanisme de lecture s’est ajouté à un modèle récurrent.
Les travaux de Luong et de ses collègues en 2015 conservaient des LSTM tout en explorant des lectures globales ou locales, des scores par produit scalaire et des scores faisant intervenir une matrice apprise. Leur ordre de décodage diffère également de celui du modèle de Bahdanau. Remplacer une équation de score ne suffit donc pas à reproduire l’architecture complète.5
Il est utile de garder deux questions distinctes : comment l’état actuel est-il formé, et comment cet état lit-il le contenu disponible ?
De même, l’encodeur source bidirectionnel peut lire toute la phrase source parce que celle-ci est déjà disponible dans une traduction hors ligne. Cela ne lui révèle pas les futurs tokens cibles. Une lecture à l’intérieur d’un modèle de langage autorégressif exige une décision distincte sur les positions visibles. Il n’existe pas un masque unique à appliquer indistinctement à tout mécanisme d’attention.
Nous pouvons maintenant poser les questions suivantes. Si chaque position doit lire des informations, pourraient-elles toutes formuler leur propre demande ? La représentation utilisée pour juger de la compatibilité doit-elle être celle dont le contenu sera finalement lu ? Faut-il nécessairement commencer par un réseau récurrent pour organiser ces demandes ?
Ces questions nous mèneront à la self-attention, à Q/K/V et aux mises à jour de représentation du Transformer. Avant de les introduire, l’idée développée ici est déjà concrète :
Conserver un ensemble de représentations accessibles, utiliser l’état actuel pour déterminer une lecture, puis employer cette lecture dans la prédiction suivante.
QKV est une manière d’organiser cette idée, pas un point de départ obligatoire pour comprendre l’Attention.
Reproduire l’exemple numérique et ses vérifications de gradient.
-
William James, The Principles of Psychology, Chapter XI: Attention, 1890, especially the opening discussion and “The Varieties of Attention.” Cited for the classical conceptual description of selection and voluntary/involuntary attention, not as a complete contemporary theory or evidence for a neural-network mechanism. The café and notebook examples are illustrative scenarios, not reported experimental results. ↩ ↩2
-
Kyunghyun Cho et al., Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation, EMNLP 2014. The recurrent-state equation in this article is schematic rather than a complete derivation of a GRU or LSTM cell. ↩
-
Ilya Sutskever, Oriol Vinyals, and Quoc V. Le, Sequence to Sequence Learning with Neural Networks, NeurIPS 2014. Fixed-dimensional encoder–decoder using LSTMs; the text’s c=h_T is a simplified interface, not all of the original stacked LSTM states. ↩ ↩2
-
Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio, Neural Machine Translation by Jointly Learning to Align and Translate, arXiv preprint 2014, ICLR 2015. Sections 2–3 and Appendix A. The experiments use the GRU-type gated units described in Appendix A, not LSTM cells. This article writes an explicit bias in the additive scorer. The scalar-state example, nonlinearity ablation, and score-gradient derivation are independent teaching calculations, not results reported by the paper. ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
Minh-Thang Luong, Hieu Pham, and Christopher D. Manning, Effective Approaches to Attention-based Neural Machine Translation, EMNLP 2015, pp. 1412–1421. Sections 2–3 distinguish LSTM/GRU choices, scoring functions, and the computation order relative to Bahdanau attention. ↩ ↩2
-
Volodymyr Mnih, Nicolas Heess, Alex Graves, and Koray Kavukcuoglu, Recurrent Models of Visual Attention, NeurIPS 2014. A distinct attention route involving sequential spatial selection and reinforcement-learning-based training; it is not the normalized additive attention used in the numerical example. ↩ ↩2
-
PyTorch, NLP From Scratch: Translation with a Sequence to Sequence Network and Attention. The tutorial’s additive scorer and teacher-forcing implementation provide an independent implementation reference; this article does not reproduce its trained results. ↩ ↩2 ↩3 ↩4