First Principles of LLMs & RL · Article 05 · 上一篇文章
写作说明:想法与初始材料来自作者本人;ChatGPT 协助了草拟、编辑、数值核查、配图和翻译。
从选择信息的直觉,到循环网络中的动态读取
上一篇把文本变成了向量。接下来要解释的是:面对一组可用的信息,模型怎样决定在当前这一步使用哪些内容?
这个问题被称为 Attention,但在进入计算之前,值得先从我们熟悉的人类注意力说起。
一、从人的注意力,到按需要读取信息
想象你正坐在咖啡馆里和朋友交谈。朋友的声音、邻桌的谈话、咖啡机的响声,以及桌面上的手机,都可能成为你关注的对象。此刻,你想听清朋友正在解释的一件事,于是把交谈作为重点。换一个目标——比如寻找刚才放下的手机——需要优先处理的信息也就变了。
这里先抓住人类注意力的一个侧面:在同时可用的多种信息中,一部分获得相对优先的处理,而其他内容暂时退到背景。 这种选择性,也是心理学对注意力的经典描述所强调的特征。1
“退到背景”不等于被彻底删除;“注意”也不一定是主动选择。一次突如其来的变化同样可能打断原来的关注。本文不试图用一个比喻覆盖所有注意现象,而是先聚焦于其中与当前目标有关的选择:我现在要做的事情,会影响什么信息对我更值得关注。1
这种区别,也可以放进阅读中看。
同一句话,阅读目标可以不同
考虑这句话:
Felix昨天把蓝色笔记本留在会议室。
它包含人物、时间、物品、颜色、动作和地点。先不把它看成模型输入,假设现在是我们自己要根据这句话回答问题。
如果正在寻找笔记本,问题是“笔记本被留在哪里?”,那么“留在会议室”提供了直接相关的信息。知道笔记本是蓝色的,对这个回答暂时不是重点。
如果眼前有几本笔记本,问题变成“哪种颜色的是Felix留下的那本?”,那么“蓝色”就成为关键的辨认信息。我们需要的已不只是地点,而是物品与颜色之间的对应关系。
文字没有变,任务需要提取的信息变了。 不能因此给“蓝色”或“会议室”贴上一张永远有效的“重要程度”标签。对位置问题不关键的内容,可能恰好是颜色问题的答案。
这里描绘的是一种按任务阅读的情境,不是一次眼动实验,也没有为人的每个词测量出一组 attention weights。它只是让“相关性依赖当前需要”变得具体。
关注相关内容,还不等于完成理解
也不能把这个过程简化成:找到一个看起来相关的词,就得到答案。
把原句稍微改一下:
Felix昨天没有把蓝色笔记本留在会议室。
“会议室”仍然出现了,但不能再据此回答“笔记本被留在会议室”。这句话否定了一个行为,并没有告诉我们笔记本到底在哪里。
因此,关注哪些信息,与怎样理解这些信息之间的关系,是相互关联却不能混为一谈的问题。 为了回答地点问题,“没有”可能比另一个显眼的名词更重要;人物、物品、动作和地点之间的关系也不能丢掉。
这个例子还说明,选择不必等于只保留一个词。一个回答可能需要几处信息共同参与,而不是把整句话裁剪成一个孤立片段。
从人的阅读,提出一个模型设计问题
从这些情境中,我们可以提炼出一个计算上的要求:
保留一组可用的信息,让当前的任务或状态参与决定怎样读取它们,再把读取结果用于后续判断。
这是从人的选择性关注中提取出的设计思路,不是对人类注意力机制的完整复现。我们还没有理由声称人脑会给每个词分配一个总和为一的权重,更不能由人的阅读体验直接推出 Softmax 或某一种 Attention 公式。
在计算模型里,“当前需要”也不一定是一句明确的问题。它可以由模型正在生成的内容和当下的状态来表示。怎样比较这个状态与可用信息,怎样形成读取结果,都还需要具体的结构设计。
沿着这条线,下一步应当先看:在没有 Attention 的序列模型中,上下文原本怎样被保存和使用?哪些限制,会让“根据当前状态重新读取信息”成为一个值得尝试的方案?
二、没有 Attention,模型也可以处理上下文
第四篇里的 embedding lookup 为每个 token 提供向量,但独立查表不会让一个位置读取另一个位置。
一种早于 Transformer 的解决办法是循环神经网络,RNN:依次处理输入,并在每一步更新一个状态。设源序列有 T 个 token,x_j 是第 j 个 token,e_src 是源语言的 embedding lookup,h_j 是处理到当前位置时的状态。一个简化的递归关系是:
\[h_j=f_{\mathrm{enc}}\bigl(h_{j-1},e_{\mathrm{src}}(x_j)\bigr).\]每一步使用同一个状态更新函数。当前状态既依赖当前输入,也可以携带此前输入的影响。LSTM 和 GRU 是带门控的循环结构;LSTM 还区分 hidden state 与 cell state,不能把上面这个抽象关系当作它全部的内部方程。此处只需要理解:模型可以通过递归更新状态,把前文带进当前表示。23
因此,不应该说“直到 Attention 出现,token 才能利用上下文”。Attention 改变的是读取信息的方式,不是第一次让序列中的位置发生联系。
考虑一个翻译任务,仍然暂时把单词当作 token:
源句:I | like | cats
目标:我 | 喜欢 | 猫
一种基本的 encoder–decoder 结构先读完整个源句,把它编码成固定宽度的表示,再让 decoder 根据这个表示生成目标序列。2014 年的 Sequence to Sequence Learning with Neural Networks 就使用了 LSTM encoder 和 LSTM decoder。3
为了看清接口,可以用下面的简化形式代表固定摘要:
\[c=h_T.\]这不是在复现所有 LSTM 层和状态的传递细节,而是在强调:源句的信息先经过一个固定宽度的表示,再供解码器使用。decoder 自己的状态会随生成过程改变,但它不因此自动获得重新访问每个源位置的接口。
问题在于,生成不同的目标词,所需的源端信息可能不同。生成“我”与生成“猫”,不必使用完全相同的源端细节;源句也可能更长,包含更多不同关系。
要求一个摘要预先保留所有以后可能用到的细节,与允许模型按当前需要重新读取源句,是两种不同的设计。
固定宽度并不构成“数学上绝对无法编码长句”的证明。这里的问题是实际模型怎样表示、保留和提取信息。Bahdanau 等人正是把固定长度表示视为一个潜在瓶颈,提出了不同的读取接口。4
三、把“只能使用摘要”改成“可以重新读取”
先保留 encoder 在各个源位置产生的表示:
\[h_1,h_2,\ldots,h_T.\]这些向量不必是原始 embedding。它们可以已经包含上下文。在 Bahdanau 的模型里,encoder 使用双向循环网络,将两个方向的状态拼接成各位置的 annotation。因此,一个位置的表示可以包含周围词的信息,不是只代表该词孤立的含义。4
decoder 每生成一个目标 token,就重新根据自己的当前状态,从这组表示中形成一个适合本次预测的上下文向量。
变化的关键不是“摘要变长了”,而是摘要可以在每一个生成步骤重新计算。
每次读出的向量仍然可以具有固定维度;区别是背后保留了一组随源序列长度增长的可访问表示。
这条翻译路线的经典早期工作,是 Bahdanau、Cho 和 Bengio 的 Neural Machine Translation by Jointly Learning to Align and Translate:预印本发表于 2014 年,会议版本发表于 ICLR 2015。这里不能笼统地称它为“LSTM attention”:论文实验使用的是 GRU 类门控单元。Luong 等人在 2015 年则研究了基于 LSTM 的 attention 架构。45
这也不是整个机器注意力研究的唯一历史起点。同期还有视觉注意力等路线,例如 Mnih 等人 2014 年研究了循环模型按步骤选择图像区域。本文选择的是与语言模型直接相关的 encoder–decoder 软读取路线,而不是要给所有 attention 排一个唯一的“第一”。6
LSTM/GRU 回答状态怎样更新;Attention 回答怎样从一组可用表示中读取内容。它们可以一起使用,不是互相排斥的替代品。
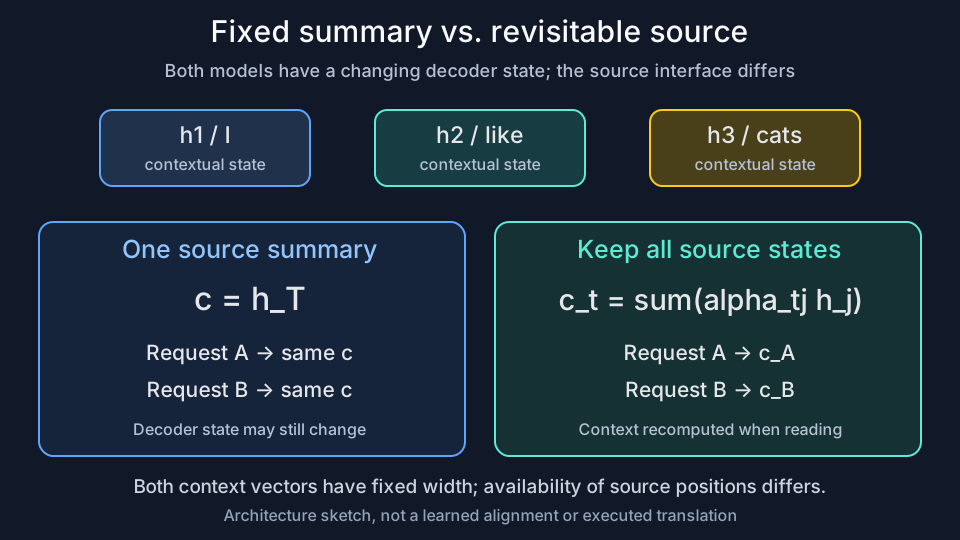
基础 encoder–decoder 的 decoder 状态也可以持续更新。Attention 增加的是重新访问保留的源位置表示的能力;两种结构读出的向量都保持固定维度。这是架构示意,不是训练得到的对齐。
四、从当前需求,到一组读取权重
把 decoder 在生成第 t 个目标 token 前已经具有的状态记为 sₜ₋₁。它是模型计算出的向量,不是一句人为写给模型的“请注意猫”。
接下来按照 Bahdanau 式的顺序组织读取。对每个源位置 j,用一个可学习的评分函数 a_φ 比较 decoder 状态与源表示:
\[e_{tj}=a_\phi(s_{t-1},h_j),\qquad j=1,\ldots,T.\]φ 表示这个评分函数的参数。eₜⱼ 是给这个候选来源的实数评分,用来决定它怎样参与当前读取。它还不是概率,也没有天然的语义单位。
我们选择用 Softmax 将这些分数转换成一组读取权重:
\[\alpha_{tj} = \frac{\exp(e_{tj})} {\sum_{k=1}^{T}\exp(e_{tk})}.\]当 T 至少为一、分数有限时,每个权重都为正,总和为一。然后把源表示加权组合,得到本次读取的上下文向量:
\[\boxed{ c_t=\sum_{j=1}^{T}\alpha_{tj}h_j }\]这三步就是本文讨论的 soft attention:比较当前状态与可用内容,归一化分数,再根据权重读取内容。Bahdanau 论文将这种机制写成随目标生成步骤改变的 soft alignment。47
这里的求和发生在源位置上,不是输出词表上。读取权重描述从哪些位置组合信息;decoder 随后还要计算另一个分布,预测目标词表中的 token。
Attention weights 不是 next-token probabilities,读出的 context vector 也不是概率分布。 它只是与源表示同维度的向量,可以有负分量,不要求各分量相加等于一。
Softmax 也不是数学上唯一可能的选择。直接用原始分数做加权求和同样能算,但允许负权重、任意总尺度;这里选择非负、归一化的权重,使一次读取成为这些源向量的凸组合。改变归一化方法,就改变了具体的读取算子。
这也解释了“soft”在哪里:我们不是先选出一个位置,再只读取那个位置,而是让多个位置连续地参与。权重稍微改变,读出的向量也随之改变。选最大分数的离散位置则不同——远离切换边界时,微小改动不改变选择,在边界处又会跳变,不能直接用同样的普通梯度贯穿选择操作。硬选择并非不可训练,只是需要另外处理;视觉注意力中就有使用强化学习的例子。6
最后,人的“只看重点”和这里的计算仍然有一个差别:这种全局 soft attention 通常仍然为所有源位置计算分数。它让汇总有选择性,不自动意味着省去了读取或评分的计算。
五、早期 Attention 怎样计算“匹配”?
评分函数目前还是一个空位。我们需要一种方式,让 decoder 的状态与某个源位置的表示共同决定分数。
Bahdanau attention 使用一个小型前馈网络做这件事,后来通常称为 additive attention。下面采用显式写出偏置的形式;为统一矩阵方向,本篇把单个状态表示为列向量。7
设源表示的维度为 d_h,decoder 状态的维度为 d_s,评分网络中间层的宽度为 d_a。使用参数:
\[\begin{aligned} W_s&\in\mathbb R^{d_a\times d_s},\qquad W_h\in\mathbb R^{d_a\times d_h},\\ v,b&\in\mathbb R^{d_a}. \end{aligned}\]评分公式是:
\[\boxed{ e_{tj} = v^\top\tanh\!\left(W_s s_{t-1}+W_hh_j+b\right) }\]两个矩阵先把不同宽度的输入变到同一个中间空间;相加以后经过逐分量非线性;最后与 v 做点积,得到一个标量。我们可以训练这些参数,而不需要事先定义一个“语义相关性量表”。
这里的 tanh 不只是为了让公式看起来像神经网络。做一个检验:如果拿掉它,保留纯线性相加,会怎样?
分数就变成:
\[e_{tj} = v^\top W_s s_{t-1}+v^\top b+v^\top W_hh_j.\]对于同一个 t,decoder 状态贡献的只是所有分数共同增加的常数。第一篇已经解释过,Softmax 对这样的共同平移不变。因此:
\[\alpha_{tj} = \frac{\exp(v^\top W_hh_j)} {\sum_k\exp(v^\top W_hh_k)}.\]在这个去掉非线性的特定构造中,当前 decoder 状态对读取权重的影响完全消失了。 它又变成了一份与当前请求无关的读取方案。
非线性让两组输入可以共同影响分数,而不只是贡献一个随后被消掉的公共偏移。这不是说 tanh 是唯一办法;乘法式的交互也可以让当前状态影响匹配。这里是在解释这一个构造为什么需要比“两个线性分数相加”更多的结构。
同一组评分参数在不同步骤、不同来源位置之间共享。训练以后即使参数不变,只要当前状态改变,读取权重仍然可以改变。
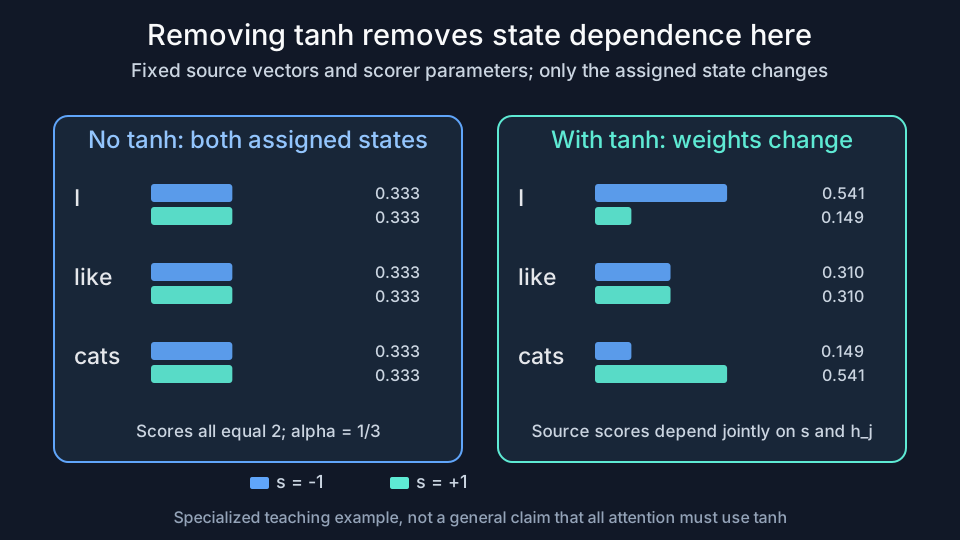
在本文这组参数下,去掉 tanh 后,无论指定哪一个状态,三个源位置权重都相同;使用 tanh 时则会变化。这些状态不是已经执行的 decoder 时间步。
六、同一份内容,换一种状态就换一种读取
用一个可以完整复算的小例子看看。
仍把三个源位置标成 I、like、cats。下面的二维表示由我们人为指定,不是训练好的词向量,也不是一个真实翻译模型的隐藏状态:
| 源位置 | 教学用源表示(列向量的坐标) |
|---|---|
1:I | (2, 0) |
2:like | (1, −1) |
3:cats | (0, −2) |
把一次读取使用的 decoder 状态简写为标量 s。选择:
\[\begin{aligned} W_s&=\begin{bmatrix}1\\1\end{bmatrix}, & W_h&=\begin{bmatrix}1&0\\0&1\end{bmatrix},\\ v&=\begin{bmatrix}1\\-1\end{bmatrix}, & b&=\begin{bmatrix}0\\0\end{bmatrix}. \end{aligned}\]因此,如果 h_{j,1} 和 h_{j,2} 分别表示源向量的两个坐标,评分可以直接展开成:
\[e_j(s) = \tanh(s+h_{j,1})-\tanh(s+h_{j,2}).\]先给状态 A 指定 s=−1,再给状态 B 指定 s=1,其他内容全部保持不变:
| 来源 | A 的分数 | A 的权重 | B 的分数 | B 的权重 |
|---|---|---|---|---|
I | 1.5232 | 0.5414 | 0.2335 | 0.1491 |
like | 0.9640 | 0.3095 | 0.9640 | 0.3095 |
cats | 0.2335 | 0.1491 | 1.5232 | 0.5414 |
用没有舍入的权重计算,两次读出的 context vector 分别约为:
\[c_A\approx \begin{bmatrix} 1.392334\\-0.607666 \end{bmatrix}, \qquad c_B\approx \begin{bmatrix} 0.607666\\-1.392334 \end{bmatrix}.\]变化来自这次读取的状态,不是来自重新训练参数,也不是源句发生了变化。
把 s 在一个区间里连续改变,还可以看到每个来源的权重怎样响应:
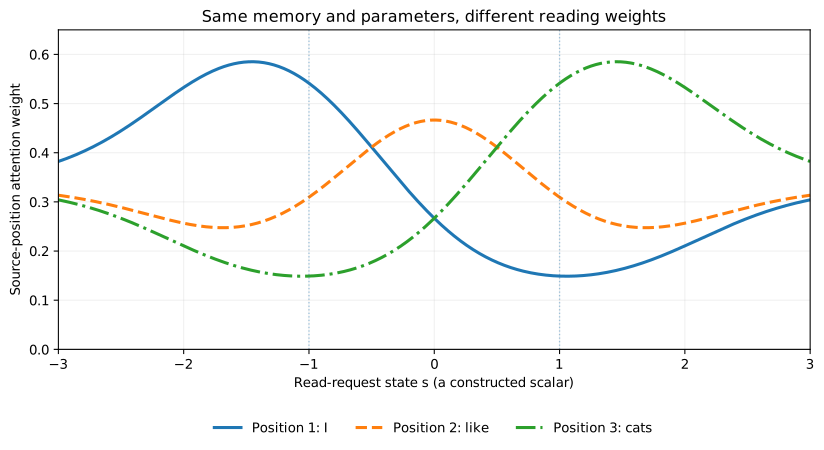
横轴是人为指定的读取状态,不是训练时间,也不是已经执行的 decoder 时间步。每个横坐标都重新计算一次同样的 attention 函数;曲线不代表真实语言对齐。
这个例子只证明了一件事:这一套可微计算能够根据当前状态,对同一组内容形成不同的读取结果。它没有证明 s=−1 就意味着“准备翻译我”,也没有证明模型已经理解了这句话。
同样,不能把高权重直接等同于输入词的完整因果重要性。源表示本身可能包含其他词的信息;读出的向量还会进入后续计算。一个简单反例是:如果所有源向量完全相同,无论怎样分配总和为一的权重,读取结果都一样。
注意权重告诉我们这个计算节点怎样组合内容;仅凭这组权重,不能完整解释最终预测。
七、没有人标注“应该看哪里”,它怎样学会?
前面的评分参数是我们指定的。真正训练时,是什么让它们变得有用?
仍然是前几篇的预测目标。
用 y_t 表示第 t 个目标 token。在采用 Bahdanau 式读取顺序的模型中,算出 c_t 以后,decoder 再把它与先前状态、上一个目标 token 的 embedding 一起用于状态更新。把目标语言的 lookup 写成 e_tgt,简化表示为:
\[s_t = f_{\mathrm{dec}}\bigl(s_{t-1},e_{\mathrm{tgt}}(y_{t-1}),c_t\bigr).\]y₀ 是起始符。输出层再利用 decoder 的状态等信息,形成目标词表上的分布。这个公式只展示依赖关系,并不逐项复现原论文的所有输出层细节。47
设目标序列长度为 U,源句仍为 x_{1:T},模型所有可训练参数汇总为 θ,其中包括评分参数 φ。源序列与目标序列的长度不必相同。给定一对源句与目标句,训练损失可以写成:
\[\mathcal L(\theta) = -\sum_{t=1}^{U} \log p_\theta(y_t\mid y_{<t},x_{1:T}).\]真实目标 y_t 用来计算这一步的损失,不会先作为同一步 attention 的答案输入。训练中可以给模型此前的真实目标 token,称为 teacher forcing;“给过去的 token”和“提前提供当前待预测的 token”是不同的事。7
模型预测错了,梯度从输出往回传播,可以到达 context vector、读取权重、评分网络,以及 encoder 的表示。在这样的训练设置下,不需要另外把每个目标词对应哪个源位置标成监督标签,评分网络也可以与翻译模型一起优化。4
这个关系还可以直接推出来。把本次 context vector 看作计算图中的一个节点,暂时固定源向量,并把从后续计算传回来的梯度也写成列向量:
\[g_t=\frac{\partial\mathcal L}{\partial c_t}.\]由 Softmax 和加权和可得,本次读取对一个分数的敏感性为:
\[\frac{\partial c_t}{\partial e_{tj}} = \alpha_{tj}(h_j-c_t).\]再应用第三篇的链式法则:
\[\boxed{ \frac{\partial\mathcal L}{\partial e_{tj}} = \alpha_{tj}\,g_t^\top(h_j-c_t) }\]这条式子解释了“学会看哪里”的一部分含义:如果稍微提高某个位置的分数,能把读出的向量推向降低损失的方向,那么这个分数对应的局部梯度就会倾向于推动那种变化。随后,梯度继续传到共享的评分参数。
这里分析的是固定源表示时、经过这次读取节点的一条梯度关系。完整训练还会更新源表示,也会受到后续 decoder 计算与其他样本的共同约束。它并不保证每一步更新都让对齐更符合人的直觉。
被监督的是最终预测;“怎样读取”通过它对预测的影响获得学习信号。
八、从早期 Attention,走向下一种结构
理解到这里,Attention 不再等同于某一个 QKV 公式。
在刚才的模型里,RNN 先为源句产生一组表示,decoder 提供当前状态,attention 根据两者动态组合上下文。RNN 没有消失;读取机制是加在循环模型上的。
Luong 等人的 2015 年工作继续使用 LSTM,但探索了不同的全局、局部读取方式,以及点积、带矩阵的点积等评分形式。它们与 Bahdanau 模型的解码计算顺序也有区别,不应仅仅换一个评分公式就宣称复现了整个模型。5
因此,我们应该把两件事分开:一件是“当前状态怎样形成”,另一件是“这个状态怎样从可用内容中读取信息”。
同样,本文的双向 source encoder 可以读取完整源句,因为离线翻译的源句已经给定;它没有因此读取未来的目标词。换成自回归语言模型内部的读取时,哪些位置可见,就需要另外规定。这不是给所有 attention 都套上同一个遮罩规则。
现在才适合提出下一步的问题:如果每个位置都要读取信息,是否可以让所有位置分别提出请求?用于判断匹配的表示,是否必须与最后读回的内容是同一个向量?又是否一定要先用循环网络组织这些请求?
这些问题会把我们带向 self-attention、Q/K/V,以及 Transformer 如何更新表示。但在引入它们之前,本文想留下的核心已经足够具体:
保留一组可访问的表示,根据当前状态计算读取方式,再把读取结果用于下一步预测。
QKV 是这条思路的一种组织方式,不是理解 Attention 时必须接受的起点。
-
William James, The Principles of Psychology, Chapter XI: Attention, 1890, especially the opening discussion and “The Varieties of Attention.” Cited for the classical conceptual description of selection and voluntary/involuntary attention, not as a complete contemporary theory or evidence for a neural-network mechanism. The café and notebook examples are illustrative scenarios, not reported experimental results. ↩ ↩2
-
Kyunghyun Cho et al., Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation, EMNLP 2014. The recurrent-state equation in this article is schematic rather than a complete derivation of a GRU or LSTM cell. ↩
-
Ilya Sutskever, Oriol Vinyals, and Quoc V. Le, Sequence to Sequence Learning with Neural Networks, NeurIPS 2014. Fixed-dimensional encoder–decoder using LSTMs; the text’s c=h_T is a simplified interface, not all of the original stacked LSTM states. ↩ ↩2
-
Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio, Neural Machine Translation by Jointly Learning to Align and Translate, arXiv preprint 2014, ICLR 2015. Sections 2–3 and Appendix A. The experiments use the GRU-type gated units described in Appendix A, not LSTM cells. This article writes an explicit bias in the additive scorer. The scalar-state example, nonlinearity ablation, and score-gradient derivation are independent teaching calculations, not results reported by the paper. ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
Minh-Thang Luong, Hieu Pham, and Christopher D. Manning, Effective Approaches to Attention-based Neural Machine Translation, EMNLP 2015, pp. 1412–1421. Sections 2–3 distinguish LSTM/GRU choices, scoring functions, and the computation order relative to Bahdanau attention. ↩ ↩2
-
Volodymyr Mnih, Nicolas Heess, Alex Graves, and Koray Kavukcuoglu, Recurrent Models of Visual Attention, NeurIPS 2014. A distinct attention route involving sequential spatial selection and reinforcement-learning-based training; it is not the normalized additive attention used in the numerical example. ↩ ↩2
-
PyTorch, NLP From Scratch: Translation with a Sequence to Sequence Network and Attention. The tutorial’s additive scorer and teacher-forcing implementation provide an independent implementation reference; this article does not reproduce its trained results. ↩ ↩2 ↩3 ↩4