First Principles of LLMs & RL · Article 04 · 上一篇文章
写作说明:本文的问题与编辑方向由作者提出;ChatGPT 协助起草、数学核查、配图、编辑和翻译。
从 Tokenization,到可学习的 Embedding 与位置表示
前三篇解释了模型怎样给出概率、怎样衡量损失,以及怎样用梯度更新参数。但我们一直把输入处理得很简单:先假设模型已经有一些数,再讨论这些数应该怎样变化。
现在需要把问题往前推一步。
屏幕上的 I like cats 是一段文本。矩阵乘法处理的却是数值。我们怎样从前者走到后者,而且让这些数值值得被模型计算?
“计算机只认识数字,所以需要 embedding”还不够。Token ID 已经是数字,但一个编号并没有告诉模型怎样表示一个词。 这里至少有三件不同的事:决定文本切成什么单位,给单位分配身份,再为这些身份构造可以学习的表示。
Embedding 应该从这三件事的区别开始,而不是从一张已经把相似词聚在一起的散点图开始。
一、先决定模型究竟在读取什么
对文本进行 tokenization,就是把它转换成模型处理的单位序列。这些单位可以是词、字符、子词或字节相关的片段;token 不必等于语言学意义上的词。 BPE、WordPiece 和 Unigram 都是构造子词切分的代表性方法,但它们不是同一个算法。1
例如,若只按完整单词建词表,cat 和 cats 可以是两个独立条目。问题是新词形、名字和拼写变化不断出现;若全部压成一个 unknown token,差异就丢掉了。另一端是逐字符处理:组合更灵活,但同一段文本可能变成更长的序列。
子词方法在这之间寻找折中。以字符级 BPE 的一种简化设置为例:先把每个词拆成字符,统计相邻符号对,合并频率最高的一对,再重新统计。训练得到的是有顺序的合并规则;处理新文本时,使用这些规则,而不是重新从那一条文本学习一套切分。2
构造一个只有四种词形的小语料:cat 出现 5 次,cats 出现 3 次,dog 出现 4 次,dogs 出现 2 次。我们不跨词边界合并,并规定频率相同时选择遍历时最先遇到的符号对。前四次合并为:
c + a  → ca       8 次
ca + t → cat      8 次
d + o  → do       6 次
do + g → dog      6 次
在这四次合并之后:
cats → [cat, s]
dogs → [dog, s]
这是一个完整指定、可以复算的教学 tokenizer,不是某个真实 LLM 的切分结果。它恰好得到了类似词干和词尾的片段,但 BPE 的合并依据是频率,并没有一条规则要求它识别语法上的词根或词缀。基础字符是否完整、空格怎样处理、是否采用 byte-level 表示,都会改变真实 tokenizer 的行为。1
这里还没有产生词向量。我们只是决定:接下来模型看到哪些离散单位。
为了接着解释经典词向量,下面暂时回到整词切分,并使用前几篇的小词表:
I → 0     like → 1     cats → 2     dogs → 3     pizza → 4

I like cats → [0, 1, 2]
这是一份另行声明的整词词表,不沿用上面的 BPE 词表。无论选整词还是子词,切分单位确定以后,仍然需要回答同一个问题:这些 ID 怎样进入数值计算?
二、编号与向量:区分身份,不等于描述关系
编号 2 和编号 3 相邻,不代表 cats 与 dogs 的含义接近。只要同步调整词表和对应参数,重新排列编号,不应该改变模型表达同一套计算的能力。
一种直接的表示是 one-hot。对五个候选,cats 对应的行向量为:
它清楚地标识了类别,但任意两个不同类别的 one-hot 向量都正交,欧氏距离都等于平方根 2。这种表示没有预先告诉我们,哪些类别应该共享什么特征。
我们可以增加一张可训练的表。设词表大小为 M,每个表示有 d 个分量:
\[E\in\mathbb R^{M\times d}.\]对 token w,取出其 ID 对应的行,得到行向量 e_w:
\[e_w=E[\operatorname{id}(w),:].\]这里的 embedding,是把一个离散身份映射成一组可供模型使用的数值特征。 在这个具体模型中,映射由查表完成;表里的数可以训练,整数 ID 不需要被求导。PyTorch 的 Embedding 就实现了这种索引查表。3
例如,为了演示而指定:
\[E= \begin{bmatrix} 0.1&0.4\\ 0.3&-0.2\\ 0&0\\ -0.4&0.2\\ 0.2&0.5 \end{bmatrix}.\]输入 [0, 1, 2],就取出前三行,得到形状为 3×2 的矩阵:三个位置,各有一个二维表示。输入里再次出现编号 2,仍然使用同一行参数。
这些分量可以为负,不必相加等于一。Embedding 不是概率分布,也不是候选结果的 logits;它先提供特征,后续计算才可能用这些特征产生预测分数。
查表还可以写成一个矩阵恒等式:
\[e_w=o_wE.\]One-hot 只有一个非零元素,乘法恰好选中 E 的一行。实际实现不需要真的构造那张很大的 one-hot 矩阵。
这也说明 embedding 不是神经网络处理符号的唯一可能方式。One-hot 后接一个可训练线性层,本身就可以实现同样的映射。 我们选择查表和连续向量,是为了组织这种计算,而不是因为符号必须经过某个神秘步骤才能变成数字。
连续向量提供了学习共享特征的空间:一个词可以参与多个特征,一个特征也可以被多个词使用。向量维度不必等于词表大小,后续计算可以在这组特征上复用参数。这正是分布式表示与神经语言模型联合学习的一个动机。4
但上面的表是手工指定的。它能计算,不代表它已经有好的语言结构。从头训练时,我们可以按选定规则随机初始化,再让任务改变这些数值。
Embedding 的存在来自表示方式;embedding 的用途,要由数据和学习目标逐渐建立。
三、向量里的结构,从什么证据中学习?
一个词周围出现过什么,是可以直接从文本中观察到的证据。
继续使用五句话:
I like cats
I like dogs
I like cats
I like pizza
I like cats
限定上下文为左右紧邻的一个词,不跨句子边界。用 C_wc 记录中心词 w 的邻近位置出现上下文词 c 的次数。例如,cats 旁边出现了三次 like,dogs 旁边出现了一次。
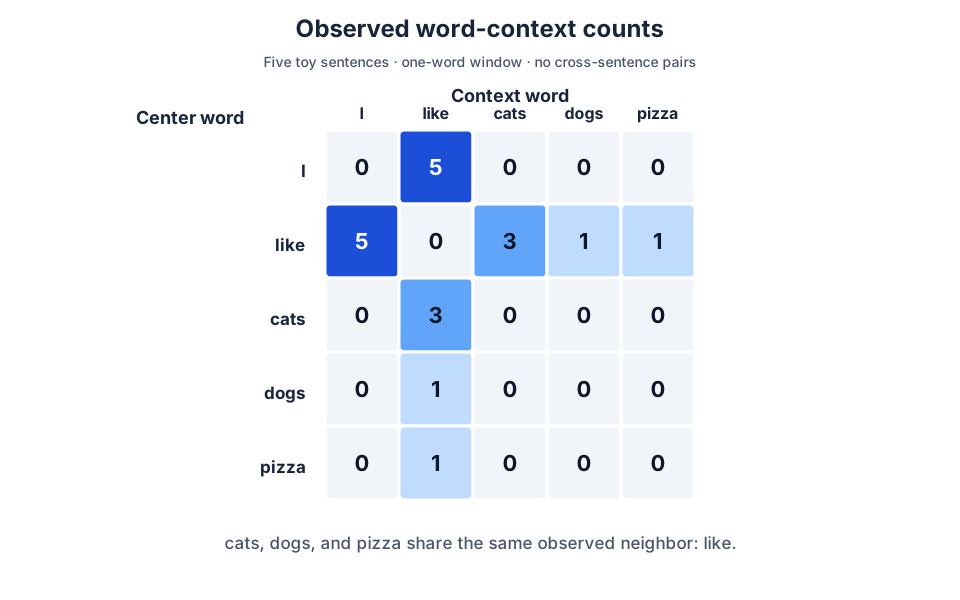
每个格子都是该语料在指定窗口下的计数,不是学习后的相似度。
每一行已经是一种向量表示:坐标对应上下文词,数值对应共现频率。但词表扩大后,这种表示会很宽、很稀疏,也受常见词频率影响。
经典的矩阵方法会对词—文档或词—上下文统计进行加权、变换和降维。例如 LSA 对词—文档矩阵做低秩分解;词—上下文表示也可以先做 PPMI 等变换,再用 SVD 构造低维表示。向量不一定只能通过神经网络得到。5
这个小语料也暴露了统计证据的局限:cats、dogs、pizza 的邻词都只有 like。把各自的共现行归一化,三个上下文分布完全相同。
我们不能因此断言“猫、狗和披萨含义相同”。我们只能说:在这份数据和这个观察窗口下,尚无足够证据把它们区分开。 所谓从上下文学习表示,仍然受数据范围和任务定义约束。
接下来可以换一种方式使用同样的证据:不直接把统计表当表示,而是要求一组向量能够预测这些观察。
四、Word2Vec:为了完成预测,调整向量本身
Word2Vec 的两个代表性结构,改变的是预测方向。对于 I like cats 里的中心词 like,CBOW 根据周围的 I 与 cats 预测中心词;Skip-gram 则以 like 为输入,分别预测窗口内观察到的 I、cats。CBOW 在基本形式中汇总上下文向量,不保留它们的先后次序。6
这里的训练信号不需要人工逐对标注“哪个词与哪个词相似”:文本提供了实际出现的词与邻词。预测邻词也不等于自回归 next-token prediction,因为窗口可以同时包含左右两侧。6
先用完整 Softmax 看清计算
考虑一个 Skip-gram 风格的完整 Softmax 模型。我们准备两张表:输入表 E,为中心词提供 e_w;输出表 U,为每个候选上下文词 j 提供 u_j。两者都有 M 行、d 列,但参数彼此独立。
中心词与候选邻词的分数由点积产生,再对词表归一化:
\[z_j=e_wu_j^\top, \qquad q_j=\frac{\exp(z_j)}{\sum_{k=0}^{M-1}\exp(z_k)}.\]候选编号仍从零到 M−1。如果实际观察到的邻词编号是 c,这一对词产生的损失就是:
\[\ell(w,c)=-\log q_c.\]这正是前三篇的那套结构。不同的是,现在分数直接由两个词向量计算,损失不只训练“怎样使用向量”,也会训练向量本身。完整 Softmax 的 Skip-gram 表述和输入、输出两套词表示,可以在原始工作中找到。7
为什么这种表示不只是换个存储格式?如果为每一对词单独保存一个分数,需要 M² 个数;两张 M×d 的表则用 2Md 个参数,通过点积共同产生这些分数。当 d 远小于 M 时,模型不能再任意独立设置每个词对的分数,而必须在有限的特征里共享结构。这个约束可以帮助学习,但不保证任何一种距离都自动对应语义相似度。
一个词有两套向量,不表示它有两种互斥的含义。它们在模型里承担不同角色:一套作为预测的输入,另一套作为被预测的候选。
真正更新一次 embedding
从语料中取出已观察到的词对:中心词 cats,邻词 like。沿用前面手工指定的输入表,所以起始的 cats 向量是 (0,0)。为隔离这一行怎样学习,暂时固定输出表:
| 候选上下文词 | 输出向量 |
|---|---|
I | (−1, 0) |
like | (1, 0) |
cats | (0, 1) |
dogs | (0, −1) |
pizza | (0, 0) |
起初所有点积都是零,每个候选概率都是 0.2。观察到 like 的损失为:
第三篇推过 Softmax 交叉熵对分数的梯度。再经过这一次点积,把梯度传到输入向量上,得到:
\[\nabla_{e_w}\ell = \sum_{j=0}^{M-1}\bigl(q_j-\mathbf1[j=c]\bigr)u_j.\]指示函数在 j 等于实际邻词 c 时为一,否则为零。在当前例子中,五个输出向量之和为零,因此梯度为 (−1,0)。用学习率 0.5 更新:
\[e_{\mathrm{cats}}^{\mathrm{new}} =(0,0)-0.5(-1,0)=(0.5,0).\]重新计算点积和概率,like 的概率升至约 0.313728,损失降至约 1.159228。
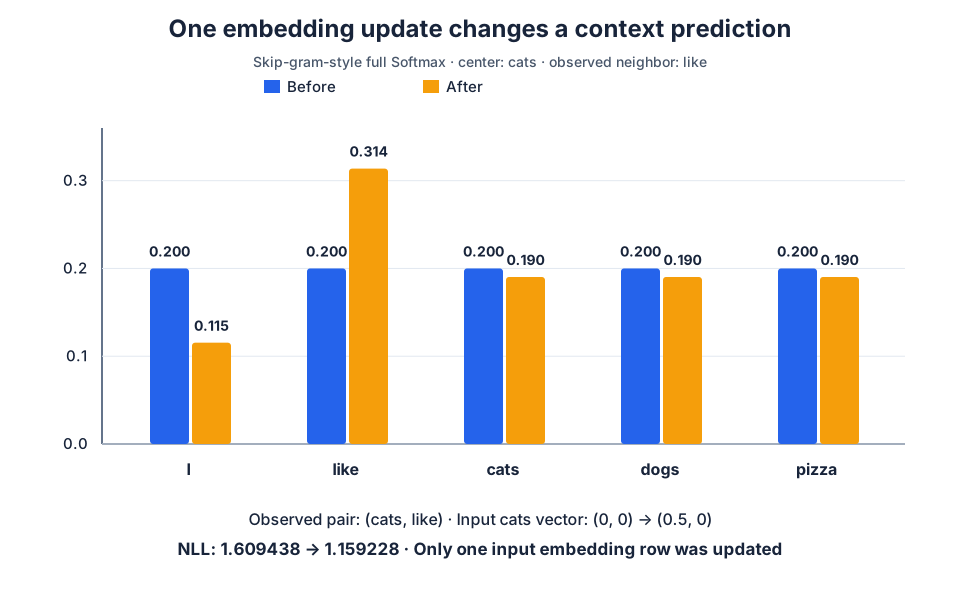
一次明确指定的梯度更新;不是训练好词向量的性能结果,也不是把相似词凭空移动到一起。
我们没有告诉模型“第一维应该表示喜欢”。这次更新只是让一个实际出现的词对在当前模型下更容易被预测。完整训练会处理大量词对,并更新输入和输出两张表;这里固定 U,只是为了把一个步骤看清楚。
这也解释了为什么同一输入行要共享:下次别的句子出现 cats,会查到这行已经被调整过的参数,而不是重新创建一个没有学习过的向量。
有用的几何关系来自训练约束,不是每一个坐标天生对应一种语义。 甚至把输入、输出两套向量同时做同一个正交旋转,所有点积分数仍然不变。单独给“第七维”贴上永久的语义标签,并不是这套计算要求的东西。
实际 Word2Vec 不必每次遍历整个词表
完整 Softmax 便于解释,却需要考虑全部候选。Word2Vec 工作也使用 hierarchical softmax,并引入 negative sampling:让真实词对与从噪声分布采样的词对参与二分类式训练。抽到的负样本不意味着语言学上绝不可能共现。7
Negative sampling 改变了训练目标,不能把它直接说成“完整 Softmax 少算了几个分母项”。 这里先用完整 Softmax 建立理解,再保留这种实现与目标上的区别。7
五、GloVe 与 fastText:改变证据的使用方式,或改变共享的单位
Word2Vec 让我们看到,向量可以通过预测来学习。但预测单个词对,并不是利用共现统计的唯一方式;为每个完整词单独保存一行,也不是唯一的参数组织方法。
GloVe:让向量解释汇总后的共现统计
GloVe 先使用全局汇总的共现计数。仍以 C_ij 表示词 i 与上下文词 j 的共现量,e_i、u_j 表示待学习的两组向量,再引入标量偏置 b_i、c_j,以及非负的计数权重函数 ω。其目标可以在正计数项上写成:
\[J= \sum_{i,j:C_{ij}>0} \omega(C_{ij}) \left(e_iu_j^\top+b_i+c_j-\ln C_{ij}\right)^2.\]这是加权平方误差:让向量点积加上偏置,拟合对数共现计数;权重控制不同计数的影响。它不是把频率表原样保存下来,也不是用交叉熵预测单个邻词。5
两条路线使用了相关的语料证据,但构造目标的方式不同:Skip-gram 把共现变成预测样本,GloVe 直接让一组向量解释汇总统计。没有理由把其中任何一种写成从“语义”出发唯一可能推出的公式。8
fastText:一个词不一定只对应一行独占参数
对于只按完整词查表的模型,cat 和 cats 的输入参数可以完全独立。即使拼写相近,这种关系也没有直接进入参数化。
fastText 的词向量方法为字符 n-gram 学习向量,再组合成词表示。下面只看长度为三的片段,并用 <、> 标记词的边界:
cat  → <ca, cat, at>
cats → <ca, cat, ats, ts>
这些片段有重叠。两个词共享 <ca 和 cat,因此可以共享对应的向量参数。原方法也包含完整词项,并不只使用这里展示的三字符片段。9
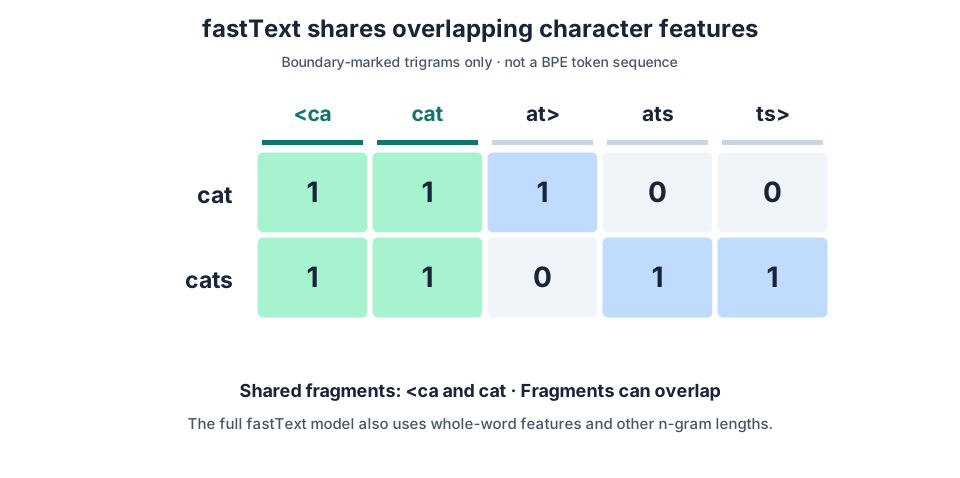
图中 1 表示包含该片段,0 表示不包含;这不是一个 token 序列。只展示三字符片段,省略了完整词项和其他长度。
用 G(w) 表示词 w 采用的片段集合,用 a_g 表示片段 g 的向量,论文中的组合思路可以写成:
\[e_w=\sum_{g\in G(w)}a_g.\]当一个完整词没有在训练中出现,仍可以利用它的字符片段构造向量。这解决的是“怎样为未见词形提供表示”,并不保证任何新词的含义都能从拼写可靠推断。9
fastText 的字符 n-gram 与 BPE 的子词 token,不是在做同一件事。 前者让一个词的表示由多个、可重叠的片段共同组成;后者把输入文本组织成一个有顺序的 token 序列。只有看到“subword”这个名字,很容易把它们混在一起。
Word2Vec、GloVe、fastText 的共同问题是怎样得到有用的词表示;它们对训练证据、目标和共享粒度给出了不同答案。
六、到了 LLM,embedding 又指什么?
这里需要先区分“怎样学会向量”和“使用时怎样取得向量”。
对普通词表查表,在参数不变时,同一个 ID 总是取出同一行。所谓静态词向量中的“静态”,指的就是它不会在每一次使用时根据当前句子重新计算;它在训练期间当然可以变化。
LLM 的输入也可以使用可训练的 token embedding table。词表单位换成子词、字节片段等以后,查表关系仍然是一样的;输入表示可以与语言模型的预测任务一起训练,不需要先单独训练 Word2Vec 才能开始。410
但输入表与模型内部的上下文表示不是同一对象。对两个前缀:
I like
They like
只要 like 对应同一个 token ID,单独查表的结果就相同。经过处理整段前缀的网络以后,它的隐藏表示却可以不同,因为计算现在使用了不同的上下文。
输入 embedding 是参数表中的一行;contextual representation 是模型针对这一次输入计算出来的结果。 后者变化,不意味着推理时必须修改前者的参数。本文先把这段上下文计算保留为待解释的函数,下一篇再打开它。10
另外,语言模型的输出端也需要把隐藏表示变成词表分数。某些模型会把输入表和输出权重绑定:若隐藏行向量 h 与 embedding 宽度相同,并暂时省略偏置,便可以写:
\[z=hE^\top.\]这里输出的是所有候选 token 的分数,不是查出某一行。共享输入、输出权重是一种设计选择,也不是把 embedding lookup 做了一个数学上的逆运算。11
最后,检索系统里的 sentence embedding、document embedding,又是另一层:需要把一段变长文本编码、汇总成固定长度表示,往往还通过相似度相关的训练目标塑造它。它不是在词表里直接查一整句话。Sentence-BERT 就是面向这种句子级表示的一个例子。12
因此,“embedding”这个词至少可能指 token 的输入参数、位置上的上下文表示,或整段文本的检索表示。名称相同,不表示对象相同,也不表示随便取一个向量就适合语义检索。
七、向量有了,顺序在哪里?
还剩下一个没有解决的问题:词序。
先按词切分,比较两句话:
dog bites man
man bites dog
如果把三个词向量直接求和,两句话得到同一个结果,因为加法与排列顺序无关。这里不是向量质量不好,而是选定的汇总计算丢掉了顺序。
把 token 放在矩阵的第几行,与后续运算是否利用这个行号,是两件事。 我们要让计算能接触到“这个 token 出现在什么位置”的线索,而不是指望词向量同时代表它出现在所有句子中的所有位置。
为位置学习一张表
一种方法是为绝对位置另建一张可训练表。设最多为 L 个位置准备参数,每行仍然有 d 个分量:
\[R\in\mathbb R^{L\times d}, \qquad p_i=R[i,:].\]用 x_i 表示第 i 个位置的 token ID,选择将两种表示相加:
\[h_i^{(0)}=E[x_i,:]+p_i.\]同一个 token 出现在不同位置,可以得到不同的输入表示。两张表各管一种身份:E 按 token ID 查,R 按位置查。相加保持了表示宽度;它是具体的模型设计,不是概率论要求的操作。原始 Transformer 也比较过可学习的位置表示和固定的位置编码。10
这种查表方法需要为位置准备参数。未被训练充分的位置,不会仅仅因为表里存在一行就自动具有可靠的用法。
也可以用固定函数生成位置向量
另一种选择是不用学习位置表,而是对位置计算不同频率的正弦和余弦。令 d 为偶数,位置 i 从零开始,r 为从零到 d/2−1 的整数:
\[p_{i,2r} = \sin\left(\frac{i}{10000^{2r/d}}\right),\] \[p_{i,2r+1} = \cos\left(\frac{i}{10000^{2r/d}}\right).\]每一对坐标以同一个频率变化,不同坐标对变化快慢不同。原始 Transformer 使用了这组固定的位置编码;其中的 10000 是设计中的尺度常数,不是从“位置”这个概念必然推出的数字。10
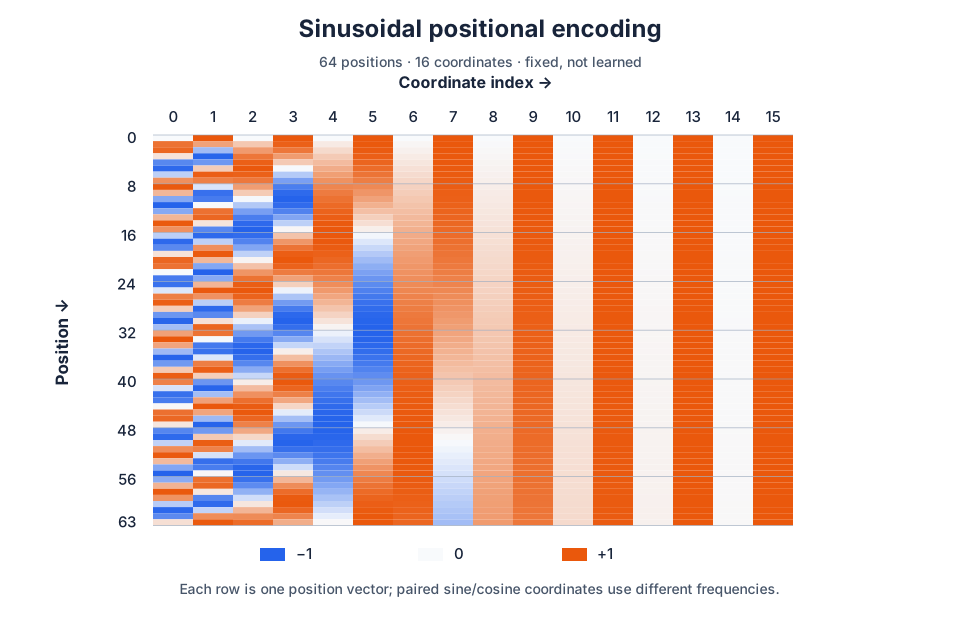
纵轴是 token 位置,横轴是向量坐标。每一行构成一个位置向量;这些数由公式生成,不是训练结果。
相邻位置因而对应有结构的数值变化,而不是任意两个无关 ID。正弦、余弦的角度加法公式还使固定位置偏移具有可表达的线性关系。不过,能为更远的位置计算一个向量,不等于模型一定能在更长文本上可靠工作。公式的定义域与学习后的泛化能力是两个问题。
这里还有一个值得专门检查的误解:加了位置向量,是不是任何汇总方法都会自动知道顺序?
不是。假如我们相加以后立刻对所有位置求和:
\[\sum_i\bigl(E[x_i,:]+p_i\bigr) = \sum_i E[x_i,:]+\sum_i p_i.\]对于长度相同、只是交换 token 顺序的两句话,右边仍然不变。
位置编码提供可以被利用的线索;下游计算还必须在丢掉位置对应关系之前,真正使用这些线索。 这也说明为什么“有词向量”和“有位置向量”,还不足以解释整个语言模型。
位置表示不一定是在输入上做加法
“Positional embedding”与“positional encoding”的命名会有重叠;更有用的是看它是否可训练、描述绝对位置还是相对位置、作用于哪一步计算。
除了位置查表和正弦加法,还有把相对位置纳入位置间匹配的方式。RoPE 通过依赖位置的旋转,把相对位置信息带入后续的匹配计算;ALiBi 则往匹配分数加入与位置距离相关的线性偏置,并不向输入词向量添加一张位置表。1314
这些机制的完整推导需要下一篇的 Attention 计算。此处重要的是边界:不应把所有位置机制都理解成“token embedding 加 positional embedding”。 上面的无序求和例子,也没有证明所有不使用显式位置向量的模型都无法利用顺序。
八、从文本到向量以后,还缺什么?
到这里,一段文本已经可以变成一个 T×d 的数值矩阵:T 是当前 tokenizer 产生的 token 数量,d 是表示宽度。每一行有明确来源;参数表中的数值可以被损失调整;模型还可以选择怎样提供位置线索。
但再看 I like 与 They like。如果 like 仍然使用同一个 ID,并处在同一位置,那么仅凭 token lookup 与绝对位置相加,它的输入表示依旧相同。
它还没有通过这两步计算读取前面的 I 或 They。
Embedding 让离散符号成为能够学习和计算的表示,但它本身并没有完成当前位置与上下文的交互。 下一篇要解释的,就是怎样让一个位置根据当前需要,从其他位置读取信息,并把读到的内容写入自己的表示。
文中图表是根据明确设定复算的教学示例,并非预训练词向量或实验结果。复算源码。
-
Hugging Face, Tokenization algorithms. Tokenization 的算法分类、词表与 byte-level 的区别。 ↩ ↩2
-
Rico Sennrich, Barry Haddow, and Alexandra Birch. Neural Machine Translation of Rare Words with Subword Units, ACL 2016, §3.2. 本文的小语料与四次合并为独立指定并复算的教学例子。 ↩
-
PyTorch, torch.nn.Embedding. 本文的 one-hot 等价关系由矩阵乘法直接得到。 ↩
-
Yoshua Bengio, Réjean Ducharme, Pascal Vincent, and Christian Jauvin. A Neural Probabilistic Language Model, JMLR 3:1137–1155, 2003. ↩ ↩2
-
Jeffrey Pennington, Richard Socher, and Christopher Manning. GloVe: Global Vectors for Word Representation, EMNLP 2014, §2–3 and Equation 8. ↩ ↩2
-
Tomas Mikolov, Kai Chen, Greg Corrado, and Jeffrey Dean. Efficient Estimation of Word Representations in Vector Space, 2013, §3 and Figure 1. ↩ ↩2
-
Tomas Mikolov et al. Distributed Representations of Words and Phrases and their Compositionality, NeurIPS 2013, §2. 本文更新固定输出表以隔离输入向量的梯度,不是在复现完整 Word2Vec 训练。 ↩ ↩2 ↩3
-
Stanford NLP, GloVe project. ↩
-
Piotr Bojanowski, Edouard Grave, Armand Joulin, and Tomas Mikolov. Enriching Word Vectors with Subword Information, TACL 5:135–146, 2017, §3.2. 此处讨论词向量方法;图只显示长度为三的字符片段。 ↩ ↩2
-
Ashish Vaswani et al. Attention Is All You Need, NeurIPS 2017, §3.4–3.5. 本文的加法输入示意不复现原论文全部缩放与架构细节。 ↩ ↩2 ↩3 ↩4
-
Ofir Press and Lior Wolf. Using the Output Embedding to Improve Language Models, EACL 2017. ↩
-
Nils Reimers and Iryna Gurevych. Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks, EMNLP-IJCNLP 2019. ↩
-
Jianlin Su et al. RoFormer: Enhanced Transformer with Rotary Position Embedding, 2021; revised 2023. ↩
-
Ofir Press, Noah A. Smith, and Mike Lewis. Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation, 2021; ICLR 2022. ↩