First Principles of LLMs & RL · Article 03 · 上一篇文章
写作说明:问题与初始草稿材料来自作者本人;ChatGPT 协助了结构、编辑、配图和翻译。
从局部近似,到梯度下降与反向传播
上一篇解释了交叉熵怎样衡量模型的预测损失。但得到一个损失值以后,参数并不会自己改变。
一个数字可以告诉我们当前预测有多差,却不会直接附上一份修改说明:哪个参数应该增加,哪个应该减少,又应该改多少?
从“衡量预测”到“调整参数”,还缺少对变化的描述。
这篇文章从这里开始。先看一个很小的参数改动会怎样影响损失,再选择有利的改动方向,最后把这种变化关系一路算回模型的参数。Taylor expansion、gradient descent 和 backpropagation 分别回答这条路上的三个问题。
一、损失值没有方向,导数有
先暂时把复杂网络放在一边。假设只有一个实数参数 θ,损失函数为:
\[L(\theta)=(\theta-3)^2.\]参数等于 1 和等于 5 时,损失都是 4。但要靠近最低点,前者应该增加,后者应该减少。只看到损失值,分不清这两个情况。
导数提供的正是缺少的变化信息:
\[L'(\theta)=2(\theta-3).\]在 θ 等于 1 时,导数是 −4。它不是说损失为负,而是说:在当前位置,把参数稍微增大,损失会下降。
这个解释可以直接从导数定义读出来。用 δ 表示参数的小改动:
\[L'(\theta) = \lim_{\delta\to0} \frac{L(\theta+\delta)-L(\theta)}{\delta}.\]如果 δ 足够小,就可以用导数近似这个变化比率,得到:
\[L(\theta+\delta) \approx L(\theta)+L'(\theta)\delta.\]例如,从 θ 等于 1 出发,增加 0.01。一阶近似预测损失下降约 0.04,变成 3.96;重新计算真实损失,得到 3.9601。
近似并不完全相同,但它正确描述了这次微小改动的效果。
导数不是当前错误的大小,而是损失对参数变化的局部敏感性。 同样大小的损失,可能对应完全不同的敏感性。
二、Taylor:用局部信息构造附近的形状
刚才那条近似就是一阶 Taylor 近似。它用经过当前点、斜率与原函数一致的直线,代替附近的曲线。
这也给出了更高阶展开的出发点:既然直线只能匹配高度和斜率,能不能再匹配函数的弯曲?
用 f 表示一个标量函数,a 表示展开点,δ 表示相对 a 的位移。先构造一个二次多项式:
\[p_2(\delta)=c_0+c_1\delta+c_2\delta^2.\]要求它在 δ 等于零时,与原函数在 a 处具有相同的值、一阶导数和二阶导数。这三个条件分别给出:
\[c_0=f(a),\qquad c_1=f'(a),\qquad 2c_2=f''(a).\]于是:
\[f(a+\delta) \approx f(a)+f'(a)\delta+\frac{f''(a)}{2}\delta^2.\]二分之一没有什么神秘之处:二次项求两次导数会产生系数 2,因此需要先除掉它。继续匹配更高阶导数,就出现相应的阶乘。
更一般地,用 n 表示多项式的最高次数,并把近似误差记为 Rₙ:
\[f(a+\delta) = \sum_{k=0}^{n}\frac{f^{(k)}(a)}{k!}\delta^k +R_n(\delta).\]这里 n 是非负整数,第零阶导数就是函数本身。这个等式保留了余项;只有在说明误差可以忽略时,才把它写成近似。
例如,若 f 在相关区间上具有连续的 n+1 阶导数,而且该导数的绝对值不超过 M,Taylor 定理给出:
\[|R_n(\delta)| \leq \frac{M}{(n+1)!}|\delta|^{n+1}.\]这才说明为什么“离展开点近”有用:在这些条件下,缩小位移能控制误差。有限阶近似也不意味着,任意光滑函数都等于它的无穷 Taylor 级数。1
Taylor 的核心不是把复杂公式变长,而是用一个点上的导数,构造附近的简单模型。
为了看出这个“附近”,考虑在零点展开指数函数:
\[e^x\approx1+x+\frac{x^2}{2}.\]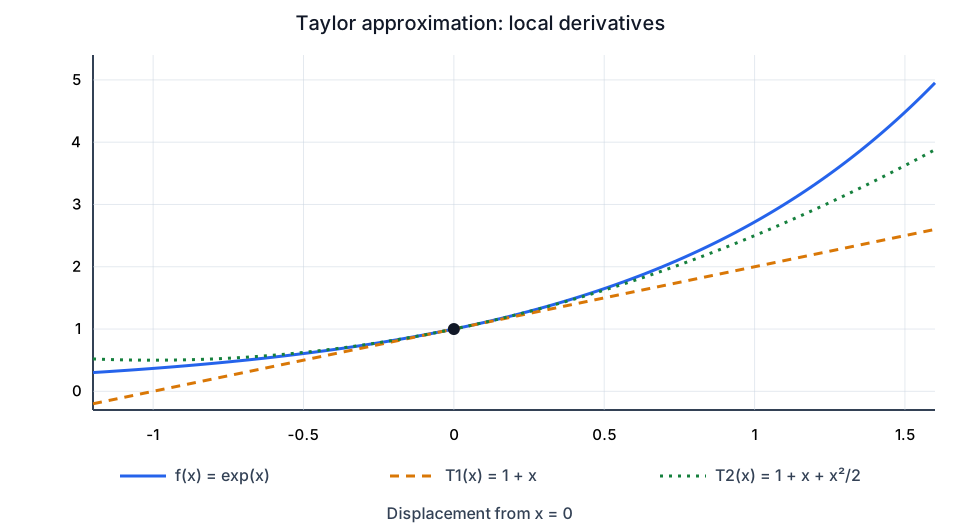
三条曲线在展开点具有匹配的局部信息,但不是同一条函数。横轴表示离展开点的位移。
当 x 等于 0.2 时,一阶近似为 1.2,二阶近似为 1.22,真实值约为 1.2214。把 x 移到 1,一阶和二阶近似分别给出 2 和 2.5,而真实值约为 2.7183。
这里专门用了非二次函数。如果画的是抛物线,二阶展开已经精确恢复整个函数,反而看不见一般的近似误差。
现在可以回到学习问题了:如果局部近似能预测一个小改动的效果,我们应该选择怎样的改动?
三、为什么沿负梯度走,还需要控制步长?
真实模型不止一个参数。用粗体 θ 表示 m 个实数参数组成的向量,并暂时固定训练数据、随机性和当前计算,使损失成为这个参数向量的确定函数。
把损失对每个参数的偏导数组合起来,就得到梯度:
\[g=\nabla L(\boldsymbol\theta) = \begin{bmatrix} \frac{\partial L}{\partial\theta_1}\\ \vdots\\ \frac{\partial L}{\partial\theta_m} \end{bmatrix}.\]在当前位置可微时,多变量的一阶近似为:
\[L(\boldsymbol\theta+\Delta\boldsymbol\theta) -L(\boldsymbol\theta) \approx g^\top\Delta\boldsymbol\theta.\]右边是内积:每个参数的改动乘以它对应的敏感性,再把贡献相加。梯度因此不只是几个互不相关的偏导数;它能评价一整个小的参数改动。
但要说哪个方向“下降最快”,必须先公平地比较方向。这里用欧氏长度衡量步长,并用 u 表示单位方向。根据 Cauchy–Schwarz 不等式:
\[g^\top u\geq-\|g\|_2, \qquad \|u\|_2=1.\]当梯度不为零时,等号在下面的方向取到:
\[u_*=-\frac{g}{\|g\|_2}.\]所以,在欧氏长度相同的微小改动中,负梯度方向给出最大的瞬时下降率。 “最陡”依赖于怎样度量步长,并不是一个脱离坐标尺度的绝对说法。2
最简单的梯度下降使用一个正的学习率 η,直接缩放负梯度:
\[\boldsymbol\theta_{t+1} = \boldsymbol\theta_t-\eta\nabla L(\boldsymbol\theta_t).\]把这个改动放回一阶近似:
\[L(\boldsymbol\theta-\eta g)-L(\boldsymbol\theta) \approx -\eta\|g\|_2^2.\]梯度非零时,右边为负。这解释了更新方向,却没有替我们选好 η:近似是在当前位置建立的,不保证很远的地方仍然适用。
梯度告诉我们小步往哪里走,学习率决定这一次实际走多远。
回到前面的抛物线,从 θ 等于 1 出发。导数为 −4,因此下一步的位置是:
\[\theta_{\mathrm{new}}=1+4\eta.\]| 学习率 η | 新参数 | 新损失 | 与原损失 4 比较 |
|---|---|---|---|
| 0.10 | 1.4 | 2.56 | 下降 |
| 0.75 | 4.0 | 1.00 | 越过最低点,但仍然下降 |
| 1.00 | 5.0 | 4.00 | 没有改善 |
| 1.10 | 5.4 | 5.76 | 反而上升 |
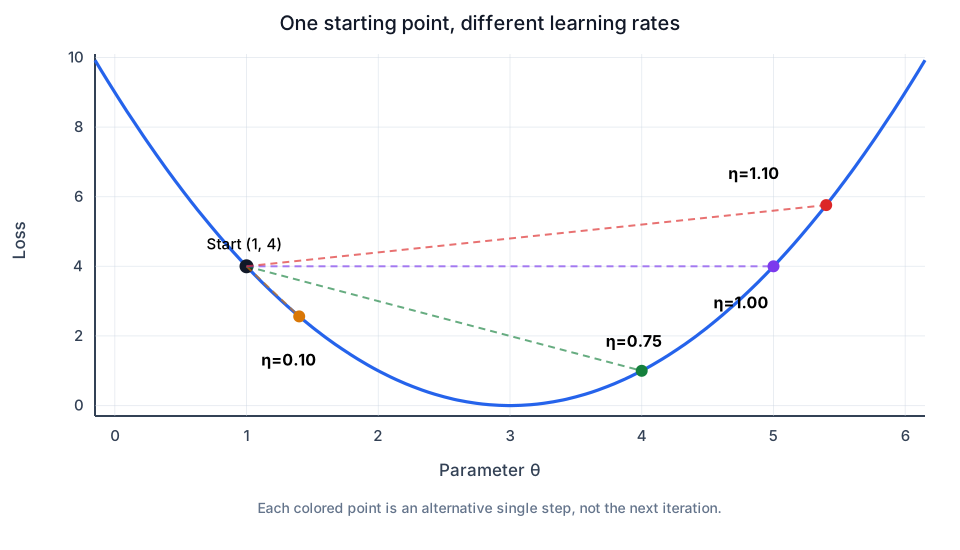
箭头比较的是从同一起点出发的不同选择,不是同一次训练中的连续迭代,也不是参数在更新过程中真实经过的曲线。
甚至不用画图,也可以看出这个例子的收敛条件。每次更新以后,到最优参数 3 的误差满足:
\[\theta_{t+1}-3=(1-2\eta)(\theta_t-3).\]因此,对这个特定的二次函数,固定学习率位于 0 和 1 之间时,误差逐渐缩小;学习率为 1 时,非最优起点会来回振荡;大于 1 时,误差的绝对值会增长。这个数值范围依赖当前函数,不能当成神经网络的通用学习率规则。
局部与全局的区别也在这里。对于可微函数,只要当前梯度非零,就存在足够小的负梯度步能够降低损失。但这并不保证整个迭代收敛,更不保证找到全局最优点。梯度为零也可能对应局部最大值或鞍点。2
凸性能够提供额外的全局结构:在无约束的可微凸问题中,若找到了梯度为零的点,它就是全局最优点;算法能否到达它,还需要适当的条件。不能把一般梯度下降概括成“至少保证局部最优”。
到目前为止,我们一直假设梯度已经在手里。接下来的问题才是神经网络真正需要面对的:参数没有直接产生损失,中间隔着许多计算,这些偏导数怎样得到?
四、反向传播:沿计算关系传递敏感性
设一个参数先经过函数 φ,产生中间量 u,u 再经过函数 f,得到损失:
\[u=\phi(\theta),\qquad L=f(u).\]参数稍微改变,先引起 u 的变化,再引起损失的变化:
\[\Delta u\approx \phi'(\theta)\Delta\theta, \qquad \Delta L\approx f'(u)\Delta u.\]把两步合起来,取极限,就得到微积分的链式法则:
\[\frac{dL}{d\theta} = \frac{dL}{du}\frac{du}{d\theta}.\]同一条计算路径上的敏感性相乘,是因为前一步造成的变化,又被后一步继续放大、缩小或反转。
这里的 chain rule 和第一篇的概率链式法则不是同一个公式。前者处理复合函数的导数,后者分解联合概率;它们都能分步计算,但不能混为一谈。
如果参数通过多条中间路径影响损失,就不能只挑一条。每条路径都贡献一部分,汇合时需要相加。
反向传播把这些关系组织在计算图上。前向计算得到各个中间值;随后从最终损失开始,按相反的依赖顺序计算敏感性。某个节点通往损失的导数一旦算好,就可以供它更前面的多个输入复用,不必从每个参数出发重复计算整条路径。3
它也不是把每个参数稍微动一下,重新跑一次网络来估计导数。那是有限差分,可以用来检查一个小例子,但不是这里的反向计算方式。我们用的是每个运算的导数规则,再通过链式法则组合它们。
Backpropagation 负责算梯度;optimizer 负责利用梯度更新参数。 算完梯度之后,参数仍然可以停在原地。
这时最值得做的,不是再增加一个抽象符号,而是让它实际改变前两篇的那个模型。
五、让 cats / dogs / pizza 真正更新一次
仍然考虑同一个上下文 I like。五次观测给出的经验分布是:
三个结果的顺序是 cats、dogs、pizza。模型输出 logits z,使用温度为 1 的 Softmax,得到:
把 P 固定,并使用自然对数,平均负对数损失为:
\[\ell(z)=-\sum_{k=1}^{3}P_k\log Q_k.\]这里用 ℓ 表示把 logits 直接当作输入的损失函数。使用平均损失而不是五次观测的总和很重要:总损失和总梯度都会是这里的五倍;如果学习率不变,更新幅度也会改变。
先求损失对 logits 的导数。利用 Softmax 的定义和目标概率之和为一,可以把同一个损失改写成:
\[\ell(z) = \log\left(\sum_{j=1}^{3}e^{z_j}\right) -\sum_{j=1}^{3}P_jz_j.\]第一项对 zₖ 的偏导数,正好是模型概率 Qₖ;第二项的偏导数是 −Pₖ。因此:
\[\boxed{ \frac{\partial\ell}{\partial z_k}=Q_k-P_k }\]这个结果是在上述 Softmax、自然对数和固定目标的设定下推出来的,并不是任何损失函数都具有的形式。
沿用前两篇的 logits:
\[z=(0,1,2).\]于是模型概率和梯度分别约为:
\[Q\approx(0.090031,0.244728,0.665241),\] \[\nabla_z\ell\approx(-0.509969,0.044728,0.465241).\]如果三个 logits 可以独立调整,负梯度更新会增加 cats 的分数,降低另外两个分数。原来那句“给实际数据更合适的概率”,终于对应到了具体的变化方向。
但网络通常修改的是共享参数,而不是给每一个上下文独立保存的 logits。为了让这一步也能手算,构造一个只有一个可训练参数的模型:
\[z(\theta)=(2\theta,\theta+1,2).\]这是一个专门用来说明共享计算的模型,不是对真实语言模型架构的描述。它的表示能力很有限。初始参数取零时,恰好得到前面的那组 logits。
参数 θ 同时影响 cats 和 dogs 两个分数。定义参数层面的损失:
链式法则要求我们把各条路径的贡献相加:
\[\frac{dL}{d\theta} = \sum_{k=1}^{3} \frac{\partial\ell}{\partial z_k} \frac{dz_k}{d\theta}.\]在 θ 等于零时:
\[\begin{aligned} \frac{dL}{d\theta} &=2(-0.509969\ldots) +1(0.044728\ldots) +0(0.465241\ldots)\\ &\approx-0.975210. \end{aligned}\]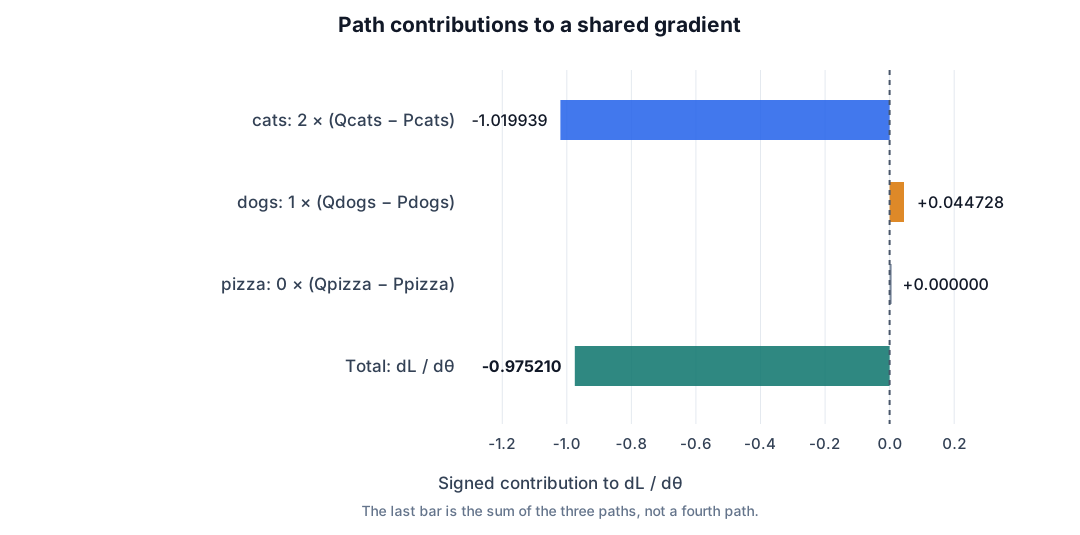
三条路径的贡献有不同的符号。底部是它们的和,不是第四条路径。pizza 的 logit 不依赖 θ,因此这条路径的局部导数为零。
这就是“沿路径相乘、在汇合处相加”的具体样子。cats 那条路径要求参数增加,dogs 那条路径要求参数减少,最终方向由加总后的局部敏感性决定。
现在采用学习率 0.5,做一次梯度下降:
\[\theta_{\mathrm{new}} =0-0.5(-0.975210\ldots) \approx0.487605.\]重新计算 logits、概率和损失,得到:
| 量 | 更新前 | 更新后 |
|---|---|---|
| θ | 0.000000 | 0.487605 |
cats logit | 0.000000 | 0.975210 |
dogs logit | 1.000000 | 1.487605 |
pizza logit | 2.000000 | 2.000000 |
cats 概率 | 0.090031 | 0.183291 |
dogs 概率 | 0.244728 | 0.305965 |
pizza 概率 | 0.665241 | 0.510743 |
| 平均 NLL | 1.807606 | 1.389241 |
这里的结果有个值得停一下的细节:dogs 原来的概率已经高于目标 0.2,更新后却进一步上升了。
这并不与梯度计算矛盾。我们改变的是同时影响多个分数的一个共享参数,不能把每个候选的概率当作独立旋钮。损失考虑的是各结果按 P 加权后的总 log-loss,并不是分别最小化每个概率与目标之间的绝对误差。这次更新降低了前一种目标,却没有让每个概率都同时靠近目标。
而且,虽然 pizza 的 logit 没变,它的概率仍然变了,因为 Softmax 的归一化分母依赖所有分数。
参数更新可以让总损失下降,却不保证每个结果的概率都在同一步里更接近目标。
以上都是从给定公式复算的一步教学计算,不是训练实验的性能结果。
六、把求导与更新分开写进代码
这个小模型可以直接写成带类型标注的 PyTorch 代码:
import torch


def toy_logits(theta: torch.Tensor) -> torch.Tensor:
    """Map a scalar parameter to three shared logits."""
    return torch.stack((2.0 * theta, theta + 1.0, theta.new_tensor(2.0)))


def toy_loss(theta: torch.Tensor, target: torch.Tensor) -> torch.Tensor:
    """Return the average natural-log loss for a fixed target distribution."""
    log_probs = toy_logits(theta).log_softmax(dim=-1)
    return -(target * log_probs).sum()


target: torch.Tensor = torch.tensor([0.6, 0.2, 0.2], dtype=torch.float64)
theta: torch.Tensor = torch.tensor(0.0, dtype=torch.float64, requires_grad=True)
learning_rate: float = 0.5

loss_before = toy_loss(theta, target)
loss_before.backward()  # Compute gradients; theta is still zero.

if theta.grad is None:
    raise RuntimeError("The parameter gradient was not computed.")

with torch.no_grad():
    theta -= learning_rate * theta.grad  # Perform the parameter update.

theta.grad = None  # Do not accumulate this step's gradient into the next one.
loss_after = toy_loss(theta, target)

print(f"{loss_before.item():.6f} -> {loss_after.item():.6f}")
本次计算的输出是:
1.807606 -> 1.389241
backward() 沿计算图计算梯度并累积到叶子张量的 .grad,不会替我们完成这里的参数更新。更新被放进 no_grad() 中,然后重新前向计算,才得到新参数对应的损失。下一次求导前还需要清理不打算继续累积的梯度。4
有些地方使用了近似,有些地方没有。Taylor 用局部多项式近似有限步长的函数变化;上面光滑计算图中的反向传播,则按导数规则计算当前点的梯度,并不是用切线粗略猜每个偏导数。实际浮点运算当然仍有数值误差。3
训练到这里才真正形成一个循环:前向计算给出损失,反向传播给出敏感性,更新规则改变参数,然后在新的位置重新计算。
我们没有因此获得一张通往最优模型的完整地图。我们得到的是一个可以反复执行的局部过程。
前两篇解释了输出分布怎样表示、损失怎样定义;这一篇让损失通过计算关系影响了参数。但例子中,从上下文到 logits 的那部分仍然被压得很小。
下一篇要打开的正是这个部分:当前 token 怎样从前文取出有用的信息,并让这种取用方式也能被同一个损失训练?
-
OpenStax, Calculus Volume 2, Taylor and Maclaurin Series. Taylor 多项式、余项与级数收敛的条件是不同层次的问题。 ↩
-
Ian Goodfellow, Yoshua Bengio, and Aaron Courville, Deep Learning, Chapter 4: Numerical Computation, Section 4.3. 本文的抛物线数值和固定步长结论由给定函数直接计算。 ↩ ↩2
-
Atilim Gunes Baydin, Barak A. Pearlmutter, Alexey Andreyevich Radul, and Jeffrey Mark Siskind, Automatic Differentiation in Machine Learning: a Survey, JMLR 18(153):1–43, 2018. 另见 PyTorch 的 Autograd mechanics;本文只推导光滑运算,未展开不可微点处的约定。 ↩ ↩2
-
PyTorch 官方文档,torch.autograd.backward 与 Autograd mechanics。 ↩