为什么 −log p 一再出现?
First Principles of LLMs & RL · Article 02 · 上一篇文章
写作说明:本文的想法和初始草稿材料来自我本人;ChatGPT 协助了结构整理、文字编辑与翻译。
从 Surprisal 到 Entropy、Cross-Entropy 与 KL Divergence
上一篇文章从观测出发,经过 logits、Softmax 和概率链式法则,最后得到语言模型训练中常见的一个损失项:
\[-\log Q(y).\]这里的 Q 是模型给出的概率分布,y 是实际观察到的 token。模型越不看好这个结果,损失就越大。
但是,负对数不只出现在 Maximum Likelihood 里。信息论用它描述一次事件携带的信息;对它求期望,就得到 Entropy;如果负责产生数据和负责预测数据的是两个不同的分布,就得到 Cross-Entropy;再减去一个基准量,便出现 KL Divergence。
这些表达式为什么有如此相似的形式?答案可以从一个很朴素的要求开始:如果两件事接连发生,我们希望能够把它们带来的信息量组合起来。
1. 为什么一次事件的信息量是负对数?
假设有两种结果。一种发生的概率是 0.99,另一种是 0.01。前一种真的发生时,我们通常不会惊讶;后一种发生时,情况就不同了。
因此,如果用概率来定义一次事件的信息量,至少希望概率越小,信息量越大;必然事件的信息量为零。
还有一个更具体的要求。假设先发生事件 A,随后在 A 已经发生的条件下观察到 B。上一篇的条件概率公式告诉我们:
\[P(A\cap B)=P(A)P(B\mid A).\]如果想让整个结果的信息量等于两步获得的信息量之和,我们需要一个函数,把右边的乘法变成加法。对数恰好具有这个性质:
\[-\log P(A\cap B) =-\log P(A)-\log P(B\mid A).\]这里没有假设 A 和 B 独立。只有当它们独立时,第二项才能进一步写成事件 B 的无条件信息量。
更一般地,如果要求一个连续的信息量函数满足:
\[I(pq)=I(p)+I(q),\]并且随着概率增加而严格减小,那么它的形式只能是负对数乘上一个正常数。选择自然对数并把比例常数设为 1,就得到 surprisal(自信息量):
\[I_P(x)=-\log P(x),\qquad P(x)>0.\]下标 P 提醒我们:同一个结果的 surprisal,取决于用哪个分布衡量它。如果使用以 2 为底的对数,单位是 bit;使用自然对数,单位是 nat(natural unit of information,自然信息单位)。bit 和 nat 测量的是同一种信息量,只是使用不同的对数刻度。1
例如,一个概率恰好为 1/e 的事件发生时,它的自信息量是:
\[-\ln(e^{-1})=1\ \text{nat}.\]换成以 2 为底的对数,可以得到换算关系:
\[1\ \text{nat}=\frac{1}{\ln2}\ \text{bits}\approx1.4427\ \text{bits}.\] \[1\ \text{bit}=\ln2\ \text{nats}\approx0.6931\ \text{nats}.\]一枚公平硬币的正反面各有一半概率,所以一次结果带来 1 bit,也就是约 0.6931 nats 的信息。选择哪种单位不会改变哪个结果更令人意外;它改变的是数值刻度,而不是分布本身。
对于分配了零概率的结果,surprisal 按极限视为无穷大。
这不是在声称大自然规定信息一定要用对数衡量。对数的形式来自我们希望信息量具有的性质,尤其是概率相乘时信息量能够相加。
2. 为什么 Entropy 是 Expected Surprise,而不是总和?
Entropy 衡量的是:已知各个结果的概率以后,对“下一次究竟会发生哪个结果”,还剩多少不确定性。数值上,它等于结果揭晓时带来的平均自信息量。2
这里“已知概率”很重要。即使完全知道一枚公平硬币的正反面概率,我们仍然不知道下一次的结果。这种结果层面的不确定性,并不等于不知道硬币的概率,也不自动等于模型缺乏知识。
如果一种结果几乎必然发生,大多数时候,揭晓答案并不会提供多少新信息;如果几个结果都很有可能,揭晓答案就平均提供更多信息。先把握这个区别,再回来看为什么公式里需要 expectation。
继续使用上一篇的小语料。我们只观察 I like 后面的一个 token,共得到五次结果:三次 cats、一次 dogs、一次 pizza。它们给出的经验分布记为 P:
这里 P 只是为解释而使用的经验分布,并不代表我们已经知道语言真正的生成分布。由于五次观测有同一个上下文,我们暂时省略条件记号。
假如观察到 cats,按照 P 计算的信息量是:
如果观察到 dogs,则是:
同一个系统产生的不同结果,可以有不同的 surprisal。一次观测的信息量是一个取决于实际结果的量;在观察之前,我们还不知道它会取什么值。
如果想描述这个分布整体有多不确定,我们可以问:按 P 重复抽取结果,平均每次会有多少 surprisal?这就需要 expectation:
\[\begin{aligned} H(P)&=\mathbb E_{X\sim P}[-\log P(X)]\\ &=-\sum_x P(x)\log P(x). \end{aligned}\]对于刚才的三个结果:
\[H(P)=-0.6\log0.6-2(0.2\log0.2) \approx0.950\ \text{nats}.\]这里如果某个结果的概率为零,对应的熵求和项按极限取为零。这个数既不等于 cats 发生时的 0.511,也不等于 dogs 发生时的 1.609。它是对所有可能结果按发生概率加权后的平均。
一个两结果的例子可以把这个直觉画出来。令分布随 p 变化:
\[P_p=(p,1-p),\qquad 0\leq p\leq1.\]它的熵就是:
\[H(P_p)=-p\ln p-(1-p)\ln(1-p).\]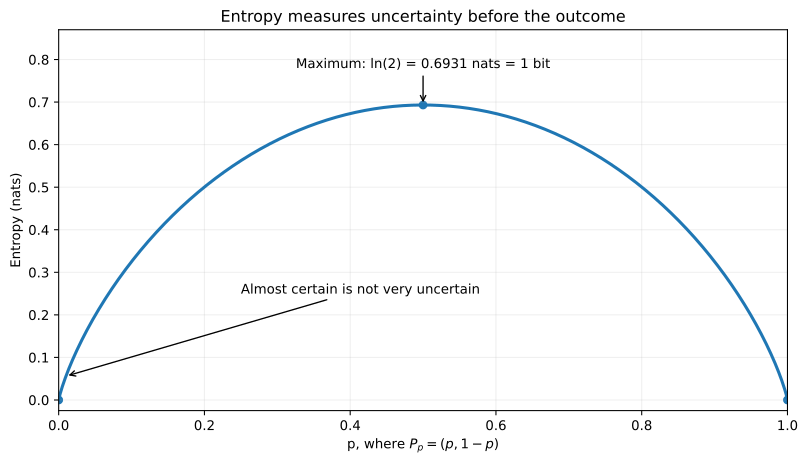
横轴改变的是分布参数 p,不是某一次观测;纵轴是该分布的熵。端点的求和项按 0 log 0 = 0 的极限约定处理。最大值为 ln 2,约 0.6931 nats,也就是 1 bit。
例如,正反面概率为 0.99 和 0.01 时,罕见一面出现的自信息量约为 4.605 nats,但整个分布的熵只有约 0.056 nats:那个很令人意外的结果也确实很少出现。一次罕见结果可以带来大量信息,同时整个分布的平均不确定性仍然很低。
为什么不直接把每个结果的信息量加起来?因为那样会把极少出现的结果与经常出现的结果等量计入,并且不能回答 “一次典型观测平均带来多少信息”。至于连续观察 n 次所得的总信息量,那是另一个问题:如果观测之间相关,需要相加的是每一步给定此前结果的条件 surprisal;不能不加区分地相加各自的边缘 surprisal。若这些观测独立同分布,样本平均在适当条件下会随着样本数量增加而趋近分布的 Entropy。
这也澄清了一个常见混淆:Expected Surprise 不等于每次实际发生的 Surprise。 这是在区分两个层次,并不是说它们的数值永远不能相同:对于等概率分布,每个可能结果的 surprisal 都恰好等于 Entropy。Entropy 是分布层面的量,surprisal 是具体结果层面的量。给定有限样本时,我们可以计算经验 Entropy,但它也不必等于未知真实分布的 Entropy。
那么,物理学里的熵呢?统计物理中,对离散微观状态分布的 Gibbs entropy 也有负对数期望的结构:
\[S=-k_B\sum_i p_i\log p_i.\]这里的 pᵢ 是系统处于第 i 个微观状态的概率,k_B 是 Boltzmann 常数,单位是 J/K。因此,在同一个离散微观状态分布上,Gibbs entropy 与使用自然对数的信息熵满足:3
\[\frac{S}{k_B}=-\sum_i p_i\ln p_i.\]所以,两微观状态模型的 S/k_B 可以使用刚才相同的二分类熵曲线。曲线形状相同,物理熵 S 则带有 J/K 的单位;不能因此把任意文本分布的 Shannon entropy 直接当成某个物理系统的热力学熵。4
在所有可及微观状态等概率的特殊情形下,设可及状态数为 Ω,它变成 Boltzmann 形式:
\[S=k_B\log\Omega.\]不过,物理熵还涉及微观状态的定义、能量约束和热力学解释。把 Entropy 简单翻译成 “混乱程度”,不足以解释这里为什么需要 expectation。
3. 如果数据来自 P,预测却使用 Q?
Entropy 假设我们用 P 自己的概率评价由 P 产生的结果。但实际训练语言模型时,我们不知道真实的分布,只能让模型给出一个近似分布 Q。
为了让两个对象的区别变得具体,继续用开头的三个结果。设模型 logits 为:
\[z=(0,1,2).\]经过 Softmax,模型分布是:
\[Q\approx(0.0900,\ 0.2447,\ 0.6652).\]| 结果 | 经验分布 P | 模型分布 Q | 观测到该结果时的模型损失 |
|---|---|---|---|
cats | 0.6000 | 0.0900 | 2.408 |
dogs | 0.2000 | 0.2447 | 1.408 |
pizza | 0.2000 | 0.6652 | 0.408 |
模型没有违反概率公理:三个 Q 值都是合法概率。但它把最多出现的 cats 看得最不可能,反而认为 pizza 最可能。
如果结果仍然按照 P 出现,却使用 Q 来预测,我们平均会承担多少负对数损失?
\[\boxed{\begin{aligned} H(P,Q)&=\mathbb E_{X\sim P}[-\log Q(X)]\\ &=-\sum_x P(x)\log Q(x) \end{aligned}}\]这就是 Cross-Entropy(交叉熵)。两个分布在同一个期望里承担不同角色:P 决定哪些结果出现得频繁,Q 决定模型对这些结果付出多大损失。
在这个例子中:
\[\begin{aligned} H(P,Q)&=-0.6\log0.0900-0.2\log0.2447\\ &\quad-0.2\log0.6652\\ &\approx1.808\ \text{nats}. \end{aligned}\]这里使用了四舍五入的概率;更精确的结果是约 1.8076 nats。可以把这个期望拆成三项,各自对应一个结果:
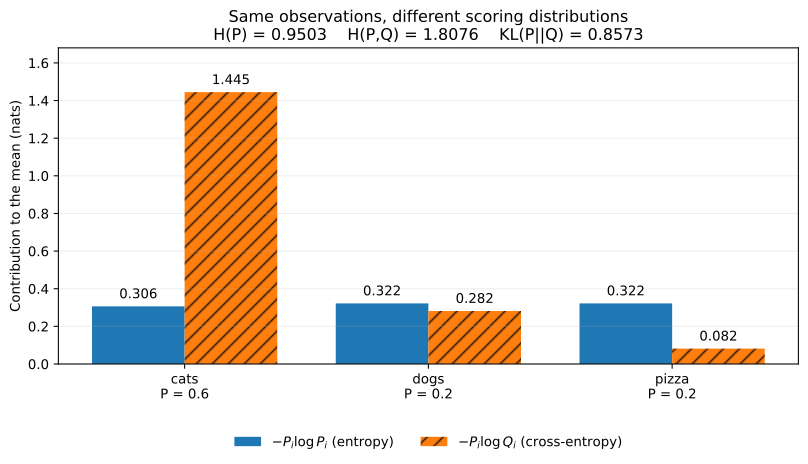
每根柱子表示该结果对平均值的贡献,不是单次 surprisal。熵的三项相加约为 0.9503 nats;交叉熵的三项相加约为 1.8076 nats。两组计算都按照 P 加权,只有对数内部的分布不同。
五次观测的总 NLL 就约为:
\[5H(P,Q)\approx9.038.\]这与上一篇直接把五次 token 的 NLL 加起来完全是同一件事。因为 P 是这五次观测构造出的经验分布,经验 Cross-Entropy 正好是平均 NLL。
那么多分类 Cross-Entropy 还等于 NLL 吗?对于 one-hot 标签,仍然等于。 如果真实标签是第 y 类,则:
\[-\sum_{k=1}^{K}\mathbf 1[k=y]\log Q(k) =-\log Q(y).\]如果目标是一个完整的 soft distribution,Cross-Entropy 则是该分布下的 expected NLL,而不再只是一个类别对应的单项。
这里可以把 cross 理解为:取样和评价由两个分布分别负责,它们可以不同,也可以恰好相同。它不是条件熵的另一种写法:条件熵涉及两个随机变量及其联合分布,例如在已知上下文时,一个 token 还有多少不确定性。H (P,Q) 中的两个参数是分布;条件熵中的两个对象是随机变量。
4. KL Divergence:预测时多付出的那部分损失
对于相同的观测分布 P,我们现在有两种平均损失。用 P 自己预测,得到 Entropy;用模型 Q 预测,得到 Cross-Entropy。两者之差是:
\[\begin{aligned} H(P,Q)-H(P) &=-\sum_xP(x)\log Q(x) +\sum_xP(x)\log P(x)\\ &=\sum_xP(x)\log\frac{P(x)}{Q(x)}. \end{aligned}\]右边就是 KL Divergence:
\[\boxed{ D_{\mathrm{KL}}(P\|Q) =\mathbb E_{X\sim P}\left[\log\frac{P(X)}{Q(X)}\right] }\]因此:
\[\boxed{H(P,Q)=H(P)+D_{\mathrm{KL}}(P\|Q).}\]用刚才同一对分布计算:
\[\begin{aligned} H(P)&\approx0.9503,\\ H(P,Q)&\approx1.8076,\\ D_{\mathrm{KL}}(P\|Q)&\approx0.8573. \end{aligned}\]KL 是使用 Q 而不是 P 来预测 P 的数据时,额外付出的 expected log-loss。 它不是由 “模型误差应该用 KL 来衡量” 这个要求凭空规定出来的:我们先选择了 log-loss,KL 才作为超出最优平均 log-loss 的差值出现。用其他损失函数,也可以得到其他不匹配指标。
图中某一个结果对交叉熵的贡献可以比对熵的贡献小。例如,模型过度看好 pizza 时,观察到 pizza 的那一次损失会较低。KL 非负说的是所有结果按 P 加权后的总差值,不是每个结果的差值都非负。
还可以把 P 固定为原来的三类经验分布,再沿着一组可调模型画曲线。为了得到明确的一维横轴,这次只让 cats 的模型概率 q 变化,并把剩余质量均分给 dogs 和 pizza:
\[\begin{aligned} P&=(0.6,0.2,0.2),\\ Q_q&=\left(q,\frac{1-q}{2},\frac{1-q}{2}\right),\quad 0<q<1. \end{aligned}\]这是为可视化新选的一族模型分布,不是说前面 logits 为 (0,1,2) 的固定 Q 也满足后两类等概率。
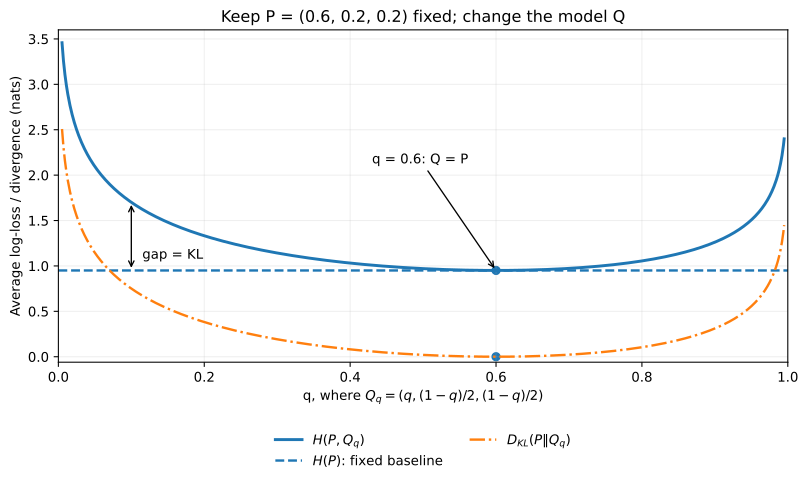
当 q = 0.6 时,Qq = P,交叉熵降到 H(P),KL 为零。P 保持不变,所以 H(P) 是水平基线。这张图上的 gap 是竖直差值,不是曲线之间的面积。
为什么这部分损失不会是负数?假设在有限结果空间里 P 和 Q 都严格为正。利用任意正数 u 都满足的不等式:
\[-\log u\geq1-u,\]我们得到:
\[\begin{aligned} D_{\mathrm{KL}}(P\|Q) &=\sum_xP(x)\left[-\log\frac{Q(x)}{P(x)}\right]\\ &\geq\sum_x(P(x)-Q(x))=0. \end{aligned}\]只有 P 与 Q 相同时,KL 才等于零。这个结论的含义很具体:如果真实结果按照 P 出现,那么从长期平均的 log-loss 来看,使用 P 自己预测不会比使用别的分布更差。
但 KL 有一个与通常意义上的距离不同的性质:它有方向,一般并不对称。
\[D_{\mathrm{KL}}(P\|Q)\ne D_{\mathrm{KL}}(Q\|P)\quad\text{(in general)}.\]对同样的两个分布,反过来计算得到:
\[D_{\mathrm{KL}}(Q\|P)\approx0.6781,\]而正向是约 0.8573。区别并不来自计算技巧,而是谁负责加权:正向 KL 按 P 可能产生的结果计算平均,反向 KL 按 Q 可能产生的结果计算平均。严格地说,交换方向时,对数里的概率比也同时取了倒数;不只是把同一个被平均量换一组权重。
一个极端情况能看清方向的重要性。如果 P 认为某个结果可能发生,而 Q 为它分配严格为零的概率,那么正向 KL 是无穷大;反过来却不一定。有限 logits 的 Softmax 不会产生精确的零概率,但可以给出非常小的概率,因此同样会遇到很大的惩罚。
延伸:mode-covering 与 mode-seeking 到底是什么意思?
这里的 mode 是分布的峰,即概率质量或密度集中的一个局部高点。假设目标分布 P 有两个相隔很远的峰,但我们限制模型 Q 只能是一条单峰的高斯曲线。Q 无法把两个峰都原样画出来,必须作出取舍。
Mode-covering(覆盖多个峰)指的是把分布铺得比较宽,尽量照顾 P 中几个都有明显概率质量的区域。在这个受限制的例子里,最小化正向 KL 往往体现出这种取舍:P 会在两个峰附近产生数据,如果 Q 漏掉一个峰,来自那个区域的观测就会有很大的 log-loss。
Mode-seeking(集中拟合某个峰)则指把 Q 集中在一个峰附近,即使因此无法覆盖另一个峰。在同一个例子里,反向 KL 按 Q 加权。若为了覆盖两个峰而把 Q 铺得很宽,它会把相当一部分质量放进 P 很低的谷地;集中到一边可以避免这项代价。5
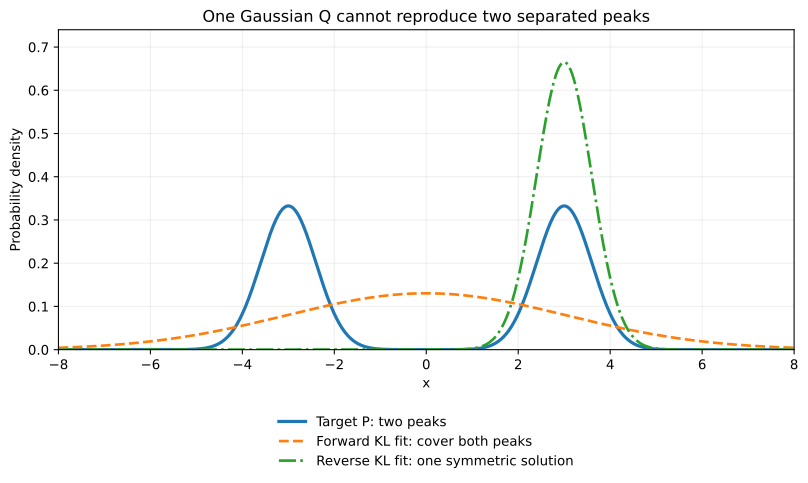
这是一组独立的连续分布示例,纵轴是概率密度,不是类别概率。目标是均值为 −3 和 3、标准差均为 0.6、权重各半的两个高斯分布。正向 KL 的单高斯最优解由均值和方差匹配得到;反向结果是多起点数值优化及独立积分复核得到的一个对称解,并非全局最优性的证明。左边还有一个对称的等价解。
这不是“正向 KL 永远覆盖所有峰、反向 KL 永远只选一个峰”的定理。 倾向取决于目标分布、允许的模型族以及优化结果。如果 Q 的模型族能够表示 P,并且优化找到它,两个方向都可以在 Q = P 时达到零。也不要把 mode 解释为峰高:哪个近似被偏好并非只由最高点决定。
5. 回到语言模型,也顺便看一眼 RL
现在可以把这个关系放回语言模型。设 C 表示上下文,Y 表示实际的 next token。用 P_data 表示未知的数据生成分布,用 Qθ 表示模型的条件预测分布。这与前面用五次观测构造的经验分布不同。总体上的 expected next-token NLL 是:
\[\mathcal L(\theta) =\mathbb E_{(C,Y)\sim P_{\mathrm{data}}}\bigl[-\log Q_\theta(Y\mid C)\bigr].\]在适当的支持条件下,它可以分解为:
\[\begin{aligned} \mathcal L(\theta) &=H_{P_{\mathrm{data}}}(Y\mid C)\\ &\quad+\mathbb E_{C\sim P_{\mathrm{data}}} \left[D_{\mathrm{KL}}\bigl(P_{\mathrm{data}}(\cdot\mid C)\|Q_\theta(\cdot\mid C)\bigr)\right]. \end{aligned}\]第一项描述数据分布本身的条件不确定性,不随模型参数变化;第二项才是模型的条件分布与数据分布之间的不匹配。于是,在总体期望的意义下,最小化 Cross-Entropy 就等价于最小化以数据分布为第一参数的 KL。 实际训练时,我们只能用有限样本近似这一期望,未知的真实分布也不会直接交到模型手里。
这条线还可以连接到 Maximum Entropy RL,但这里先不深入算法。标准 RL 倾向于寻找能获得高 expected reward 的策略;entropy-regularized RL 则有意给策略分布的熵一定权重。对于一个有限动作集合,假设每个动作有一个已知 value score,记为 v(a)。优化的策略 π 是这个动作集合上的概率分布,各个概率非负且总和为一。考虑下面这个简化的单状态目标:
\[\max_{\pi}\left\{ \sum_a\pi(a)v(a)+\alpha H(\pi) \right\},\qquad\alpha>0,\]在归一化约束下引入 Lagrange multiplier,对每个动作概率求导得到:
\[v(a)-\alpha(\log\pi(a)+1)+\lambda=0.\]解出各动作的相对权重,再归一化,其最优分布具有熟悉的形式:
\[\pi^*(a)=\frac{e^{v(a)/\alpha}}{\sum_b e^{v(b)/\alpha}}.\]这又回到了上一篇的 Softmax。保留 entropy 不是说奖励不再重要,也不是要求策略永远随机选择差动作;它是在最大化 value 的同时,为维持多种选择的可能性付出一定权衡。 完整的动态 RL 情形还涉及状态分布、未来回报和温度系数,这里不展开。
最终,我们从上一篇的一次观测损失出发,得到了几种不同层次的量:一次结果的 surprisal、一个分布的平均 surprisal、使用另一分布预测时的平均 log-loss,以及这两种平均损失之间的差。它们共享负对数的结构,却在回答不同的问题。
下一次再看到负对数,我希望先问的已经不只是“这个公式叫什么”,而是:对数里是谁的概率?期望又是对谁取的?
文中的图是可复现的教学示例,不是实验结果。绘图源码。
-
SciPy 官方文档,scipy.stats.entropy,Notes 中说明自然对数使用 nats、以 2 为底使用 bits;换算与本文的具体数值由公式直接计算。 ↩
-
Claude E. Shannon, A Mathematical Theory of Communication (1948),第 6 节讨论 choice、uncertainty 与 entropy。原文重印。 ↩
-
David Tong, Statistical Physics,第 1 章,尤其公式 1.30 及其说明。作者讲义。 ↩
-
NIST,Kelvin: Boltzmann Constant,说明 Boltzmann 常数的 J/K 单位。 ↩
-
Tom Minka, Divergence Measures and Message Passing, MSR-TR-2005-173 (2005),第 2 节讨论不同方向与不同散度在受限制近似中的取舍。作者页面。本文配图是单独构造并计算的教学例子,不是原论文的实验结果。 ↩