Pourquoi −log p revient-il si souvent ?
First Principles of LLMs & RL · Article 02 · Article précédent
Note de rédaction : les idées et le matériau du brouillon initial sont de moi. ChatGPT m’a aidé à structurer, réviser et traduire le texte.
De la surprise à l’entropie, l’entropie croisée et la divergence de Kullback–Leibler
Dans l’article précédent, nous sommes partis des observations pour passer par les logits, le Softmax et la règle de chaîne des probabilités, jusqu’à obtenir un terme familier de l’entraînement des modèles de langage :
\[-\log Q(y).\]Ici, Q est la distribution de probabilité produite par le modèle et y le token effectivement observé. Plus le modèle attribue une faible probabilité à ce résultat, plus la perte est élevée.
Mais le logarithme négatif ne se rencontre pas seulement dans le maximum de vraisemblance. En théorie de l’information, il décrit l’information apportée par un résultat observé. En prendre l’espérance donne l’entropie. Si la distribution à l’origine des observations diffère de celle utilisée pour les prédire, on obtient l’entropie croisée. Enfin, soustraire une valeur de référence fait apparaître la divergence KL.
Pourquoi ces quantités se ressemblent-elles autant ? On peut partir d’une exigence assez simple : si deux événements se produisent successivement, nous voulons pouvoir combiner l’information qu’ils apportent.
1. Pourquoi l’information d’une observation est-elle un logarithme négatif ?
Imaginons deux résultats possibles. Le premier a une probabilité de 0,99 et le second de 0,01. Quand le premier se produit, il n’y a guère de surprise ; le second provoque une tout autre réaction.
Si la probabilité doit nous servir à mesurer l’information, nous voulons au minimum qu’un résultat moins probable apporte davantage d’information et qu’un résultat certain n’en apporte aucune.
Ajoutons une autre exigence. Supposons que l’événement A survienne, puis que nous observions B sachant que A a eu lieu. La définition de la probabilité conditionnelle, utilisée dans l’article précédent, donne :
\[P(A\cap B)=P(A)P(B\mid A).\]Si nous voulons que l’information associée à l’événement conjoint soit égale à celle de la première étape plus l’information supplémentaire de la seconde, il nous faut une fonction qui transforme un produit en somme. C’est précisément une propriété du logarithme :
\[-\log P(A\cap B) =-\log P(A)-\log P(B\mid A).\]Nous n’avons supposé aucune indépendance entre A et B. C’est seulement sous cette hypothèse que le second terme devient l’information de B sans conditionnement sur A.
Plus généralement, exigeons qu’une fonction d’information continue vérifie :
\[I(pq)=I(p)+I(q),\]et décroisse strictement lorsque la probabilité augmente. Elle doit alors être un multiple positif du logarithme négatif. En choisissant le logarithme naturel et en fixant ce facteur à un, on obtient la surprise informationnelle (surprisal, ou auto-information) :
\[I_P(x)=-\log P(x),\qquad P(x)>0.\]L’indice P est important : le même résultat peut présenter une surprise différente selon la distribution retenue. Avec un logarithme en base 2, l’information se mesure en bits ; avec le logarithme naturel, elle se mesure en nats (unités naturelles d’information). Ce sont deux échelles pour une même quantité.1
Ainsi, un événement dont la probabilité vaut exactement l’inverse de e apporte :
\[-\ln(e^{-1})=1\ \text{nat}.\]Le changement de base donne :
\[1\ \text{nat}=\frac{1}{\ln2}\ \text{bits}\approx1.4427\ \text{bits}.\] \[1\ \text{bit}=\ln2\ \text{nats}\approx0.6931\ \text{nats}.\]Pour une pièce équilibrée, chaque côté a une probabilité d’un demi. Observer un côté particulier apporte donc 1 bit, soit environ 0,6931 nat. Changer d’unité modifie la valeur numérique, mais ni l’incertitude de la pièce ni l’ordre des résultats du moins au plus surprenant.
Par convention limite, un résultat auquel on attribue une probabilité exactement nulle possède une surprise infinie.
Cela ne signifie pas que la nature impose une mesure logarithmique de l’information. La forme logarithmique découle des propriétés que nous souhaitons lui donner, notamment l’additivité de l’information lorsque les probabilités se multiplient.
2. Pourquoi l’entropie est-elle une surprise moyenne plutôt qu’une somme ?
L’entropie mesure l’incertitude qui reste sur le prochain résultat, même lorsque nous connaissons les probabilités de toutes les possibilités. Numériquement, c’est l’auto-information moyenne obtenue lorsque le résultat est révélé.2
La précision « même lorsque nous connaissons les probabilités » est essentielle. Savoir qu’une pièce est équilibrée ne nous dit pas sur quel côté elle tombera. L’incertitude sur le résultat n’est pas l’incertitude sur la probabilité de la pièce, et n’équivaut pas automatiquement à un manque de connaissances du modèle.
Lorsqu’une issue est presque certaine, apprendre ce qui s’est produit apporte généralement peu d’information. Si plusieurs issues sont plausibles, apprendre laquelle s’est produite apporte davantage d’information en moyenne. C’est le sens de l’espérance dans la formule.
Reprenons le petit corpus de l’article précédent. Après I like, nous avons observé cinq tokens : trois fois cats, une fois dogs et une fois pizza. Leur distribution empirique est :
Ici, P est une distribution empirique utilisée pour l’explication, et non la distribution réelle, inconnue, qui génère le langage. Nous omettons provisoirement le contexte de conditionnement, identique pour les cinq observations.
Si nous observons cats, la surprise calculée selon P vaut :
Pour dogs, elle vaut :
Une même distribution peut produire des résultats avec des surprises très différentes. L’information d’une observation dépend de ce qui s’est effectivement produit ; avant de l’observer, nous ne savons pas quelle valeur elle prendra.
Pour caractériser l’incertitude de la distribution entière, demandons-nous quelle serait la surprise moyenne si nous répétions des tirages selon P. Nous avons besoin d’une espérance :
\[\begin{aligned} H(P)&=\mathbb E_{X\sim P}[-\log P(X)]\\ &=-\sum_x P(x)\log P(x). \end{aligned}\]Pour nos trois résultats :
\[H(P)=-0.6\log0.6-2(0.2\log0.2) \approx0.950\ \text{nats}.\]Lorsqu’un résultat a une probabilité nulle, sa contribution à la somme est définie par la convention limite usuelle. Cette valeur ne correspond ni aux 0,511 nat obtenus pour cats ni aux 1,609 nat obtenus pour dogs. C’est la moyenne pondérée des surprises de tous les résultats possibles.
Pour voir le phénomène, faisons varier la probabilité de deux résultats :
\[P_p=(p,1-p),\qquad 0\leq p\leq1.\]L’entropie correspondante est :
\[H(P_p)=-p\ln p-(1-p)\ln(1-p).\]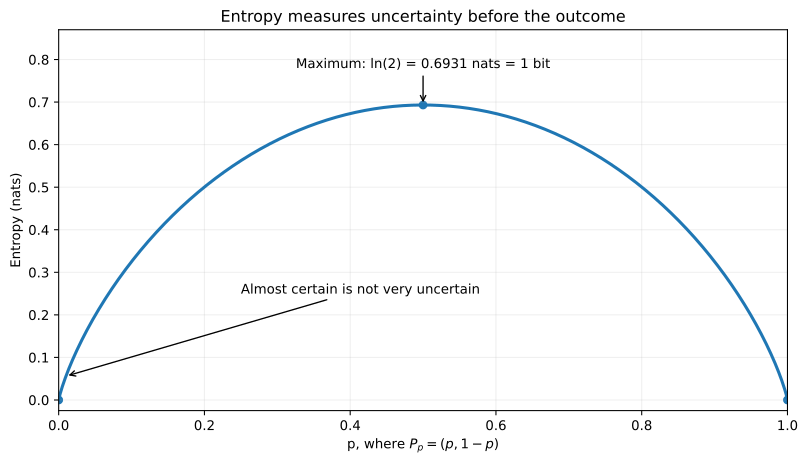
L’axe horizontal fait varier le paramètre p de la distribution, pas le résultat d’un essai particulier. L’axe vertical représente l’entropie de cette distribution. Aux extrémités, les termes de probabilité nulle suivent la convention limite. Le maximum est ln 2 ≈ 0,6931 nat, soit 1 bit.
Pour une pièce dont les probabilités sont 0,99 et 0,01, observer le côté rare apporte environ 4,605 nats. Pourtant, l’entropie de sa distribution n’est que d’environ 0,056 nat. Cet événement est très surprenant, mais il est aussi très rare. Un résultat rare peut apporter beaucoup d’information alors que l’incertitude moyenne de la distribution reste faible.
Pourquoi ne pas additionner les surprises de tous les résultats possibles ? Cela donnerait le même poids aux résultats rares et fréquents et ne répondrait pas à la question : combien d’information apporte un tirage typique ? L’information accumulée sur n observations successives est autre chose : si ces observations sont dépendantes, on additionne à chaque étape la surprise conditionnelle compte tenu des résultats précédents, et non les surprises marginales sans précaution. Pour des tirages indépendants et identiquement distribués, leur moyenne empirique converge vers l’entropie dans les conditions usuelles.
Il faut donc distinguer : la surprise attendue n’est pas le même objet que la surprise de chaque résultat effectivement observé. Leurs valeurs numériques peuvent coïncider : dans une distribution uniforme, chaque résultat possible possède une surprise égale à l’entropie. Mais l’entropie caractérise une distribution, tandis que la surprise caractérise un résultat précis. L’entropie empirique d’un échantillon fini peut aussi différer de celle de la distribution génératrice inconnue.
Et l’entropie en physique ? Pour une distribution discrète sur les micro-états d’un système, l’entropie de Gibbs possède également la structure d’une espérance du logarithme négatif :
\[S=-k_B\sum_i p_i\log p_i.\]Les probabilités concernent ici des micro-états physiques, et la constante de Boltzmann s’exprime en joules par kelvin. Pour cette même distribution de micro-états, le lien avec l’entropie informationnelle en logarithmes naturels est :3
\[\frac{S}{k_B}=-\sum_i p_i\ln p_i.\]Un modèle à deux micro-états peut donc reprendre la forme de la courbe d’entropie binaire ci-dessus pour S divisé par la constante de Boltzmann. Mais l’entropie physique S est exprimée en J/K. Rien ne permet pour autant d’appeler la distribution de tokens d’un texte « l’entropie thermodynamique » d’un système physique.4
Lorsque tous les Ω micro-états accessibles sont équiprobables, nous retrouvons la formule de Boltzmann :
\[S=k_B\log\Omega.\]L’entropie physique dépend aussi de la définition des micro-états, des contraintes énergétiques et du cadre thermodynamique. La traduire simplement par « désordre » n’explique pas la présence de l’espérance dans la formule.
3. Et si les données viennent de P, mais que les prédictions utilisent Q ?
L’entropie évalue les résultats tirés de P à l’aide des probabilités de P lui-même. Dans l’entraînement d’un modèle de langage, nous ne connaissons pourtant pas la véritable distribution. Nous disposons d’une approximation fournie par le modèle, notée Q.
Gardons les trois mêmes résultats et supposons que le modèle produise les logits suivants :
\[z=(0,1,2).\]Le Softmax les transforme en :
\[Q\approx(0.0900,\ 0.2447,\ 0.6652).\]| Résultat | Distribution empirique P | Modèle Q | Perte si le résultat est observé |
|---|---|---|---|
cats | 0.6000 | 0.0900 | 2.408 |
dogs | 0.2000 | 0.2447 | 1.408 |
pizza | 0.2000 | 0.6652 | 0.408 |
Ces valeurs sont de véritables probabilités. Pourtant, le modèle attribue la plus faible probabilité à cats, le résultat le plus fréquent, et la plus forte à pizza.
Si les résultats suivent toujours P, mais que nous les prédisons avec Q, quelle sera la perte logarithmique négative moyenne ?
\[\boxed{\begin{aligned} H(P,Q)&=\mathbb E_{X\sim P}[-\log Q(X)]\\ &=-\sum_x P(x)\log Q(x) \end{aligned}}\]C’est l’entropie croisée (cross-entropy). Les deux distributions n’ont pas le même rôle dans l’espérance : P détermine la fréquence des résultats, tandis que Q détermine la perte attribuée à chacun d’eux.
Dans notre exemple :
\[\begin{aligned} H(P,Q)&=-0.6\log0.0900-0.2\log0.2447\\ &\quad-0.2\log0.6652\\ &\approx1.808\ \text{nats}. \end{aligned}\]Les probabilités affichées ont été arrondies ; le résultat plus précis est d’environ 1,8076 nat. On peut décomposer cette espérance en trois contributions pondérées, une par résultat :
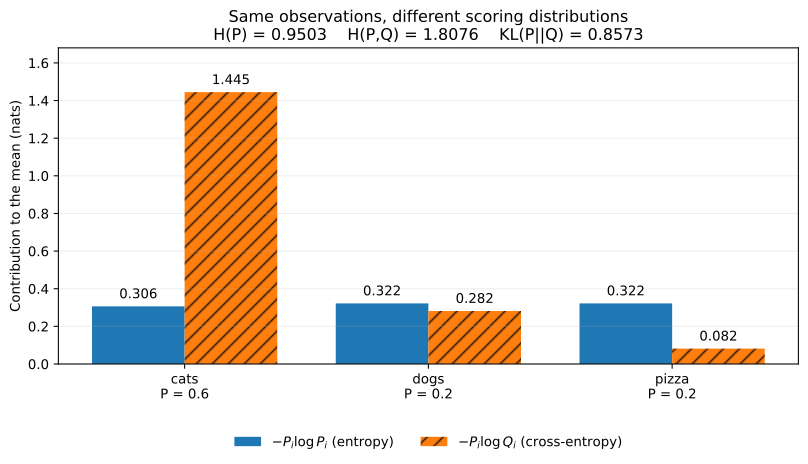
Chaque barre représente la contribution d’un résultat à la moyenne, et non sa surprise brute. La somme des barres d’entropie donne environ 0,9503 nat ; celle des barres d’entropie croisée, environ 1,8076 nat. Dans les deux cas, les contributions sont pondérées par P. Seule change la distribution à l’intérieur du logarithme.
Pour nos cinq observations, la log-vraisemblance négative totale vaut donc environ :
\[5H(P,Q)\approx9.038.\]C’est exactement le calcul effectué à la fin de l’article précédent. Puisque P a été construit à partir de ces cinq observations, l’entropie croisée empirique est égale à la NLL moyenne.
Avec plusieurs classes, l’entropie croisée est-elle encore égale à la NLL ? Oui, pour un exemple avec une étiquette one-hot. Si la classe observée est y :
\[-\sum_{k=1}^{K}\mathbf 1[k=y]\log Q(k) =-\log Q(y).\]Si la cible est une distribution complète plutôt qu’une seule classe, l’entropie croisée est la NLL attendue selon cette cible.
Le terme cross peut se comprendre comme le fait qu’une distribution produit les observations et qu’une autre les évalue. Elles peuvent différer, mais aussi être identiques. L’entropie croisée n’est pas une autre manière de désigner l’entropie conditionnelle. Celle-ci porte sur deux variables aléatoires et leur distribution jointe, par exemple l’incertitude restant sur un token quand on connaît son contexte. Dans H(P,Q), les arguments sont des distributions ; dans l’entropie conditionnelle, les objets sont des variables aléatoires.
4. Divergence KL : le surcoût d’une prédiction avec la mauvaise distribution
Pour des observations provenant de P, nous avons désormais deux pertes moyennes. Si nous les évaluons avec P, nous obtenons l’entropie ; si nous les évaluons avec Q, l’entropie croisée. La différence vaut :
\[\begin{aligned} H(P,Q)-H(P) &=-\sum_xP(x)\log Q(x) +\sum_xP(x)\log P(x)\\ &=\sum_xP(x)\log\frac{P(x)}{Q(x)}. \end{aligned}\]Le membre de droite est la divergence de Kullback–Leibler :
\[\boxed{ D_{\mathrm{KL}}(P\|Q) =\mathbb E_{X\sim P}\left[\log\frac{P(X)}{Q(X)}\right] }\]Par conséquent :
\[\boxed{H(P,Q)=H(P)+D_{\mathrm{KL}}(P\|Q).}\]Avec exactement les mêmes distributions P et Q :
\[\begin{aligned} H(P)&\approx0.9503,\\ H(P,Q)&\approx1.8076,\\ D_{\mathrm{KL}}(P\|Q)&\approx0.8573. \end{aligned}\]La divergence KL est le supplément de perte logarithmique moyenne payé lorsque nous utilisons Q au lieu de P pour prédire des données issues de P. Elle ne résulte pas d’une règle universelle imposant de mesurer toute erreur de modèle par la KL. Une fois la log-loss choisie, la KL apparaît comme l’écart au meilleur niveau moyen atteignable. D’autres fonctions de perte conduisent à d’autres mesures d’écart.
Il est possible qu’un résultat particulier contribue moins à l’entropie croisée qu’à l’entropie : notre modèle surestime pizza, dont la prédiction est donc relativement peu coûteuse lorsqu’il apparaît. La non-négativité de la KL porte sur la différence totale, moyennée selon P, et non sur chaque contribution prise séparément.
Pour dessiner cette différence, gardons P fixe et faisons varier Q le long d’une famille simple à un paramètre. Notons q la probabilité que le modèle attribue à cats ; le reste est partagé également entre dogs et pizza :
Cette famille est choisie pour la visualisation. Elle n’est pas la distribution Softmax fixe obtenue avec les logits (0, 1, 2).
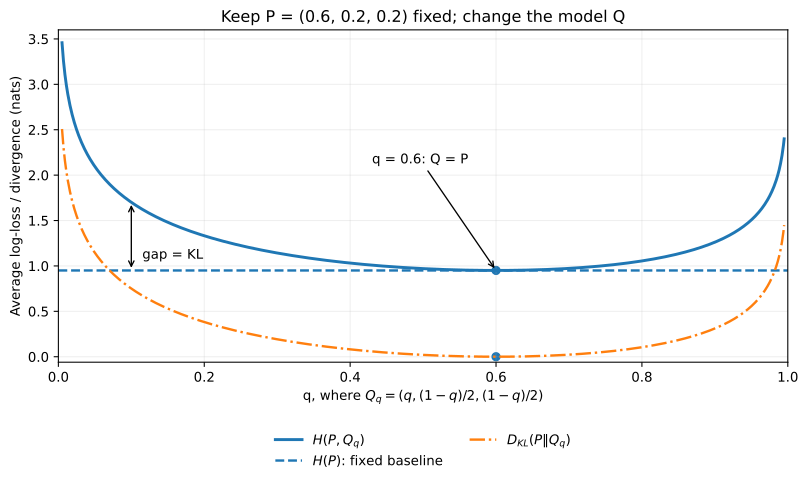
Lorsque q = 0,6, Q est égal à P, l’entropie croisée atteint H(P) et la KL vaut zéro. P reste fixe : H(P) est donc une ligne de référence horizontale. L’écart KL représenté est une différence verticale entre les valeurs des courbes, pas une aire entre celles-ci.
Pourquoi cet écart ne peut-il pas être négatif ? Supposons un espace fini de résultats et deux distributions P et Q strictement positives. Pour tout nombre u positif, l’inégalité élémentaire suivante s’applique :
\[-\log u\geq1-u,\]Nous obtenons alors :
\[\begin{aligned} D_{\mathrm{KL}}(P\|Q) &=\sum_xP(x)\left[-\log\frac{Q(x)}{P(x)}\right]\\ &\geq\sum_x(P(x)-Q(x))=0. \end{aligned}\]L’égalité est atteinte uniquement lorsque P égale Q. Autrement dit, si les données suivent effectivement P, utiliser P pour les prédire ne peut pas produire une perte logarithmique moyenne à long terme plus élevée qu’une autre distribution.
Mais la KL possède une propriété que n’a pas une distance ordinaire : elle est orientée.
\[D_{\mathrm{KL}}(P\|Q)\ne D_{\mathrm{KL}}(Q\|P)\quad\text{(in general)}.\]En inversant les arguments pour nos deux mêmes distributions, nous obtenons :
\[D_{\mathrm{KL}}(Q\|P)\approx0.6781,\]contre environ 0,8573 dans l’autre sens. La différence ne vient pas d’une astuce numérique : tout dépend de la distribution qui fournit les poids de la moyenne. La KL directe moyenne selon les résultats de P, la KL inverse selon ceux de Q. Précisons qu’inverser les arguments inverse aussi le rapport à l’intérieur du logarithme : nous ne faisons pas qu’échanger les poids de la moyenne.
Un cas extrême rend cette asymétrie visible. Si P attribue une probabilité positive à un résultat auquel Q attribue exactement zéro, la KL directe est infinie ; la KL inverse ne l’est pas nécessairement. Pour des logits finis, le Softmax ne donne pas de zéros exacts, mais il peut donner des probabilités très faibles, avec des pénalités importantes.
Pour aller plus loin : que signifient mode-covering et mode-seeking ?
Un mode est un pic d’une fonction de masse ou de densité de probabilité. Imaginons que la distribution cible P possède deux pics très éloignés, alors que la famille de distributions autorisée pour Q ne contient que des gaussiennes à un seul pic. Q ne peut pas reproduire fidèlement les deux pics : elle doit faire un compromis.
Le mode-covering (couverture de plusieurs modes) consiste à élargir l’approximation pour couvrir plusieurs régions où P possède une masse de probabilité importante. Dans cet exemple contraint, minimiser la KL directe tend souvent à favoriser ce compromis : P génère des observations près des deux pics, et en manquer un peut entraîner une forte log-loss.
Le mode-seeking (concentration sur un mode) consiste à rapprocher Q d’un seul pic, quitte à ne pas couvrir l’autre. La KL inverse moyenne selon Q. En étalant Q sur les deux pics, on peut aussi lui attribuer beaucoup de masse dans la vallée, où P est très faible ; se concentrer sur un pic évite cette pénalité.5
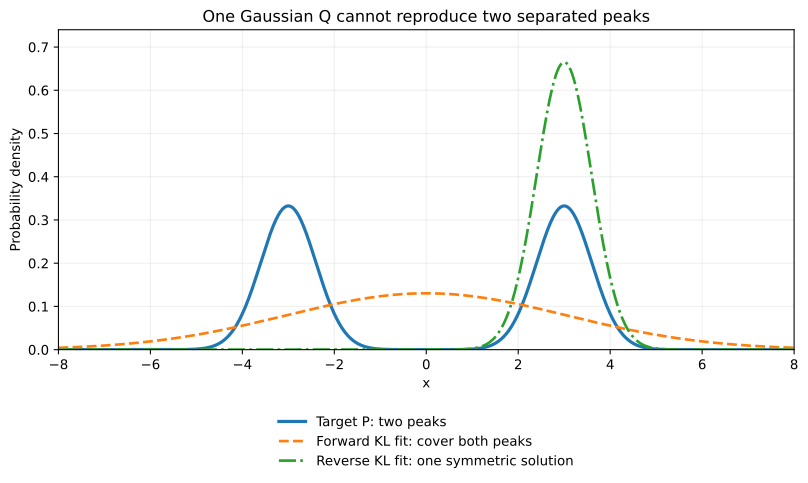
Il s’agit d’un exemple distinct sur des densités continues, pas de probabilités catégorielles de prochains tokens. La cible est un mélange à parts égales de deux gaussiennes centrées en −3 et 3, chacune d’écart-type 0,6. L’optimum de KL directe parmi les gaussiennes simples vient de l’ajustement des deux premiers moments. La courbe de KL inverse résulte d’une optimisation numérique avec plusieurs initialisations, puis d’une vérification par intégration indépendante : cela ne prouve pas son optimalité globale. Une solution symétrique existe près de l’autre pic.
« La KL directe couvre toujours tous les modes et la KL inverse en choisit toujours un » n’est pas un théorème. Ce comportement dépend de la cible P, de la famille permise pour Q et du résultat de l’optimisation. Si cette famille contient P et que l’optimisation la retrouve, les deux divergences peuvent être nulles. Un mode n’est pas simplement une hauteur de pic : toute la distribution intervient dans le compromis.
5. Retour aux modèles de langage, avec un détour par le RL
Replaçons maintenant ces relations dans un modèle de langage. Notons C le contexte, Y le prochain token observé, P_data la distribution génératrice inconnue et Qθ la distribution conditionnelle prédite par le modèle. Contrairement à la distribution empirique construite à partir de cinq observations, P_data désigne la distribution sous-jacente. Au niveau de la population, la NLL attendue pour le prochain token vaut :
\[\mathcal L(\theta) =\mathbb E_{(C,Y)\sim P_{\mathrm{data}}}\bigl[-\log Q_\theta(Y\mid C)\bigr].\]Sous des hypothèses de support appropriées, elle se décompose en :
\[\begin{aligned} \mathcal L(\theta) &=H_{P_{\mathrm{data}}}(Y\mid C)\\ &\quad+\mathbb E_{C\sim P_{\mathrm{data}}} \left[D_{\mathrm{KL}}\bigl(P_{\mathrm{data}}(\cdot\mid C)\|Q_\theta(\cdot\mid C)\bigr)\right]. \end{aligned}\]Le premier terme est l’incertitude conditionnelle propre à la distribution des données ; il ne dépend pas des paramètres du modèle. Le second mesure l’écart entre les probabilités conditionnelles du modèle et celles des données. À l’échelle de l’espérance sur la population, minimiser l’entropie croisée revient donc à minimiser la KL directe, où la distribution des données figure en premier argument. En pratique, nous approchons cette espérance par un échantillon fini ; la véritable distribution ne nous est pas fournie.
Le même fil nous conduit au reinforcement learning à entropie maximale, sans détailler ici un algorithme complet. Dans le RL standard, on cherche des politiques donnant un rendement attendu élevé. Le RL régularisé par l’entropie accorde aussi un poids à l’incertitude de la distribution d’actions. Considérons un problème simplifié à un seul état, un ensemble fini d’actions et un score de valeur connu v(a) pour chaque action. La politique π est une distribution de probabilité sur ces actions : les probabilités sont non négatives et leur somme vaut un. Nous optimisons :
\[\max_{\pi}\left\{ \sum_a\pi(a)v(a)+\alpha H(\pi) \right\},\qquad\alpha>0,\]Introduisons un multiplicateur de Lagrange pour la contrainte de normalisation et dérivons par rapport à chaque probabilité d’action :
\[v(a)-\alpha(\log\pi(a)+1)+\lambda=0.\]En résolvant pour les poids relatifs des actions, puis en normalisant, on obtient :
\[\pi^*(a)=\frac{e^{v(a)/\alpha}}{\sum_b e^{v(b)/\alpha}}.\]Nous retrouvons le Softmax. La récompense reste importante ; favoriser l’entropie ne signifie pas obliger la politique à choisir indéfiniment de mauvaises actions au hasard. Il s’agit d’un compromis entre la valeur attendue et la possibilité de plusieurs actions. Le RL dynamique complet implique aussi des distributions d’états, des retours futurs et un coefficient de température ; nous y reviendrons plus tard.
Nous avons commencé par la perte d’une observation et rencontré des quantités de niveaux différents : la surprise d’un résultat, la surprise moyenne d’une distribution, la log-loss moyenne obtenue en prédisant avec une autre distribution, et l’écart entre ces deux moyennes. Elles partagent la structure du logarithme négatif, mais ne répondent pas à la même question.
La prochaine fois que je rencontrerai un logarithme négatif, je ne voudrais plus seulement me demander comment s’appelle la formule. Je voudrais d’abord savoir : de quelle distribution vient la probabilité dans le logarithme, et quelle distribution détermine l’espérance ?
Les figures sont des exemples pédagogiques, pas des résultats expérimentaux. Code des graphiques.
-
Documentation SciPy, scipy.stats.entropy, pour les unités nat et bit selon la base du logarithme. Les conversions et les exemples chiffrés sont calculés directement. ↩
-
Claude E. Shannon, A Mathematical Theory of Communication (1948), section 6 sur le choix, l’incertitude et l’entropie. Reproduction du texte original. ↩
-
David Tong, Statistical Physics, chapitre 1, notamment l’équation 1.30 et sa discussion. Notes de cours de l’auteur. ↩
-
NIST, Kelvin: Boltzmann Constant, sur l’unité J/K de la constante de Boltzmann. ↩
-
Tom Minka, Divergence Measures and Message Passing, MSR-TR-2005-173 (2005), section 2 sur les compromis entre divergences directes et inverses dans des familles d’approximation contraintes. Page de l’auteur. La figure publiée ici est un exemple pédagogique indépendant, et non une reproduction des résultats expérimentaux du rapport. ↩