First Principles of LLMs & RL · Article 01 · Pourquoi réapprendre ?
Note de rédaction : les idées et le matériau du brouillon initial sont de moi. ChatGPT m’a aidé à structurer et réviser le texte, ainsi qu’à préparer les traductions.
Des observations au Softmax, puis au maximum de vraisemblance
Je savais développer la règle de chaîne des probabilités. Ce qui m’a arrêté venait avant l’algèbre : d’où vient la probabilité, au départ ?
Un jeu de données d’entraînement contient des choses qui se sont produites : une phrase, un label, le token qui suit un préfixe donné. Un modèle de langage, lui, attribue des probabilités à ce qui pourrait se produire. Le jeu de données ne lui fournit pas une probabilité pour chaque continuation possible.
Il y a en réalité trois problèmes liés. Un réseau neuronal produit naturellement des nombres réels non contraints, alors que nous voulons une distribution de probabilité sur les prochains tokens possibles. Une distribution du prochain token reste locale ; un modèle de langage doit aussi attribuer une probabilité à une séquence entière. Enfin, même lorsque le modèle sait attribuer une probabilité à une séquence observée, il nous faut encore un principe pour modifier ses paramètres.
Plutôt que de traiter le Softmax, la règle de chaîne et le maximum de vraisemblance comme trois sujets séparés, je vais suivre le même objet à mesure qu’il change de forme :
\[\begin{aligned} \text{observations}&\longrightarrow\text{shared model}\\ &\longrightarrow\text{logits}\\ &\longrightarrow\text{next-token distribution}\\ &\longrightarrow\text{sequence probability}\\ &\longrightarrow\text{learning objective} \end{aligned}\]Il s’agit d’un parcours conceptuel, pas d’un forward pass littéral : l’objectif d’apprentissage sert ensuite à modifier les paramètres partagés du début. Chaque étape apparaît parce que la précédente laisse une question sans réponse.
I. Comment un modèle obtient-il des probabilités ?
Observations, comptage et paramètres partagés
Prenons cinq phrases. Pour simplifier cet exemple, considérons provisoirement chaque mot comme un token :
I like cats
I like dogs
I like cats
I like pizza
I like cats
Après I like, cats apparaît trois fois ; dogs et pizza apparaissent une fois chacun. Dans cet ordre, la distribution conditionnelle empirique est :
Le chapeau indique une estimation construite à partir de l’échantillon. Les observations sont les cinq phrases. La distribution empirique est une description que nous construisons à partir d’elles. Elle n’est pas une description complète de la manière dont le langage est généré.
Compter les continuations ressemble davantage à un modèle de langage fondé sur les comptes qu’à Word2Vec. Par exemple, soit C(u,v) le nombre de fois où le token v suit le token u, et C(u) le nombre d’occurrences de u ayant un token suivant. Un estimateur bigramme non lissé est :
\[\widehat P(v\mid u)=\frac{C(u,v)}{C(u)},\qquad C(u)>0.\]Plus le contexte s’allonge, plus le comptage direct devient sparse : un préfixe peut n’apparaître qu’une fois, voire jamais. Les modèles fondés sur les comptes peuvent traiter cette sparsité par le smoothing et des contextes plus courts ; les modèles de langage neuronaux apprennent plutôt des représentations distribuées et des fonctions de probabilité qui permettent de partager de l’information entre exemples.1
Word2Vec se situe déjà du côté du partage de paramètres : il apprend des vecteurs à partir d’observations mot-contexte au lieu de conserver une table de fréquences pour chaque contexte exact. Le terme statique décrit la manière dont le vecteur d’un mot est utilisé, pas une table de comptes.2
Pour notre modèle de langage, notons c un contexte, y un prochain token candidat et θ l’ensemble des paramètres du modèle. Nous voulons une fonction :
\[P_\theta(y\mid c).\]Le partage de paramètres signifie que différents contextes utilisent le même ensemble de paramètres, pas qu’ils produisent la même sortie. Une mise à jour provenant d’un exemple modifie des paramètres qui sont aussi utilisés pour d’autres exemples. Cela crée une possibilité de généralisation ; cela ne garantit pas que cette généralisation sera bonne.
Le partage et l’initialisation sont deux choix distincts. Dans le cadre d’un entraînement from scratch, les matrices de poids partent d’une initialisation aléatoire choisie ; certains autres paramètres peuvent commencer à des valeurs fixes comme zéro ou un. Le partage fait déjà partie de l’architecture avant tout apprentissage. Le fine-tuning, au contraire, part de paramètres déjà appris.
Le partage de paramètres permet à la même fonction de calculer une sortie pour de nombreux contextes, y compris des contextes absents de l’entraînement. Cela ne garantit pas que ces prédictions se généralisent correctement. Mais l’objet dont nous avons besoin n’est pas un vecteur réel arbitraire. C’est une distribution normalisée sur les prochains tokens possibles. C’est précisément l’écart que les logits et le Softmax viennent combler.
Qu’est-ce qu’un logit, exactement ?
Dire qu’un logit est un « score » laisse une question importante sans réponse : un score de quoi ?
Supposons qu’un contexte ait été transformé en un vecteur caché h de dimension d. Pour le token candidat i, une couche de sortie peut calculer :
\[z_i=w_i^\top h+b_i.\]Ici, wᵢ est un vecteur appris de dimension d et bᵢ un biais scalaire. Avec K tokens possibles dans le vocabulaire, les sorties forment :
\[z=(z_1,\ldots,z_K)\in\mathbb R^K.\]Ce sont les logits. À ce stade, ce sont simplement des nombres réels sans contrainte. Ils n’ont pas d’unité prédéfinie de « vérité », de confiance ou de fréquence. Leur interprétation probabiliste vient de la manière dont nous choisissons d’utiliser ces nombres.
Un choix utile consiste à interpréter chaque logit comme un log-poids. L’exponentiation donne un poids positif :
\[a_i=e^{z_i}.\]On normalise ensuite ces poids pour obtenir une distribution catégorielle :
\[p_i=\frac{e^{z_i}}{\sum_{j=1}^{K}e^{z_j}}.\]C’est le Softmax. Plus précisément, il produit la distribution conditionnelle recherchée dès le départ. Si le réseau calcule les logits à partir du contexte c, la probabilité conditionnelle du token i du vocabulaire est :
\[P_\theta(y=i\mid c)=\operatorname{softmax}(z_\theta(c))_i\]Pour un vecteur fini de logits réels finis, l’arithmétique exacte donne des probabilités strictement positives dont la somme vaut un. Une distribution de probabilité générale peut contenir des zéros ; le Softmax à logits finis représente l’intérieur strictement positif du simplexe.
Un petit exemple rend la transformation concrète. Les valeurs ci-dessous sont arrondies, mais proviennent du même vecteur :
| Candidat | Logit | Poids positif après exp | Probabilité après normalisation |
|---|---|---|---|
| cats | 0 | 1.0000 | 0.0900 |
| dogs | 1 | 2.7183 | 0.2447 |
| pizza | 2 | 7.3891 | 0.6652 |
Les trois candidats sont maintenant ceux des observations initiales : cats, dogs et pizza. Ce tableau présente une sortie illustrative du modèle, pas la distribution empirique. Le modèle attribue seulement environ 0.0900 à cats, qui apparaît pourtant dans trois observations sur cinq. Le Softmax produit bien des probabilités valides, mais elles ne correspondent pas bien aux observations. Nous reviendrons sur cet écart avec la vraisemblance.
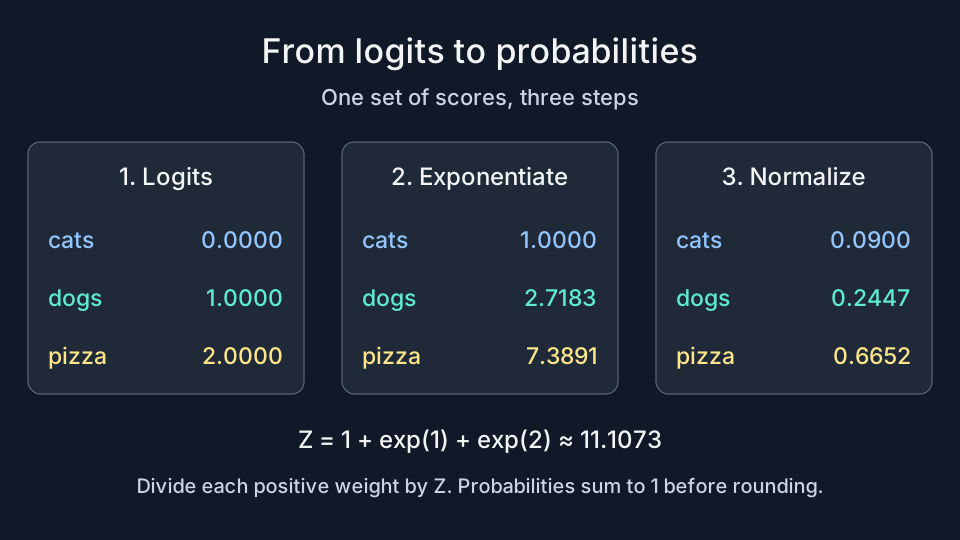
On peut imaginer une quantité fixe répartie proportionnellement à des poids positifs. Les poids n’ont pas besoin de sommer à un ; leurs parts, si. Les logits enregistrent ces poids sur une échelle logarithmique. C’est une analogie pour la paramétrisation, pas l’affirmation que le réseau contiendrait littéralement des votes ou des compteurs de preuves.
Pour une relation plus précise, définissons la constante de normalisation :
\[Z(z)=\sum_{j=1}^{K}e^{z_j}.\]Dans tout cet article, log désigne le logarithme naturel. Nous avons alors :
Un logit est une log-probabilité plus un décalage partagé par tous les candidats d’une même distribution. Ce décalage dépend du vecteur complet des logits. Un logit isolé n’est donc ni une probabilité ni, directement, une log-probabilité.
Le Softmax ne découvre pas des probabilités cachées dans des nombres arbitraires. Nous le choisissons comme application des scores non contraints vers une distribution, puis nous entraînons les scores à travers cette application. Même un réseau non entraîné peut produire une distribution valide. Des logits égaux donnent par exemple :
\[\operatorname{softmax}(0,0,0)=\left(\frac13,\frac13,\frac13\right).\]Une initialisation aléatoire ne donne pas forcément des logits exactement égaux. Le point est que l’existence d’une distribution valide peut précéder l’existence de prédictions utiles. La normalisation ne garantit ni l’exactitude ni la calibration. Une probabilité de prochain token n’est pas non plus automatiquement la probabilité qu’une proposition soit vraie.
La première moitié du problème local est maintenant claire : les logits fournissent au modèle des coordonnées non contraintes, et le Softmax transforme ces coordonnées en une distribution valide. La question suivante est de comprendre pourquoi cette application possède précisément cette structure.
Les différences sont des rapports de probabilités
L’identité la plus informative du Softmax apparaît lorsqu’on compare deux candidats. Leur constante de normalisation s’annule :
\[\frac{p_i}{p_j}=e^{z_i-z_j}.\]De manière équivalente :
\[\boxed{z_i-z_j=\log\frac{p_i}{p_j}}\]Un avantage d’un point de logit signifie un rapport de probabilités égal à e, pas un point de pourcentage supplémentaire. Les autres candidats influencent les probabilités individuelles, mais pas ce rapport pairwise lorsque les deux logits restent fixes.
Avec seulement deux candidats, définissons :
\[\Delta=z_1-z_2.\]Alors :
\[p_1=\frac{e^\Delta}{e^\Delta+1}.\] \[p_2=1-p_1.\]Le graphique ci-dessous représente ces deux probabilités en fonction de la différence entre leurs logits. Des logits égaux donnent des probabilités égales. Une différence de 1 donne environ 0.7311 et 0.2689.
Déplacez le curseur pour comparer les probabilités. Ouvrir le graphique interactif · Source Marimo.
Dans le cas binaire seulement, la seconde probabilité est le complément de la première, donc :
\[z_1-z_2=\log\frac{p_1}{1-p_1}.\]C’est le log-odds au sens habituel. Avec davantage de classes, l’expression logarithme du rapport des probabilités de deux classes est moins ambiguë.
Pourquoi une exponentielle, et pourquoi cette base ?
Maintenant que les différences de scores ont une interprétation en termes de rapports de probabilités, nous pouvons examiner le choix de l’exponentielle. Une alternative évidente consiste à diviser les scores par leur somme. Avec des scores réels arbitraires, cela peut échouer immédiatement :
\[\frac{(-2,1,3)}{-2+1+3}=\left(-1,\frac12,\frac32\right).\]Les composantes somment à un, mais ce ne sont pas des probabilités. Le dénominateur pourrait aussi être nul.
Beaucoup de fonctions positives évitent ce problème. La positivité seule ne sélectionne donc pas l’exponentielle. La propriété plus intéressante concerne la manière dont le Softmax traite un décalage commun. Si a est une constante réelle quelconque et 𝟙 le vecteur composé uniquement de uns, alors :
\[\operatorname{softmax}(z+a\mathbf1)=\operatorname{softmax}(z).\]Chaque exponentielle reçoit en effet le même facteur :
\[e^{z_i+a}=e^a e^{z_i}.\]Ce facteur s’annule lors de la normalisation. Les scores (1, 2, 3) et (101, 102, 103) définissent donc la même distribution. Choisir d’ignorer une base commune des scores est une préférence de modélisation ; le fait que le Softmax respecte cette préférence est un fait algébrique.
Il existe ici une caractérisation concise, mais conditionnelle. Supposons que nous appliquions la même fonction continue et positive g à chaque score, puis que nous normalisions :
\[p_i=\frac{g(z_i)}{\sum_{j=1}^{K}g(z_j)}.\]Si tout décalage commun doit laisser les probabilités inchangées, alors, pour deux scores u et 0 :
\[\frac{g(u+a)}{g(a)}=\frac{g(u)}{g(0)}.\]En définissant
\[h(u)=\log\frac{g(u)}{g(0)},\]on obtient l’équation additive continue :
\[h(u+a)=h(u)+h(a).\]La continuité impose alors une fonction h linéaire, donc :
\[g(u)=C e^{\alpha u},\qquad C>0.\]Si l’on exige aussi qu’un score plus grand reçoive un poids plus grand, alors α > 0 ; C disparaît lors de la normalisation. L’exponentielle est donc distinguée à l’intérieur de cette construction et sous ces hypothèses, sans être la seule application concevable vers une distribution de probabilité.
La base est une autre question. Pour tout b > 1 :
\[b^u=e^{(\log b)u}.\]Changer de base revient à redimensionner les logits ; cela ne laisse pas inchangées les probabilités d’un vecteur de scores fixé. L’exponentielle naturelle et le logarithme naturel forment un couple pratique en calcul différentiel, mais la structure importante ici est la pondération exponentielle.
La température change l’échelle de cette relation. Pour une température positive τ :
\[p_i^{(\tau)}=\frac{e^{z_i/\tau}}{\sum_{j=1}^{K}e^{z_j/\tau}}.\]Ainsi :
\[\log\frac{p_i^{(\tau)}}{p_j^{(\tau)}}=\frac{z_i-z_j}{\tau}.\]Une température positive plus petite amplifie les différences non nulles ; une température plus grande les comprime. La température contrôle avec quelle force une différence de score devient un rapport de probabilités. Elle ne change pas quel score est le plus grand.
Le problème local est maintenant résolu : pour un préfixe donné, le modèle peut produire une distribution normalisée sur le prochain token. Mais les données linguistiques sont des séquences, pas des prédictions isolées. Comment une collection de distributions conditionnelles devient-elle la probabilité d’une séquence entière ?
II. Des probabilités conditionnelles aux probabilités de séquence
La probabilité conditionnelle est à l’origine de la règle de chaîne
Nous avons maintenant une distribution sur le prochain token. Dans une séquence, le contexte c est le préfixe déjà observé et le token y occupe la position courante. Le modèle conditionnel construit dans la première partie fournit donc les facteurs dont le modèle de séquence a besoin. Pour les combiner, revenons à la définition de la probabilité conditionnelle.
Soient A et B deux événements, avec une probabilité positive pour A. Par définition :
\[P(B\mid A)=\frac{P(A\cap B)}{P(A)}.\]Nous restreignons l’espace de probabilité à A, puis nous demandons quelle fraction appartient aussi à B. En réarrangeant :
\[P(A\cap B)=P(A)P(B\mid A).\]Par exemple, si A a une probabilité de 0.4 et que B a une probabilité conditionnelle de 0.25 sachant A, leur intersection a une probabilité de 0.1. Aucune hypothèse d’indépendance n’a été utilisée.
Pour une séquence de longueur fixe, notons T sa longueur. Écrivons les valeurs observées des tokens x₁, …, x_T et définissons le préfixe :
\[x_{<t}=(x_1,\ldots,x_{t-1}).\]On applique de manière répétée la même identité de probabilité conditionnelle aux préfixes, en supposant que les préfixes sur lesquels on conditionne ont une probabilité positive :
\[P(x_{1:T})=P(x_{1:T-1})P(x_T\mid x_{1:T-1}).\]En développant récursivement :
\[\boxed{P(x_{1:T})=\prod_{t=1}^{T}P(x_t\mid x_{<t})}\]Le premier facteur est la probabilité du premier token, avec un préfixe vide. La notation abrège les probabilités que des variables aléatoires token prennent précisément ces valeurs.
La règle de chaîne ne requiert pas des tokens indépendants. Elle conserve leurs dépendances dans le conditionnement. L’indépendance nous permettrait de retirer ces préfixes, ce qui serait une autre affirmation.
Nous choisissons ensuite un modèle pour chaque distribution conditionnelle et les multiplions pour définir un modèle de séquence :
\[P_\theta(x_{1:T})=\prod_{t=1}^{T}P_\theta(x_t\mid x_{<t}).\]Pour T fixé, des distributions conditionnelles normalisées donnent une distribution jointe normalisée : sommer sur le dernier token donne un, puis sommer sur le token précédent redonne un, et ainsi de suite récursivement. Cette identité n’affirme pas que le modèle est égal à la distribution génératrice des données. Une génération de longueur variable devrait aussi tenir compte de la manière dont une séquence se termine ; nous gardons ici la longueur fixe.
Nous sommes passés d’une distribution conditionnelle locale à une probabilité pour une séquence entière. C’est le pont vers l’apprentissage : différents paramètres peuvent attribuer des probabilités différentes à la même séquence observée. Fixons l’observation et faisons varier les paramètres : la probabilité de séquence devient une vraisemblance.
III. Comment les observations façonnent-elles la distribution ?
Vraisemblance : fixer les observations
Le modèle peut maintenant attribuer des probabilités. Il nous manque encore un principe pour choisir ses paramètres.
Considérons une séquence hypothétique de dix lancers de pièce indépendants, avec huit faces et deux piles :
H H H T H H T H H H
Soit p la même probabilité d’obtenir face à chaque lancer. Pour ce jeu de données ordonné D particulier :
\[P_p(D)=p^8(1-p)^2,\qquad 0\leq p\leq1.\]Fixer p et considérer différents jeux de données possibles revient à regarder un modèle probabiliste. Fixer D déjà observé et comparer différentes valeurs de p transforme la même expression en fonction de vraisemblance :
\[L(p;D)=P_p(D).\]La probability fixe le modèle et fait varier les données ; la likelihood fixe les données et fait varier les paramètres. La vraisemblance n’est pas une distribution de probabilité sur les paramètres et ne nous dit pas directement quelle est la probabilité qu’une valeur de paramètre soit vraie.
Le maximum de vraisemblance préfère la valeur du paramètre qui attribue la plus grande vraisemblance aux observations fixées :
\[\widehat p\in\operatorname*{arg\,max}_{p\in[0,1]}L(p;D).\]Le graphique rend visible le sens de cette comparaison. Nous nous déplaçons sur l’axe du paramètre tout en gardant les mêmes dix lancers.
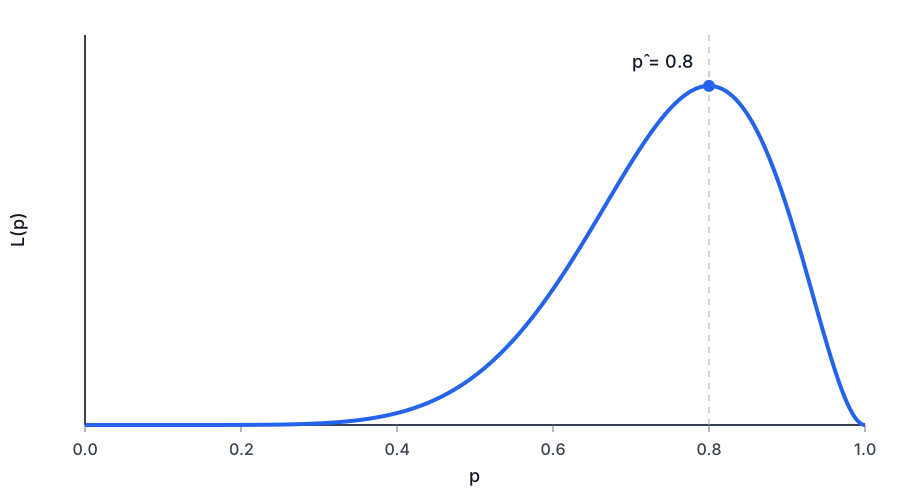
Le maximum de vraisemblance est d’environ 0.00671 : même avec le paramètre le mieux ajusté, cette séquence ordonnée particulière garde une faible probabilité. Le MLE compare les paramètres sur les mêmes données ; la vraisemblance n’a pas besoin d’être proche de un.
Fixer p à 1 rendrait les deux piles impossibles, donc la vraisemblance serait nulle. Observer davantage de faces ne signifie pas qu’il faut attribuer une probabilité de un à face.
Si nous ne conservions que le nombre de faces, et non leur ordre, un coefficient binomial apparaîtrait également. Ce facteur est indépendant de p et ne change pas la valeur du paramètre qui maximise la vraisemblance.
Le maximum de vraisemblance est un principe d’estimation, pas une conséquence imposée par le Softmax. Il ne garantit pas non plus un modèle qui généralise bien. Ici, nous construisons un objectif d’entraînement ; nous ne prouvons pas que son optimum sera nécessairement le meilleur prédicteur en dehors de l’échantillon.
Pourquoi le logarithme, et pourquoi le signe moins ?
Pour des nombres positifs :
\[\log(ab)=\log a+\log b.\]Comme le logarithme naturel est strictement croissant, le prendre préserve les paramètres qui maximisent la vraisemblance partout où celle-ci est positive :
\[\operatorname*{arg\,max}_\theta L(\theta;D)=\operatorname*{arg\,max}_\theta\log L(\theta;D).\]Une vraisemblance nulle peut recevoir une log-vraisemblance égale à moins l’infini par convention limite. Pour la pièce, lorsque p est strictement à l’intérieur de l’intervalle :
\[\log L(p;D)=8\log p+2\log(1-p).\]En dérivant et en annulant la dérivée :
\[\frac{8}{p}-\frac{2}{1-p}=0.\]Donc :
\[\widehat p=\frac8{10}=0.8.\]La dérivée seconde est négative sur tout l’intervalle et la vraisemblance vaut zéro aux deux extrémités :
\[\frac{d^2}{dp^2}\log L(p;D)=-\frac8{p^2}-\frac2{(1-p)^2}<0.\]Il s’agit donc de l’unique maximum. Dans cet exemple de Bernoulli, le MLE retrouve la fréquence empirique.
Le logarithme aide aussi numériquement : un produit de nombreuses petites probabilités peut subir un underflow, alors que nous pouvons additionner directement leurs logarithmes sans former d’abord ce produit. Prendre le logarithme après qu’un produit a déjà été arrondi à zéro ne permet pas de récupérer l’information perdue.
Enfin, une maximisation peut être réécrite comme une minimisation en changeant le signe :
\[\mathcal L_{\mathrm{NLL}}(\theta;D)=-\log L(\theta;D).\]C’est la negative log-likelihood. Le logarithme transforme les produits en sommes ; le signe moins transforme la maximisation en minimisation.
Pour un résultat observé auquel le modèle attribue une probabilité p, la contribution vaut :
\[\ell(p)=-\log p,\qquad 0<p\leq1.\]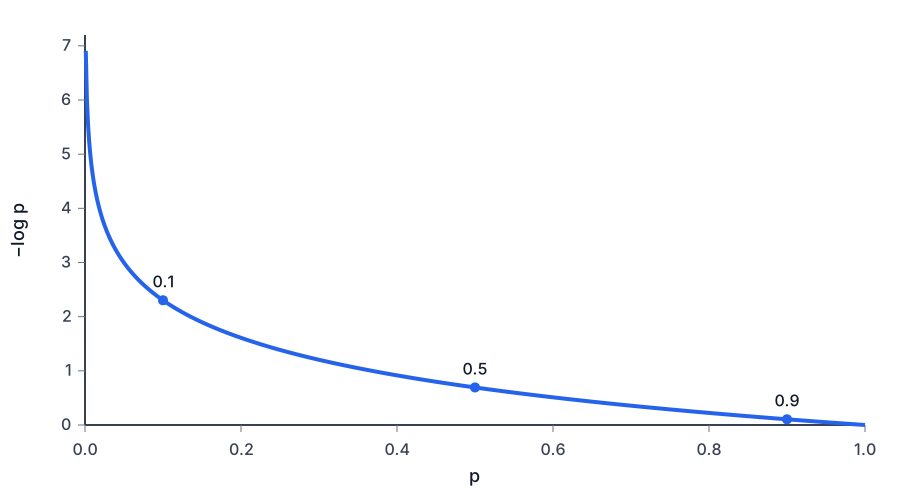
La courbe est tracée de p = 0.001 à p = 1. En p = 0, la perte n’a pas de valeur finie. Les probabilités indiquées 0.1, 0.5 et 0.9 correspondent à des pertes d’environ 2.303, 0.693 et 0.105.
Une forte probabilité attribuée donne une petite perte. Une probabilité minuscule donne une grande perte. La courbe décrit la pénalité d’entraînement ; elle ne constitue pas une garantie supplémentaire que la prédiction soit calibrée.
Recomposer la chaîne : l’objectif du modèle de langage
L’exemple de la pièce illustrait le maximum de vraisemblance avec un seul paramètre. Un modèle de langage applique le même principe, mais sa probabilité de séquence est déjà décomposée en facteurs de prochain token. Nous pouvons maintenant substituer directement la règle de chaîne dans la vraisemblance du jeu de données.
Prenons N séquences d’entraînement, toujours de longueur fixe T, et conservons les séquences répétées comme des observations répétées :
\[D=\left(x_{1:T}^{(1)},\ldots,x_{1:T}^{(N)}\right).\]Les modéliser comme des tirages indépendants d’un même modèle de séquence donne :
\[L(\theta;D)=\prod_{n=1}^{N}P_\theta\left(x_{1:T}^{(n)}\right).\]La règle de chaîne donne ensuite :
\[L(\theta;D)=\prod_{n=1}^{N}\prod_{t=1}^{T}P_\theta\left(x_t^{(n)}\mid x_{<t}^{(n)}\right).\]Le produit extérieur utilise une hypothèse d’indépendance entre exemples. Le produit intérieur utilise la règle de chaîne à l’intérieur d’une séquence. Ce n’est pas la même hypothèse écrite deux fois.
En prenant l’opposé du logarithme :
\[\boxed{\mathcal L_{\mathrm{NLL}}(\theta;D)=-\sum_{n=1}^{N}\sum_{t=1}^{T}\log P_\theta\left(x_t^{(n)}\mid x_{<t}^{(n)}\right)}\]Chaque position fournit un préfixe observé et le token qui l’a suivi. Le modèle prédit une distribution complète ; la loss sélectionne la probabilité attribuée au token observé. Le fait d’observer cats une fois ne signifie pas que dogs était impossible.
Revenons aux cinq phrases du début. Notons c leur contexte commun, « I like ». Si nous modélisons leurs prochains tokens observés comme conditionnellement indépendants sachant c et θ, la vraisemblance conditionnelle vaut :
\[L_{\mathrm{toy}}(\theta;c) = P_\theta(\mathrm{cats}\mid c)^3 P_\theta(\mathrm{dogs}\mid c) P_\theta(\mathrm{pizza}\mid c)\]Dans notre tableau illustratif, cats recevait une probabilité d’environ 0.0900. Chaque occurrence de cats apporte donc approximativement
\[-\log P_\theta(\mathrm{cats}\mid c)\approx2.408\]à la log-vraisemblance négative. En combinant les cinq observations, nous obtenons :
\[-\log L_{\mathrm{toy}}(\theta;c)\approx9.038\]Il s’agit d’un calcul à partir des probabilités illustratives, pas d’un résultat d’entraînement. Les comptes, les probabilités du Softmax et l’objectif d’apprentissage concernent désormais les mêmes observations. Les observations contraignent la distribution dans son ensemble ; toutes les probabilités ne peuvent pas augmenter à la fois.
Comme ces probabilités proviennent du Softmax, la NLL d’un token effectivement observé s’écrit aussi directement en fonction des logits :
\[-\log P_\theta(y=i\mid c) = \log\!\left(\sum_{j=1}^{K}e^{z_{\theta,j}(c)}\right) -z_{\theta,i}(c)\]Cette formule est une identité algébrique pour le log-Softmax négatif, pas un nouveau principe d’apprentissage. Elle éclaire aussi l’intérêt des implémentations qui calculent directement les log-probabilités.
Sous ce modèle et cette loss, l’entraînement next-token est l’entraînement par maximum de vraisemblance de séquence, écrit comme une somme de termes locaux. Diviser par le nombre fixe de tokens prédits redimensionne l’objectif sans changer ses minimiseurs. Nous n’avons pas encore dérivé l’optimiseur ni promis qu’il trouverait un optimum global.
L’argument entier peut maintenant se lire de gauche à droite :
\[\begin{aligned} z_\theta(c)&\xrightarrow{\text{Softmax}}P_\theta(y\mid c)\\ P_\theta(x_{1:T})&=\prod_{t=1}^{T}P_\theta(x_t\mid x_{<t})\\ L(\theta;D)&=P_\theta(D)\\ \mathcal L_{\mathrm{NLL}}(\theta;D)&=-\log L(\theta;D) \end{aligned}\]Cet objectif fournira ensuite le signal utilisé pour mettre à jour θ ; le mécanisme d’optimisation lui-même viendra plus tard dans la série. Le Softmax fournit la distribution locale ; la règle de chaîne transforme les conditionnelles locales en probabilité de séquence ; la vraisemblance fait de cette probabilité une fonction des paramètres ; la log-vraisemblance négative transforme enfin ce principe d’estimation en loss.
Note d’implémentation : Softmax stable
La chaîne conceptuelle est complète à ce stade. Un détail numérique mérite d’être séparé de l’argument principal. L’invariance par translation du Softmax permet de soustraire le plus grand logit avant l’exponentiation. Pour des entrées finies en float32 ou float64, avec un dernier axe non vide, cette implémentation pédagogique gère aussi les batchs :
import torch

def softmax_stable(x: torch.Tensor) -> torch.Tensor:
    """Normalize finite float32/float64 logits along a nonempty last axis."""
    max_x = x.max(dim=-1, keepdim=True).values
    shifted_x = x - max_x

    exp_x = torch.exp(shifted_x)
    row_sums = exp_x.sum(dim=-1, keepdim=True)

    return exp_x / row_sums
Le tenseur renvoyé par .values contient les maxima plutôt que leurs indices. Conserver cette dimension permet à la soustraction de se diffuser par broadcasting le long de l’axe des candidats. En arithmétique exacte, cela calcule le même Softmax ; en virgule flottante, cela évite des arguments exponentiels positifs très grands. Des poids extrêmement faibles peuvent toujours subir un underflow.
Si l’opération suivante est un logarithme, calculer séparément log(softmax(x)) peut encore perdre de l’information à cause de ces probabilités minuscules. log_softmax de PyTorch calcule directement les log-probabilités avec une formulation numériquement plus stable.3 L’équivalence mathématique ne rend pas deux implémentations en virgule flottante également fiables.
Le projet compagnon llm-from-first-principles est l’endroit où je travaille ce genre de détails d’implémentation.
Où en sommes-nous ?
La distinction à retenir est simple : la paramétrisation rend une distribution disponible ; l’objectif d’apprentissage nous dit comment les observations doivent la façonner.
Une expression mérite maintenant qu’on la regarde de nouveau :
\[-\log p.\]Jusqu’ici, elle est apparue à partir de la vraisemblance et d’une transformation pratique. Pourquoi l’appelle-t-on aussi surprisal, ou auto-information ? Et que change le fait de la moyenner sur une distribution plutôt que de l’évaluer pour une seule observation ?
C’est là que commence l’article suivant.
-
Yoshua Bengio, Réjean Ducharme, Pascal Vincent et Christian Jauvin. A Neural Probabilistic Language Model. Journal of Machine Learning Research, 3:1137–1155, 2003. L’article discute la sparsité des n-grammes et l’apprentissage conjoint de représentations distribuées avec un modèle probabiliste. ↩
-
Tomas Mikolov, Ilya Sutskever, Kai Chen, Greg Corrado et Jeffrey Dean. Distributed Representations of Words and Phrases and their Compositionality, 2013. Voir la section 2 pour les vecteurs de mots d’entrée et de sortie et les différents objectifs d’entraînement. ↩
-
Documentation PyTorch : torch.nn.functional.log_softmax. La remarque numérique concerne l’évaluation séparée du Softmax puis du logarithme. ↩