概率到底从哪里来?
First Principles of LLMs & RL · Article 01 · 为什么重新学习?
写作说明:本文的想法和初始草稿材料来自我本人;ChatGPT 协助了结构整理、文字编辑与翻译。
从观测到 Softmax,再到最大似然
我理解概率链式法则怎么展开。真正让我停下来的,是代数之前的一个问题:里面的概率,最初到底从哪里来?
训练数据给我们的是发生过的事情:一句话、一个标签、某个前缀之后出现的 token。语言模型却要给可能发生的事情分配概率。对于每一种可能的续写,数据并没有预先给它附上一份概率。
这里其实有两个问题。怎样把网络的输出构造成一个概率分布?又怎样根据观测,判断哪一种分布更合适?
Softmax 开始回答前一个问题,最大似然为后一个问题提供学习原则。概率链式法则则把它们在 token 和序列两个层面的描述接起来。
观测、计数,以及共享参数
先看五句话。为了简化,这个例子暂时把每个单词当作一个 token:
I like cats
I like dogs
I like cats
I like pizza
I like cats
在 I like 后面,cats 出现三次,dogs 和 pizza 各出现一次。按照这个顺序,经验条件分布就是:
帽子记号表示根据样本构造的估计。观测是这五句话;经验分布是我们根据它们整理出来的一种描述。 它并不是语言生成规律的完整答案。
这种数续写次数的做法,更接近基于计数的语言模型,而不是 Word2Vec。例如,用 C(u,v) 记录 token v 紧接在 token u 后面的次数,用 C(u) 记录后面还有 token 的 u 的出现次数,那么一个未经平滑的 bigram 估计就是:
\[\widehat P(v\mid u)=\frac{C(u,v)}{C(u)},\qquad C(u)>0.\]上下文越长,直接计数越容易稀疏:某个前缀可能只出现一次,甚至从未出现。计数模型可以通过平滑和较短上下文处理稀疏性;神经语言模型则学习分布式表示与概率函数,让不同样本之间能够共享信息。1
Word2Vec 同样从词与上下文的观测中学习向量参数。所谓 静态 embedding,是指使用时一个词的查表向量不会随所在句子改变,而不是说向量是一张出现次数表;它在训练期间仍然会更新。Skip-gram 学习输入和输出两套词表示,negative sampling 是其训练方式之一。2
对于这里的语言模型,用 c 表示上下文,y 表示候选的下一个 token,θ 表示全部模型参数。我们想得到一个函数:
\[P_\theta(y\mid c).\]共享参数的意思是,不同上下文使用同一套参数,而不是得到相同输出。 一条样本对参数的更新,也会影响其他样本经过这些参数时的计算。这为泛化提供了可能,但不保证泛化一定良好。
共享和初始化是两件事。本文考虑从头训练:权重矩阵按照选定的方式随机初始化,其他一些参数则可以从零或一等固定值开始。参数共享在训练之前就已经由架构规定好了。微调不同,它从已经学过的参数出发。
Logit 到底是什么?
把 logit 叫作 score,还留下了一个问题:它到底在给什么打分?
假设上下文已经被转成一个 d 维隐藏向量 h。对于候选 token i,输出层可以计算:
\[z_i=w_i^\top h+b_i.\]这里 wᵢ 是一个学得的 d 维向量,bᵢ 是标量偏置。词表中有 K 个候选 token,就得到:
\[z=(z_1,\ldots,z_K)\in\mathbb R^K.\]这些就是 logits。到这一步,它们仍然只是没有取值约束的实数。它们并没有预先规定的“真实程度”“信心”或“频率”单位。它们的概率含义,来自我们选择怎样使用这组数。
一种有用的选择,是把每个 logit 当作 对数权重,log-weight。取指数,得到正权重:
\[a_i=e^{z_i}.\]再把这些权重归一化,得到一个 categorical distribution:
\[p_i=\frac{e^{z_i}}{\sum_{j=1}^{K}e^{z_j}}.\]这就是 Softmax。对于由有限实数组成的有限向量,在精确运算中,它给出的概率严格为正,而且总和为一。一般的概率分布允许零概率;有限 logits 的 Softmax 表示的是其中严格为正的部分。
一个小例子可以把转换过程摆出来。下面的数值经过四舍五入,但来自同一组 logits:
| 候选结果 | Logit | 取 exp 后的正权重 | 归一化后的概率 |
|---|---|---|---|
| A | 0 | 1.0000 | 0.0900 |
| B | 1 | 2.7183 | 0.2447 |
| C | 2 | 7.3891 | 0.6652 |
可以把它想成按权重分配一笔固定预算。权重本身不必加起来等于一,但各自占总预算的份额会。Logits 则是在对数尺度上记录这些权重。这个类比帮助理解参数化方式,并不是说网络里面真的存在票数或证据计数器。
更精确地说,先定义归一化常数:
\[Z(z)=\sum_{j=1}^{K}e^{z_j}.\]本文所有 log 都使用自然对数,于是:
\[\log p_i=z_i-\log Z(z).\]一个 logit,等于对应的对数概率加上同一分布内所有候选共享的偏移量。 这个偏移量依赖整个 logit 向量。因此,单独一个 logit 既不是概率,也不直接等于对数概率。
Softmax 并不是从任意数字里面发现了隐藏的概率。我们选择它作为从无约束分数到分布的映射,再通过这个映射训练分数。即使网络尚未学习,也已经能够给出合法分布。例如,相等的 logits 会得到:
\[\operatorname{softmax}(0,0,0)=\left(\frac13,\frac13,\frac13\right).\]随机初始化不一定给出完全相等的 logits。这里要说明的是:合法的分布可以先于有用的预测而存在。 归一化既不保证准确,也不保证校准。下一个 token 的概率,更不自动等于一句陈述为真的概率。
为什么是指数函数,又为什么用这个底数?
一个直观的替代方案,是直接把分数除以总和。对于任意实数,这很快就会出问题:
\[\frac{(-2,1,3)}{-2+1+3}=\left(-1,\frac12,\frac32\right).\]结果加起来等于一,却不是概率。分母也可能为零。
很多正值函数都能避免这个问题,所以“把数字变成正数”不足以选出指数函数。更有意思的是 Softmax 如何处理共同偏移。令 a 为任意实数常数,𝟙 为全一向量,那么:
\[\operatorname{softmax}(z+a\mathbf1)=\operatorname{softmax}(z).\]因为每个指数项都会得到同一个因子:
\[e^{z_i+a}=e^a e^{z_i}.\]归一化时,这个公共因子被消掉。因此,分数 (1, 2, 3) 与 (101, 102, 103) 定义的是同一个分布。选择忽略统一的分数基线,是我们希望模型具有的性质;Softmax 满足这个性质,则是代数事实。
这里还能得到一个带条件的刻画。假设我们先对每个分数使用同一个连续正值函数 g,再归一化:
\[p_i=\frac{g(z_i)}{\sum_{j=1}^{K}g(z_j)}.\]要求它对任意共同平移保持不变,只考虑两个分数 u 和 0,就必须满足:
\[\frac{g(u+a)}{g(a)}=\frac{g(u)}{g(0)}.\]定义辅助函数:
\[h(u)=\log\frac{g(u)}{g(0)}.\]前面的关系变成:
\[h(u+a)=h(u)+h(a).\]连续的可加函数是线性的:可加性先确定有理数处的取值,再通过连续性扩展到实数。因此:
\[g(u)=C e^{\alpha u},\qquad C>0.\]如果再要求较高的分数对应较高的权重,就需要 α > 0。常数 C 会在归一化中消掉。
指数函数是在这种构造和这些假设之下被选出来的。Softmax 并不是通向概率分布的唯一可能映射。
底数又是另一件事。对于任意 b > 1:
\[b^u=e^{(\log b)u}.\]换底数,相当于缩放 logits;不是说同一组分数的概率会保持不变。自然指数与自然对数在微积分中配合方便,但这里真正关键的是指数加权的结构。
分数之差,对应概率之比
Softmax 最有解释力的关系,来自两个候选之间的比较。它们的归一化常数会消掉:
\[\frac{p_i}{p_j}=e^{z_i-z_j}.\]等价地:
\[\boxed{z_i-z_j=\log\frac{p_i}{p_j}}\]Logit 高出一个单位,意味着概率之比是 e 倍,而不是概率多出一个百分点。 在这两个 logits 固定时,其他候选会影响它们各自的概率,但不会改变这个成对比值。
只有两个候选时,定义:
\[\Delta=z_1-z_2.\]那么:
\[p_1=\frac{e^\Delta}{e^\Delta+1}.\] \[p_2=1-p_1.\]下面的图以差值为横轴,画出两个结果各自的概率。相等的 logits 对应相等的概率;差值为 1 时,两个概率约为 0.7311 和 0.2689。
拖动滑块,比较两个概率的变化。单独打开交互图 · Marimo 源代码。
只有在二分类中,第二个概率才正好是第一个的补,因此:
\[z_1-z_2=\log\frac{p_1}{1-p_1}.\]这就是通常所说的 log-odds,对数几率。类别更多时,使用“成对的对数概率比”更不容易产生歧义。
Temperature 改变的是这个关系的尺度。对于正温度 τ:
\[p_i^{(\tau)}=\frac{e^{z_i/\tau}}{\sum_{j=1}^{K}e^{z_j/\tau}}.\]于是:
\[\log\frac{p_i^{(\tau)}}{p_j^{(\tau)}}=\frac{z_i-z_j}{\tau}.\]较小的正温度放大非零差值的作用,较大的温度压缩它。温度控制的是:一个分数差会多强地体现为概率比。 它不改变哪个分数最大。
链式法则从条件概率而来
现在,我们有了下一个 token 的分布。要给整个序列分配概率,先回到条件概率本身。
令 A 和 B 为两个事件,并且 A 的概率为正。条件概率定义为:
\[P(B\mid A)=\frac{P(A\cap B)}{P(A)}.\]我们把注意范围缩到 A 内部,再问其中有多大比例同时属于 B。整理后得到:
\[P(A\cap B)=P(A)P(B\mid A).\]例如,A 的概率为 0.4,而在 A 发生的条件下,B 的概率为 0.25,那么它们同时发生的概率就是 0.1。这里没有使用独立性假设。
对于固定长度的序列,用 T 表示长度,用 x₁、…、x_T 表示观察到的各个 token 值,并定义前缀记号:
\[x_{<t}=(x_1,\ldots,x_{t-1}).\]在作为条件的前缀概率为正时,把同一个条件概率关系反复用于前缀:
\[P(x_{1:T})=P(x_{1:T-1})P(x_T\mid x_{1:T-1}).\]递归展开,就得到:
\[\boxed{P(x_{1:T})=\prod_{t=1}^{T}P(x_t\mid x_{<t})}\]第一个因子对应空前缀,也就是第一个 token 的概率。这里简写的是 token 随机变量恰好取到这些具体值的概率。
链式法则不要求 tokens 独立,而是把依赖关系保留在条件里面。 独立性允许我们去掉这些前缀,那是另外一个命题。
我们为每一步的条件分布选择模型,再把它们相乘,定义序列模型:
\[P_\theta(x_{1:T})=\prod_{t=1}^{T}P_\theta(x_t\mid x_{<t}).\]对于固定 T,归一化的条件分布会给出归一化的联合分布:先对最后一个 token 求和,结果为一;再对倒数第二个 token 求和,同样如此,逐步向前即可。这个恒等式没有声称模型已经等于数据生成分布。可变长度生成还需要考虑序列如何结束,本文先把长度固定下来。
似然:把观测固定下来
模型现在可以分配概率,但我们还需要一个选择参数的原则。
设想十次独立的硬币投掷,结果是八次正面、两次反面:
H H H T H H T H H H
令每次投掷的正面概率都是 p。对于这份保留了顺序的具体数据 D:
\[P_p(D)=p^8(1-p)^2,\qquad 0\leq p\leq1.\]固定 p,考察不同的可能数据,这是概率模型。固定已经观察到的 D,比较不同的 p,同一个表达式就成为似然函数:
\[L(p;D)=P_p(D).\]Probability 固定模型、改变数据;likelihood 固定数据、改变参数。 似然不是参数上的概率分布,也不直接告诉我们某个参数值为真的概率。
最大似然偏好给这份固定观测分配最高似然的参数:
\[\widehat p\in\operatorname*{arg\,max}_{p\in[0,1]}L(p;D).\]下面的图把这个比较方向画了出来。沿横轴移动的是参数,十次投掷的结果始终没有变。
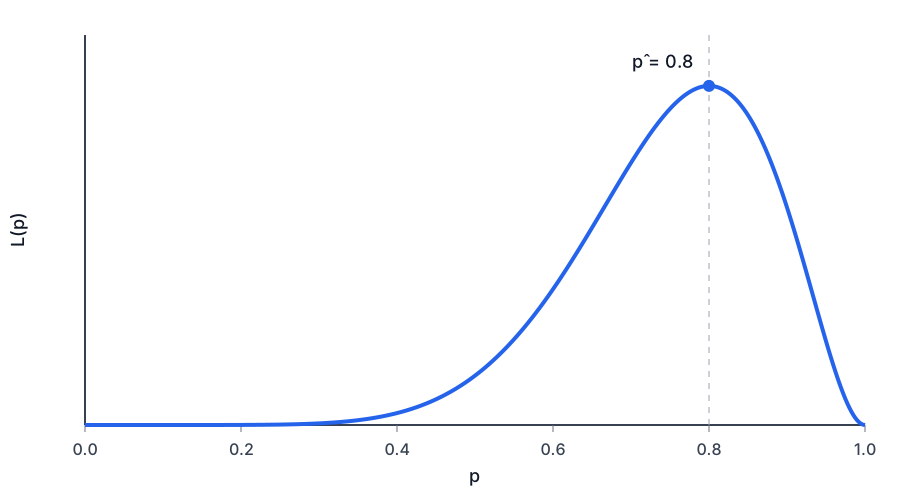
纵轴数值很小,是因为它表示一条具体有序序列的概率。MLE 比较的是同一份数据下的候选参数,并不要求最高似然接近一。
如果把 p 设为 1,两次反面就不可能发生,似然反而是零。正面出现更多,不意味着要给正面概率一。
如果只记录正面次数,不记录顺序,还会出现一个二项式系数。这个因子与 p 无关,因此不会改变最大值所在的参数。
最大似然是一种估计原则,不是被 Softmax 强制推出来的结论。 它也不保证模型一定泛化良好。这里构造的是训练目标,而不是证明它的最优解一定是样本之外最好的预测器。
为什么取对数,又为什么加负号?
对于正数:
\[\log(ab)=\log a+\log b.\]自然对数严格递增,所以在似然为正的地方,取对数会保留使其最大的参数:
\[\operatorname*{arg\,max}_\theta L(\theta;D)=\operatorname*{arg\,max}_\theta\log L(\theta;D).\]对于零似然,可以按极限把对数似然记为负无穷。在硬币例子中,当 p 严格位于零和一之间时:
\[\log L(p;D)=8\log p+2\log(1-p).\]求导并令导数为零:
\[\frac{8}{p}-\frac{2}{1-p}=0.\]因此:
\[\widehat p=\frac8{10}=0.8.\]二阶导数在这个区间内严格为负,而两个端点的似然为零:
\[\frac{d^2}{dp^2}\log L(p;D)=-\frac8{p^2}-\frac2{(1-p)^2}<0.\]所以这是唯一的最大值。在这个 Bernoulli 例子中,MLE 恢复了经验频率。
取对数还有计算上的好处:很多小概率相乘可能下溢,但我们可以直接累加它们的对数,不先形成那个乘积。如果乘积已经舍入成零,再取 log,也恢复不了丢失的信息。
最后,一个最大化问题可以通过改变符号写成最小化问题:
\[\mathcal L_{\mathrm{NLL}}(\theta;D)=-\log L(\theta;D).\]这就是 Negative Log-Likelihood,负对数似然。对数把乘积变成和;负号把最大化变成最小化。
对于一个被分配了概率 p 的实际观测结果,它贡献的损失是:
\[\ell(p)=-\log p,\qquad 0<p\leq1.\]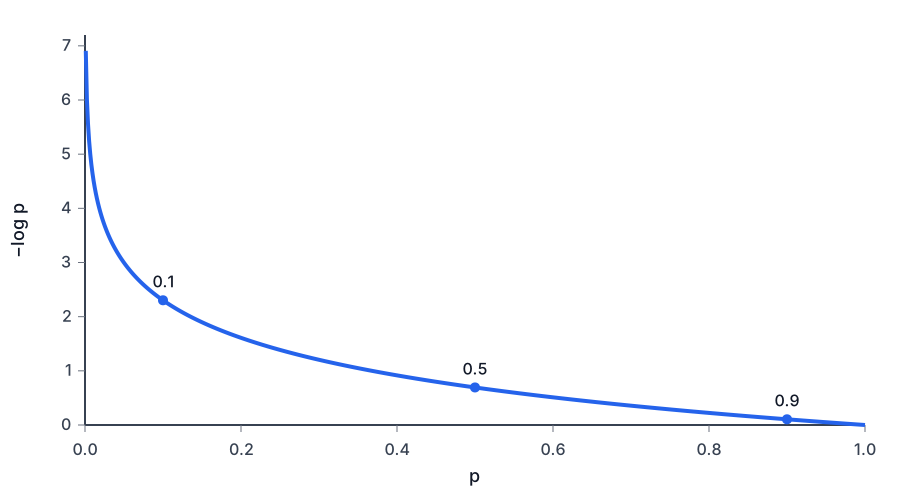
曲线绘制范围从 p = 0.001 到 p = 1。在 p = 0 处,损失没有有限值。图中标出的概率 0.1、0.5 和 0.9,对应的损失约为 2.303、0.693 和 0.105。
分配的概率高,损失小;分配的概率极低,损失大。曲线描述的是训练惩罚,并不是关于模型已经校准的额外保证。
语言模型的目标,以及它的实现
考虑 N 条训练序列,仍然使用前面固定的长度 T。重复出现的序列保留为重复观测:
\[D=\left(x_{1:T}^{(1)},\ldots,x_{1:T}^{(N)}\right).\]把它们建模为同一个序列模型下的独立样本,得到:
\[L(\theta;D)=\prod_{n=1}^{N}P_\theta\left(x_{1:T}^{(n)}\right).\]再使用链式法则:
\[L(\theta;D)=\prod_{n=1}^{N}\prod_{t=1}^{T}P_\theta\left(x_t^{(n)}\mid x_{<t}^{(n)}\right).\]外层乘积使用样本之间的独立性假设;内层乘积使用同一序列内的链式法则。 这不是把同一个假设写了两次。
取负对数:
\[\boxed{\mathcal L_{\mathrm{NLL}}(\theta;D)=-\sum_{n=1}^{N}\sum_{t=1}^{T}\log P_\theta\left(x_t^{(n)}\mid x_{<t}^{(n)}\right)}\]每个位置提供一个观测到的前缀,以及紧接其后的 token。模型预测完整分布;损失取出其中分配给实际 token 的那个概率。一次观察到了 cats,不意味着 dogs 不可能。
在这个模型和损失下,next-token training 就是把序列最大似然训练写成局部项的和。除以固定的预测 token 数量,只是缩放目标,不改变最小值所在。我们还没有推导优化器,也没有承诺它一定找到全局最优解。
实现同样需要注意。Softmax 的平移不变性允许我们在取指数之前减去最大 logit。对于有限的 float32 或 float64 输入,且最后一个轴非空,下面这个教学实现也能处理批量数据:
import torch


def softmax_stable(x: torch.Tensor) -> torch.Tensor:
    """Normalize finite float32/float64 logits along a nonempty last axis."""
    max_x = x.max(dim=-1, keepdim=True).values
    shifted_x = x - max_x

    exp_x = torch.exp(shifted_x)
    row_sums = exp_x.sum(dim=-1, keepdim=True)

    return exp_x / row_sums
.values 取出最大值,而不是最大值的位置。保留这个维度,让减法可以沿候选轴广播。在精确运算中,它计算的是同一个 Softmax;在浮点运算中,它避免了很大的正指数参数。极小的权重仍然可能下溢。
如果下一步就是取对数,分别计算 log(softmax(x)) 仍然可能因为极小概率而丢失信息。PyTorch 的 log_softmax 使用数值性质更好的形式,直接计算对数概率。3 数学等价,并不意味着两种浮点实现同样可靠。
配套的 llm-from-first-principles 项目,是我逐步实现这些细节的地方。本文更想留下的区分是:参数化让模型能够表示一个分布;学习目标告诉我们怎样用观测去塑造它。
现在,有一个表达式值得重新看一眼:
\[-\log p.\]到目前为止,它来自似然和一种方便的变换。为什么它也被称为 surprisal,惊讶度,或者自信息?如果不只看一次观测,而是在整个分布上求平均,又会发生什么?
下一篇从这里开始。
-
Yoshua Bengio、Réjean Ducharme、Pascal Vincent 和 Christian Jauvin,A Neural Probabilistic Language Model,Journal of Machine Learning Research,3:1137–1155,2003。论文讨论了 n-gram 稀疏性,以及分布式表示与概率模型的联合学习。 ↩
-
Tomas Mikolov、Ilya Sutskever、Kai Chen、Greg Corrado 和 Jeffrey Dean,Distributed Representations of Words and Phrases and their Compositionality,2013。输入与输出词向量以及不同训练目标见第 2 节。 ↩
-
PyTorch 文档:torch.nn.functional.log_softmax。这里的数值注意事项针对把 Softmax 与对数分开计算的做法。 ↩