First Principles of LLMs & RL · Article 03 · Article précédent
Note de rédaction : les questions et le matériau du brouillon initial sont de moi. ChatGPT a contribué à la structure, à la révision, aux figures et à la traduction.
De l’approximation locale à la descente de gradient et à la rétropropagation
L’article précédent expliquait comment l’entropie croisée permet de mesurer l’erreur de prédiction d’un modèle. Mais calculer une perte ne modifie pas, à lui seul, les paramètres.
Un nombre nous dit à quel point la prédiction actuelle est mauvaise. Il ne précise ni quel paramètre augmenter, ni lequel diminuer, ni de combien.
Entre mesurer une erreur et modifier le modèle, il manque une description de la manière dont cette erreur varie.
C’est le fil de cet article. Que provoque une petite modification des paramètres ? Comment choisir une modification favorable ? Et comment obtenir ces sensibilités lorsque de nombreuses opérations séparent les paramètres de la perte ? Le développement de Taylor, la descente de gradient et la rétropropagation répondent successivement à ces questions.
1. Une valeur de perte n’indique pas de direction. Une dérivée, si.
Mettons provisoirement le réseau de côté. Supposons qu’il ne possède qu’un paramètre réel et que sa perte soit
\[L(\theta)=(\theta-3)^2.\]Quand le paramètre vaut 1 ou 5, la perte vaut 4 dans les deux cas. Pourtant, pour nous rapprocher du minimum, il faudrait augmenter le premier et diminuer le second. La valeur de la perte ne permet pas de distinguer ces situations.
La dérivée fournit l’information manquante :
\[L'(\theta)=2(\theta-3).\]Au point 1, elle vaut −4. Cela ne signifie pas que la perte est négative. Cela signifie qu’augmenter suffisamment peu le paramètre fait baisser la perte à cet endroit.
Cette interprétation découle presque directement de la définition de la dérivée. Notons δ une petite variation du paramètre :
\[L'(\theta) = \lim_{\delta\to0} \frac{L(\theta+\delta)-L(\theta)}{\delta}.\]Lorsque δ est suffisamment petit, la variation de perte s’approxime par
\[L(\theta+\delta) \approx L(\theta)+L'(\theta)\delta.\]Par exemple, partons de 1 et augmentons le paramètre de 0,01. L’approximation du premier ordre prévoit une perte de 3,96. Le calcul exact donne 3,9601.
L’approximation n’est pas exacte, mais elle décrit correctement l’effet de cette petite modification.
Une dérivée ne mesure pas l’erreur actuelle. Elle mesure la sensibilité locale de la perte à une variation d’un paramètre. Deux pertes égales peuvent correspondre à des sensibilités totalement différentes.
2. Taylor : reconstruire le voisinage à partir des dérivées
L’approximation précédente est déjà le développement de Taylor du premier ordre. Près d’un point, elle remplace la courbe par la droite possédant la même valeur et la même pente.
Une droite peut reproduire hauteur et pente. Pourrait-on aussi reproduire la courbure avec un polynôme ?
Notons f une fonction scalaire, a le point autour duquel nous développons et δ l’écart par rapport à ce point. Commençons par un polynôme quadratique :
\[p_2(\delta)=c_0+c_1\delta+c_2\delta^2.\]Imposons que sa valeur et ses deux premières dérivées en zéro égalent celles de f en a :
\[c_0=f(a),\qquad c_1=f'(a),\qquad 2c_2=f''(a).\]Nous obtenons
\[f(a+\delta) \approx f(a)+f'(a)\delta+\frac{f''(a)}{2}\delta^2.\]Le facteur un demi ne relève pas d’une convention arbitraire : dériver deux fois un terme quadratique produit un facteur 2, qu’il faut annuler pour faire correspondre les dérivées secondes. La même logique engendre les factorielles aux ordres supérieurs.
Plus généralement, si n est le degré maximal du polynôme et Rₙ le reste :
\[f(a+\delta) = \sum_{k=0}^{n}\frac{f^{(k)}(a)}{k!}\delta^k +R_n(\delta).\]Ici n est un entier positif ou nul et la dérivée d’ordre zéro est la fonction elle-même. L’égalité conserve le terme d’erreur. Elle ne devient une approximation utile que lorsque ce reste est contrôlé.
Si la dérivée d’ordre n+1 est continue sur l’intervalle étudié et si sa valeur absolue est bornée par M, le théorème de Taylor donne
\[|R_n(\delta)| \leq \frac{M}{(n+1)!}|\delta|^{n+1}.\]Sous ces hypothèses, réduire le déplacement permet de maîtriser l’erreur. Cela ne signifie pas que la série de Taylor infinie d’une fonction quelconque suffisamment régulière converge nécessairement vers cette fonction.1
Le but d’un développement de Taylor est de construire un modèle simple du comportement voisin à partir des dérivées en un point.
Prenons la fonction exponentielle au voisinage de zéro :
\[e^x\approx1+x+\frac{x^2}{2}.\]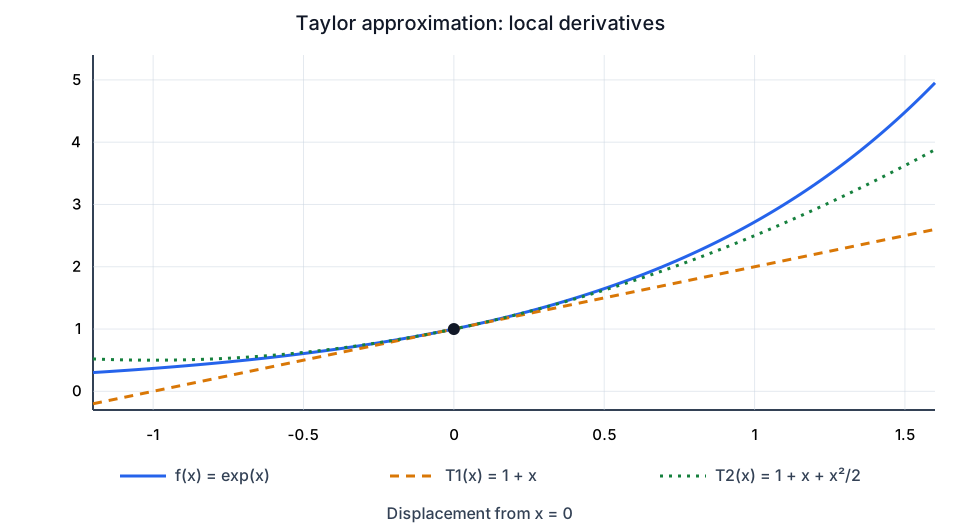
Les approximations reproduisent de plus en plus de dérivées au point choisi. Elles ne coïncident pas avec la fonction partout. L’abscisse représente le déplacement depuis zéro.
Pour x = 0,2, le premier ordre donne 1,2, le deuxième 1,22, et la valeur réelle vaut environ 1,2214. Pour x = 1, les mêmes approximations donnent 2 et 2,5, alors que la valeur réelle est proche de 2,7183.
J’ai choisi une fonction non quadratique pour cette figure. Pour une parabole, le développement du deuxième ordre restituerait exactement la fonction sur toute la droite : impossible alors d’illustrer la limite habituelle d’une approximation locale.
Revenons à l’apprentissage. Si cette approximation locale permet d’anticiper l’effet d’un petit changement, quel changement faut-il choisir ?
3. Pourquoi suivre le gradient négatif, et pourquoi choisir soigneusement le pas ?
Un réseau possède beaucoup de paramètres. Regroupons m paramètres réels en un vecteur noté en gras. Fixons provisoirement les données, les tirages aléatoires et le calcul en cours, afin de considérer la perte comme une fonction déterministe de ces paramètres.
Les dérivées partielles constituent le gradient :
\[g=\nabla L(\boldsymbol\theta) = \begin{bmatrix} \frac{\partial L}{\partial\theta_1}\\ \vdots\\ \frac{\partial L}{\partial\theta_m} \end{bmatrix}.\]En un point différentiable, l’approximation du premier ordre devient
\[L(\boldsymbol\theta+\Delta\boldsymbol\theta) -L(\boldsymbol\theta) \approx g^\top\Delta\boldsymbol\theta.\]Le terme de droite est un produit scalaire : chaque variation de paramètre est multipliée par sa sensibilité locale, puis les contributions sont additionnées. Le gradient permet donc d’évaluer un petit déplacement dans son ensemble.
Pour parler de direction de « descente la plus rapide », nous devons préciser comment comparer la longueur des directions. Utilisons la norme euclidienne et notons u un vecteur unitaire. L’inégalité de Cauchy–Schwarz donne
\[g^\top u\geq-\|g\|_2, \qquad \|u\|_2=1.\]Si le gradient est non nul, l’égalité est obtenue pour
\[u_*=-\frac{g}{\|g\|_2}.\]Parmi les petits déplacements de même longueur euclidienne, le gradient négatif donne le taux de diminution instantanée le plus élevé. Ce caractère « le plus rapide » dépend de la mesure de longueur : il ne constitue pas une propriété absolue indépendante des coordonnées.2
La descente de gradient élémentaire multiplie le gradient négatif par un taux d’apprentissage positif η :
\[\boldsymbol\theta_{t+1} = \boldsymbol\theta_t-\eta\nabla L(\boldsymbol\theta_t).\]En reportant cette proposition dans l’approximation du premier ordre :
\[L(\boldsymbol\theta-\eta g)-L(\boldsymbol\theta) \approx -\eta\|g\|_2^2.\]Le membre de droite est négatif lorsque g n’est pas nul. Il n’indique pourtant ce qui se passe que pour des pas suffisamment petits : l’approximation a été construite au point actuel, pas à tous les points qu’on pourrait atteindre.
Le gradient indique dans quelle direction faire un petit pas ; le taux d’apprentissage détermine la taille du pas réellement effectué.
Reprenons la parabole et partons de 1. La dérivée vaut −4, donc
\[\theta_{\mathrm{new}}=1+4\eta.\]| Taux η | Nouveau paramètre | Nouvelle perte | Comparaison à la perte initiale 4 |
|---|---|---|---|
| 0.10 | 1.4 | 2.56 | Diminue |
| 0.75 | 4.0 | 1.00 | Dépasse le minimum, mais diminue |
| 1.00 | 5.0 | 4.00 | Aucun progrès |
| 1.10 | 5.4 | 5.76 | Augmente |
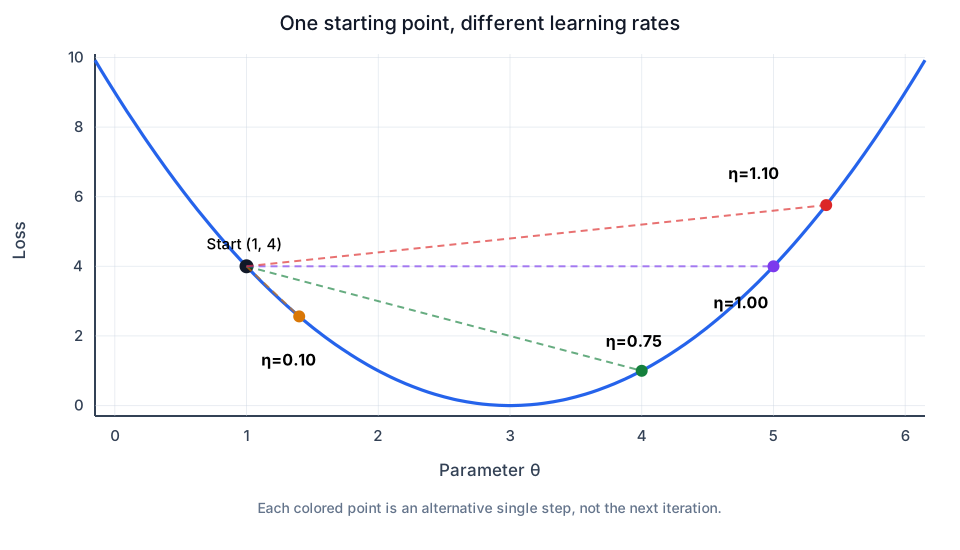
Les flèches comparent plusieurs mises à jour alternatives depuis un même point de départ. Elles ne représentent pas les itérations successives d’un entraînement, ni une trajectoire continue d’optimisation entre leurs extrémités.
Pour cette fonction quadratique, nous pouvons même trouver exactement la condition de diminution de l’erreur :
\[\theta_{t+1}-3=(1-2\eta)(\theta_t-3).\]Avec un taux constant strictement entre 0 et 1, l’erreur décroît. Pour η = 1, un point non optimal oscille entre deux positions ; au-delà de 1, la valeur absolue de l’erreur augmente. Cette plage dépend de la fonction particulière et ne constitue pas une règle générale pour entraîner des réseaux neuronaux.
La distinction entre optimisation locale et globale se trouve ici. Au point différentiable où le gradient est non nul, il existe un pas négatif suffisamment petit qui fait diminuer la perte. Cela ne garantit ni la convergence des itérations ni la convergence vers un minimum local. Un gradient nul peut aussi correspondre à un maximum local ou à un point selle.2
La convexité apporte une structure globale supplémentaire : pour une fonction convexe et différentiable sans contraintes, tout point de gradient nul est un minimum global. Il faut encore d’autres hypothèses pour qu’un algorithme donné trouve effectivement ce point. Dire que la descente de gradient « garantit au moins un minimum local » serait donc faux en général.
Jusqu’ici, nous avons supposé que le gradient était disponible. Or les paramètres ne produisent pas directement la perte : de nombreuses opérations interviennent entre eux. Comment obtenir toutes ces dérivées partielles ?
4. Rétropropagation : transmettre les sensibilités dans le calcul
Supposons qu’un paramètre passe d’abord par la fonction φ pour produire une valeur intermédiaire u, puis que la perte soit obtenue par la fonction f :
\[u=\phi(\theta),\qquad L=f(u).\]Une petite variation du paramètre modifie d’abord u, ce qui modifie ensuite la perte :
\[\Delta u\approx \phi'(\theta)\Delta\theta, \qquad \Delta L\approx f'(u)\Delta u.\]En combinant les deux relations puis en passant à la limite, on obtient la règle de dérivation en chaîne :
\[\frac{dL}{d\theta} = \frac{dL}{du}\frac{du}{d\theta}.\]Les sensibilités se multiplient le long d’un chemin de calcul parce que chaque étape amplifie, atténue ou inverse la variation produite par l’étape précédente.
Cette règle de chaîne n’est pas la règle de chaîne des probabilités de l’article 01. La première dérive une composition de fonctions ; la seconde factorise une loi jointe. Les deux procèdent par étapes, mais ce sont deux identités différentes.
Si un même paramètre influence la perte par plusieurs chemins, tous comptent. Leurs contributions s’additionnent lorsque les chemins se rejoignent.
La rétropropagation organise ces relations sur un graphe de calcul. La passe avant calcule les valeurs intermédiaires. En partant de la perte finale, on transmet ensuite les dérivées dans l’ordre inverse des dépendances. Les dérivées déjà calculées à un nœud partagé sont réutilisées, au lieu de recalculer un chemin complet depuis chaque paramètre.3
La rétropropagation ne consiste pas non plus à perturber chaque paramètre séparément et à exécuter une nouvelle passe avant pour estimer la pente. Ce serait une différence finie, utile pour vérifier un petit exemple. Ici, on dérive les opérations du graphe et on combine les règles par la dérivation en chaîne.
La rétropropagation calcule les gradients ; l’optimiseur se sert de ces gradients pour mettre les paramètres à jour. Un modèle ne change pas simplement parce que ses gradients ont été calculés.
Reprenons la distribution des deux premiers articles pour voir une mise à jour réelle.
5. Une mise à jour pour cats, dogs et pizza
Conservons le contexte « I like ». Cinq continuations observées ont donné la distribution empirique
\[P=(0.6,0.2,0.2).\]Les résultats sont, dans cet ordre : cats, dogs et pizza. Le modèle produit les logits z, puis la distribution Softmax à température 1 :
\[Q_k=\frac{e^{z_k}}{\sum_{j=1}^{3}e^{z_j}}.\]En gardant P fixe et en utilisant le logarithme naturel, définissons la log-vraisemblance négative moyenne comme fonction des logits :
\[\ell(z)=-\sum_{k=1}^{3}P_k\log Q_k.\]Cette moyenne compte dans notre exemple. La NLL totale des cinq observations, ainsi que son gradient, seraient cinq fois plus grandes. Avec un taux d’apprentissage inchangé, la mise à jour serait donc différente.
Développons le Softmax dans la perte, puis utilisons le fait que la somme des composantes de P vaut un :
\[\ell(z) = \log\left(\sum_{j=1}^{3}e^{z_j}\right) -\sum_{j=1}^{3}P_jz_j.\]La dérivée du premier terme par rapport au logit k vaut Qₖ ; celle du second vaut −Pₖ. D’où
\[\boxed{ \frac{\partial\ell}{\partial z_k}=Q_k-P_k }\]Cette relation est exacte dans le cadre indiqué : Softmax, cible fixe et logarithme naturel. Elle n’est pas une propriété de toute fonction de perte.
Reprenons les logits des deux précédents articles :
\[z=(0,1,2).\]Les probabilités et les gradients correspondants sont approximativement
\[Q\approx(0.090031,0.244728,0.665241),\] \[\nabla_z\ell\approx(-0.509969,0.044728,0.465241).\]Si nous pouvions modifier indépendamment les trois logits, un pas dans la direction du gradient négatif augmenterait le score de cats et diminuerait les deux autres. Notre souhait de mieux attribuer les probabilités aux observations devient une direction calculable.
Dans un véritable réseau, nous modifions généralement des paramètres partagés, et non des logits stockés indépendamment pour chaque contexte. Construisons donc un modèle à un seul paramètre scalaire entraînable :
\[z(\theta)=(2\theta,\theta+1,2).\]Ce modèle volontairement limité sert à comprendre un mécanisme. Il ne représente pas l’architecture d’un modèle de langage complet. À θ = 0, il reproduit les logits précédents.
Un même paramètre agit sur les scores de cats et dogs. Définissons la perte au niveau des paramètres :
\[L(\theta)=\ell(z(\theta)).\]La dérivation en chaîne impose d’additionner les contributions de tous les chemins :
\[\frac{dL}{d\theta} = \sum_{k=1}^{3} \frac{\partial\ell}{\partial z_k} \frac{dz_k}{d\theta}.\]À θ = 0,
\[\begin{aligned} \frac{dL}{d\theta} &=2(-0.509969\ldots) +1(0.044728\ldots) +0(0.465241\ldots)\\ &\approx-0.975210. \end{aligned}\]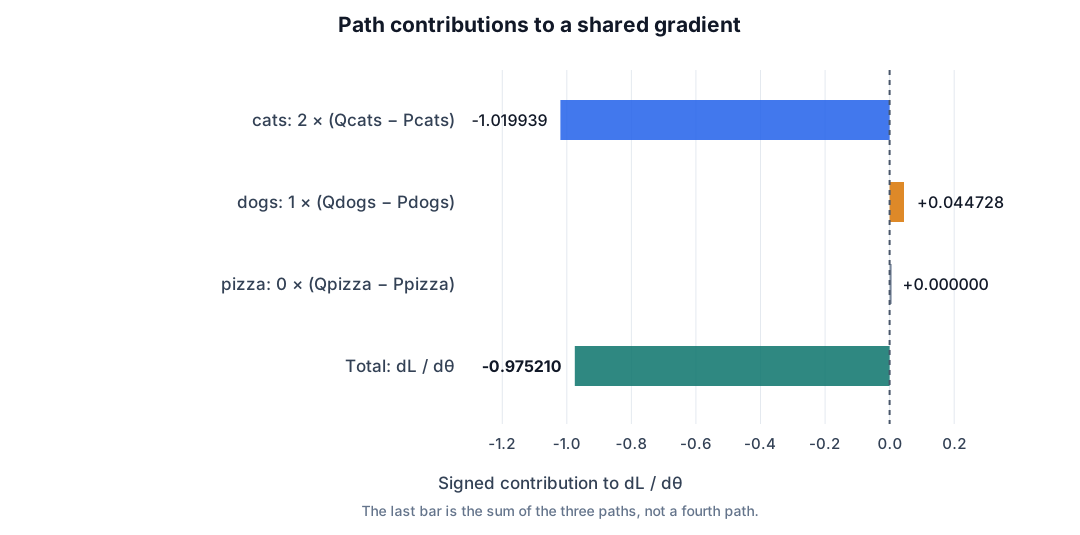
Les contributions portent des signes différents. La barre du bas représente leur somme, pas un quatrième chemin. Le logit de pizza ne dépend pas de θ ; sa dérivée locale vaut donc zéro.
Nous voyons concrètement comment les sensibilités se multiplient sur chaque chemin, puis s’additionnent lorsqu’elles rejoignent un même paramètre. Le chemin de cats favorise une augmentation du paramètre, celui de dogs une diminution. C’est la somme qui détermine la direction locale de mise à jour.
Choisissons un taux d’apprentissage de 0,5 et effectuons un pas :
\[\theta_{\mathrm{new}} =0-0.5(-0.975210\ldots) \approx0.487605.\]Recalculons les logits, les probabilités et la perte :
| Quantité | Avant | Après |
|---|---|---|
| θ | 0.000000 | 0.487605 |
| logit cats | 0.000000 | 0.975210 |
| logit dogs | 1.000000 | 1.487605 |
| logit pizza | 2.000000 | 2.000000 |
| Probabilité cats | 0.090031 | 0.183291 |
| Probabilité dogs | 0.244728 | 0.305965 |
| Probabilité pizza | 0.665241 | 0.510743 |
| NLL moyenne | 1.807606 | 1.389241 |
Un détail mérite attention. La probabilité initiale de dogs était déjà supérieure à sa cible empirique de 0,2. Après la mise à jour, elle augmente encore.
Aucune contradiction : un paramètre partagé influence plusieurs logits simultanément ; nous n’avons pas une commande indépendante pour chaque probabilité. La fonction de perte minimise la log-loss totale pondérée par P, pas l’erreur absolue de chaque probabilité séparément. Ce pas améliore la première sans rapprocher chaque classe de sa cible.
Le logit de pizza, lui, reste inchangé, mais sa probabilité évolue quand même : le dénominateur du Softmax dépend de tous les logits.
Une mise à jour peut diminuer la perte globale sans rapprocher, à chaque étape, toutes les probabilités prédites de leurs valeurs cibles.
Ce sont des calculs reproductibles sur un exemple spécifié, et non des résultats expérimentaux mesurés sur un entraînement.
6. Séparer le calcul du gradient et la mise à jour dans le code
Ce modèle minimal s’écrit directement en PyTorch avec des annotations de type :
import torch


def toy_logits(theta: torch.Tensor) -> torch.Tensor:
    """Map a scalar parameter to three shared logits."""
    return torch.stack((2.0 * theta, theta + 1.0, theta.new_tensor(2.0)))


def toy_loss(theta: torch.Tensor, target: torch.Tensor) -> torch.Tensor:
    """Return the average natural-log loss for a fixed target distribution."""
    log_probs = toy_logits(theta).log_softmax(dim=-1)
    return -(target * log_probs).sum()


target: torch.Tensor = torch.tensor([0.6, 0.2, 0.2], dtype=torch.float64)
theta: torch.Tensor = torch.tensor(0.0, dtype=torch.float64, requires_grad=True)
learning_rate: float = 0.5

loss_before = toy_loss(theta, target)
loss_before.backward()  # Compute gradients; theta is still zero.

if theta.grad is None:
    raise RuntimeError("The parameter gradient was not computed.")

with torch.no_grad():
    theta -= learning_rate * theta.grad  # Perform the parameter update.

theta.grad = None  # Do not accumulate this step's gradient into the next one.
loss_after = toy_loss(theta, target)

print(f"{loss_before.item():.6f} -> {loss_after.item():.6f}")
La sortie vérifiée est :
1.807606 -> 1.389241
backward() parcourt le graphe et accumule les dérivées dans l’attribut .grad du tenseur feuille. Il ne met pas θ à jour. Cette mise à jour est faite dans no_grad(), puis nous exécutons une nouvelle passe avant pour obtenir la nouvelle perte. Avant une nouvelle rétropropagation, il faut effacer les gradients que nous ne souhaitons pas accumuler.4
Certaines étapes de notre raisonnement utilisent des approximations ; d’autres non. Taylor approxime l’effet d’un déplacement fini par un polynôme local. La rétropropagation dans ce graphe d’opérations lisses calcule au contraire les dérivées au point courant en appliquant les règles de différentiation : elle ne devine pas les dérivées avec des tangentes. Les opérations en virgule flottante comportent bien sûr des erreurs numériques.3
Nous possédons enfin une boucle d’apprentissage : la passe avant produit la perte, la passe arrière les sensibilités, la règle de mise à jour modifie les paramètres, puis une nouvelle passe avant évalue le modèle modifié.
Nous n’avons pas obtenu une carte complète vers le meilleur modèle possible. Nous avons obtenu une procédure locale reproductible.
Les deux premiers articles expliquaient comment représenter une distribution et définir une perte. Celui-ci a montré comment cette perte peut agir sur des paramètres partagés. Mais notre exemple réduit encore au minimum le passage du contexte aux logits.
Le prochain article ouvrira précisément cette boîte : comment un token peut-il retrouver des informations utiles dans les tokens précédents, d’une manière que la même fonction de perte puisse entraîner ?
-
OpenStax, Calculus Volume 2, Taylor and Maclaurin Series. Il faut distinguer polynômes de Taylor, bornes du reste et convergence des séries infinies. ↩
-
Ian Goodfellow, Yoshua Bengio et Aaron Courville, Deep Learning, chapitre 4 : Numerical Computation, section 4.3. Les chiffres de la parabole sont calculés directement à partir de la fonction indiquée. ↩ ↩2
-
Atilim Gunes Baydin, Barak A. Pearlmutter, Alexey Andreyevich Radul et Jeffrey Mark Siskind, Automatic Differentiation in Machine Learning: a Survey, JMLR 18(153):1–43, 2018. Voir aussi PyTorch, Autograd mechanics. Nous ne discutons ici que des dérivées des opérations lisses, pas des conventions aux points non différentiables. ↩ ↩2
-
Documentation PyTorch, torch.autograd.backward et Autograd mechanics. ↩