First Principles of LLMs & RL · Article 04 · Article précédent
Note de rédaction : les questions et la direction éditoriale viennent de l’auteur. ChatGPT a aidé à la rédaction, aux vérifications mathématiques, aux figures, à la révision et à la traduction.
De la tokenisation aux embeddings appris et à la représentation des positions
Les trois premiers articles expliquaient comment un modèle produit des probabilités, comment une fonction de perte évalue ses prédictions et comment les gradients modifient ses paramètres. Pourtant, nous avions presque toujours considéré les entrées comme des nombres déjà disponibles. Nous pouvions chercher comment les modifier sans nous demander d’où ils venaient.
Sur l’écran, I like cats est du texte. Une multiplication matricielle, elle, manipule des valeurs numériques. Comment passer de l’un à l’autre et obtenir des nombres réellement utiles au modèle ?
Dire « un ordinateur ne comprend que des nombres, donc il faut des embeddings » ne suffit pas. Les identifiants des tokens sont déjà des nombres. Mais un identifiant dit quelle unité a été rencontrée, pas comment cette unité devrait être représentée. Il faut distinguer trois décisions : en quelles unités découper le texte, comment identifier ces unités et comment attribuer à ces identités une représentation qui peut être apprise.
C’est un meilleur point de départ qu’un nuage de points où des mots supposés proches seraient déjà regroupés.
1. Décider d’abord ce que lit le modèle
La tokenisation transforme un texte en une suite d’unités traitées par le modèle. Ces unités peuvent être des mots, des caractères, des sous-mots ou des fragments fondés sur les octets. Un token ne correspond pas nécessairement à un mot au sens linguistique. BPE, WordPiece et Unigram sont des méthodes représentatives de construction de vocabulaires de sous-mots, mais ce ne sont pas les mêmes algorithmes.1
Avec un vocabulaire composé uniquement de mots complets, cat et cats pourraient constituer deux entrées différentes. Mais que faire des noms nouveaux, des flexions et des variantes orthographiques ? Les ramener à un unique token « inconnu » ferait disparaître leurs différences. À l’autre extrême, traiter caractère par caractère rend les combinaisons plus souples, au prix de séquences souvent beaucoup plus longues.
Les méthodes de sous-mots cherchent un compromis. Prenons une version simplifiée de Byte Pair Encoding (BPE) au niveau des caractères. On commence par les caractères de chaque mot, on compte les paires de symboles adjacents, on fusionne la paire la plus fréquente, puis on recommence. On apprend ainsi une série de règles de fusion ordonnées. À l’utilisation, ces règles s’appliquent au nouveau texte ; on ne réentraîne pas un tokenizer à chaque entrée.2
Construisons un petit corpus contenant quatre formes : cat apparaît cinq fois, cats trois fois, dog quatre fois et dogs deux fois. Nous interdisons les fusions entre mots et départageons les égalités en choisissant la première paire rencontrée dans l’ordre de parcours fixé. Les quatre premières fusions sont :
c + a  → ca       8 occurrences
ca + t → cat      8 occurrences
d + o  → do       6 occurrences
do + g → dog      6 occurrences
Après ces quatre fusions :
cats → [cat, s]
dogs → [dog, s]
C’est un tokenizer pédagogique entièrement spécifié, pas le résultat d’un tokenizer de LLM existant. Les fragments ressemblent ici à un radical et à une terminaison, mais les fusions BPE sont fondées sur la fréquence, et non sur une analyse grammaticale. Les symboles de départ, le traitement des espaces et l’éventuelle représentation par octets peuvent changer le comportement d’un tokenizer réel.1
Nous n’avons toujours produit aucun vecteur de mot. Nous avons seulement choisi les unités discrètes que le modèle recevra.
Pour expliquer ensuite les embeddings classiques, passons explicitement à un autre vocabulaire, cette fois au niveau des mots, en reprenant les exemples précédents :
I → 0     like → 1     cats → 2     dogs → 3     pizza → 4

I like cats → [0, 1, 2]
Ces identifiants appartiennent à notre vocabulaire de mots complets, et non à celui du BPE précédent. Que les unités soient des mots ou des sous-mots, la question suivante reste la même : comment utiliser ces identifiants dans un calcul numérique ?
2. Identifier une unité ne suffit pas à la représenter
Les identifiants 2 et 3 sont deux entiers voisins. Cela ne dit rien de la proximité de sens entre cats et dogs. Réordonner les identifiants, en réordonnant de manière cohérente les paramètres associés, ne devrait pas modifier les calculs qu’un modèle est capable d’exprimer.
Une représentation sans ambiguïté est le vecteur one-hot. Dans notre vocabulaire à cinq entrées, cats correspond au vecteur ligne :
Il distingue parfaitement la catégorie. Mais deux vecteurs one-hot distincts sont toujours orthogonaux et séparés par une distance euclidienne égale à la racine carrée de deux. Cet encodage ne précise pas quelles catégories pourraient partager des caractéristiques.
Ajoutons donc une table de paramètres que l’on peut apprendre. Soient M entrées de vocabulaire, chacune associée à d composantes numériques :
\[E\in\mathbb R^{M\times d}.\]Pour un token w, on récupère la ligne dont l’indice correspond à son identifiant :
\[e_w=E[\operatorname{id}(w),:].\]Un embedding est ici une application qui associe à une identité discrète un vecteur de caractéristiques numériques utilisable par le modèle. Dans ce cas précis, l’application est une consultation de table. Les valeurs de la table sont des paramètres réels entraînables ; il n’est pas nécessaire de dériver les identifiants entiers. La classe Embedding de PyTorch réalise ce type de consultation.3
Choisissons par exemple cette table, uniquement pour l’illustration :
\[E= \begin{bmatrix} 0.1&0.4\\ 0.3&-0.2\\ 0&0\\ -0.4&0.2\\ 0.2&0.5 \end{bmatrix}.\]Consulter les identifiants [0, 1, 2] sélectionne les trois premières lignes. Le résultat est une matrice 3×2 : trois positions, avec un vecteur à deux composantes pour chacune. Si l’identifiant 2 réapparaît, il renvoie à la même ligne de paramètres.
Les valeurs peuvent être négatives ; leur somme n’a pas besoin d’être égale à un. Un embedding n’est ni une distribution de probabilité ni une liste de logits de sortie. Il fournit des caractéristiques dont les calculs suivants pourront éventuellement tirer des logits.
La consultation de table possède une écriture matricielle simple :
\[e_w=o_wE.\]Le vecteur one-hot n’a qu’une composante non nulle : sa multiplication par E sélectionne exactement une ligne. En pratique, il est inutile d’allouer une grande matrice one-hot.
Cela montre aussi que la consultation d’embedding n’est pas la seule manière de traiter des symboles discrets avec un réseau. Un vecteur one-hot suivi d’une transformation linéaire entraînable peut réaliser exactement la même application. Il ne s’agit pas d’une conversion mystérieuse imposée par l’ordinateur. La représentation permet à de nombreux tokens de partager un nombre limité de caractéristiques numériques ; les paramètres des couches suivantes peuvent opérer sur ces caractéristiques, même si d est bien inférieur à la taille du vocabulaire. C’est l’une des motivations des représentations distribuées en modélisation neuronale du langage.4
Mais nous avons choisi ces nombres à la main. La table est utilisable dans un calcul ; rien ne prouve qu’elle possède déjà une structure linguistique intéressante. On peut initialiser les embeddings puis laisser une fonction objectif modifier leurs valeurs.
La forme d’un embedding relève du choix de représentation. Son contenu dépend des données et de l’objectif qui servent à l’apprendre.
3. Quelles observations peuvent donner une structure utile aux vecteurs ?
Les mots qui entourent un mot donné constituent des observations directement disponibles dans le texte.
Reprenons nos cinq phrases :
I like cats
I like dogs
I like cats
I like pizza
I like cats
Définissons une fenêtre de contexte limitée au mot immédiatement voisin à gauche et à droite, sans franchir les frontières entre phrases. Notons C_wc le nombre de fois où le mot de contexte c apparaît près du mot central w. Par exemple, cats a été observé trois fois à côté de like ; dogs, une seule fois.
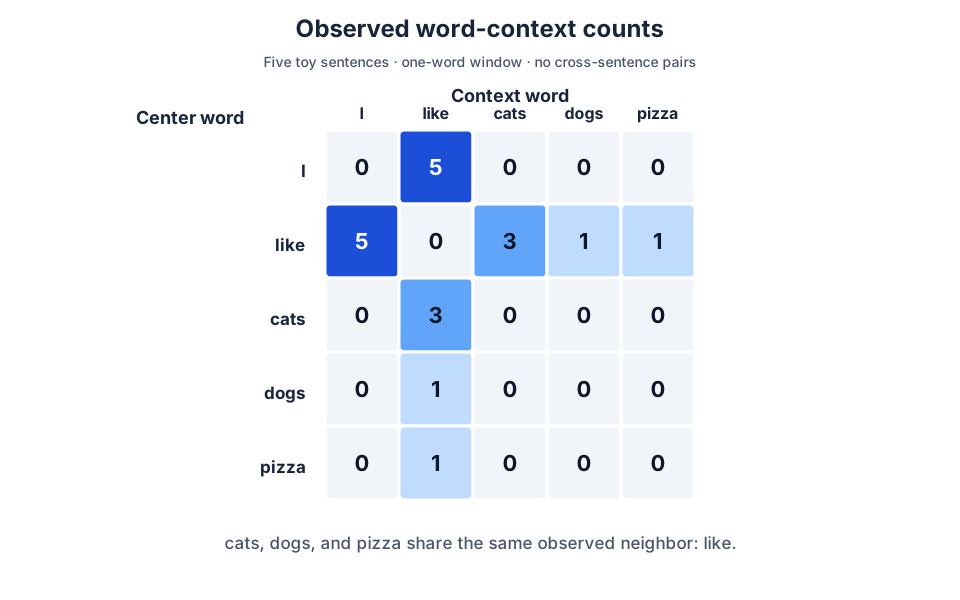
Chaque case représente un compte observé dans la fenêtre indiquée, pas une similarité apprise.
Une ligne de cette matrice constitue déjà une représentation vectorielle : ses coordonnées correspondent à des mots de contexte, ses valeurs à des comptes de cooccurrence. Lorsque le vocabulaire grandit, cette représentation devient large et clairsemée, et elle dépend de la fréquence des mots courants.
Les méthodes matricielles classiques peuvent pondérer, transformer ou réduire ces statistiques. Latent Semantic Analysis (LSA), par exemple, applique une factorisation de rang réduit à une matrice termes-documents. On peut aussi transformer une matrice mots-contextes, notamment par PPMI, avant de pratiquer une réduction par SVD. Un vecteur n’a pas nécessairement besoin d’être appris par un réseau de neurones.5
Notre corpus minuscule révèle également une limite : cats, dogs et pizza n’ont chacun que like comme voisin. Une fois leurs lignes normalisées, ils possèdent la même distribution de contextes.
Cela ne signifie pas que chats, chiens et pizzas ont le même sens. Cela signifie que ces données, avec cette fenêtre de contexte, ne contiennent pas suffisamment d’indices pour distinguer ces mots. Une représentation apprise à partir du contexte reste limitée par les observations et la tâche choisies.
Nous pouvons maintenant exploiter ces indices autrement : plutôt que d’utiliser directement la matrice de comptes comme représentation, nous allons entraîner des vecteurs à prédire les contextes observés.
4. Word2Vec : apprendre des vecteurs grâce à la prédiction
Les deux architectures connues de Word2Vec inversent le sens de la prédiction. Dans I like cats, si like est le mot central, CBOW utilise I et cats comme contexte pour prédire like ; Skip-gram part de like pour prédire séparément chacun de ses voisins, I et cats. Le CBOW élémentaire agrège les vecteurs du contexte et ne conserve pas leur ordre.6
Le signal d’entraînement vient du texte lui-même : personne n’a besoin d’étiqueter manuellement chaque paire de mots comme sémantiquement proche ou éloignée. La prédiction des voisins d’une fenêtre n’est pas la même tâche que la prédiction autorégressive du prochain token : la fenêtre peut contenir des mots de part et d’autre du centre.6
Commençons par le Softmax complet
Considérons un modèle de type Skip-gram avec Softmax sur l’ensemble du vocabulaire. Il utilise deux tables entraînables : une table d’entrée E fournit le vecteur e_w du mot central ; une table de sortie U fournit le vecteur u_j de chaque candidat j comme mot de contexte. Les deux tables ont M lignes et d colonnes, mais leurs paramètres sont distincts.
Un produit scalaire fournit un score, puis Softmax le normalise sur les mots de contexte possibles :
\[z_j=e_wu_j^\top, \qquad q_j=\frac{\exp(z_j)}{\sum_{k=0}^{M-1}\exp(z_k)}.\]Les identifiants vont de 0 à M−1. Si le mot de contexte observé porte l’identifiant c, la perte de cette paire est :
\[\ell(w,c)=-\log q_c.\]Nous retrouvons exactement la structure de prédiction et d’apprentissage des articles précédents. Cette fois, les scores sont produits par les vecteurs des mots. La perte entraîne les vecteurs eux-mêmes, au lieu de seulement entraîner un modèle à utiliser des vecteurs fixes. Les représentations d’entrée et de sortie ainsi que la formulation Skip-gram avec Softmax complet apparaissent dans les travaux d’origine.7
En quoi est-ce davantage qu’une autre façon de stocker des scores ? Sauvegarder un score indépendant pour chaque paire centre-contexte demanderait M² nombres. Deux tables M×d utilisent plutôt 2Md paramètres pour générer tous ces scores par produit scalaire. Lorsque d est beaucoup plus petit que M, les scores des paires ne peuvent plus être réglés indépendamment ; ils doivent partager une structure de faible dimension. Cette contrainte peut être utile, sans garantir que chaque distance géométrique reflétera la similarité sémantique.
Le fait qu’un mot possède deux vecteurs n’implique pas deux significations incompatibles. Ces vecteurs ont deux rôles distincts dans le calcul prédictif.
Effectuons réellement une mise à jour d’embedding
Prenons une paire observée dans le corpus : mot central cats, mot de contexte like. Dans notre table d’entrée, le vecteur initial de cats est (0,0). Pour isoler l’apprentissage de cette unique ligne, fixons la table de sortie pendant cette étape :
| Candidat de contexte | Vecteur de sortie |
|---|---|
I | (−1, 0) |
like | (1, 0) |
cats | (0, 1) |
dogs | (0, −1) |
pizza | (0, 0) |
Au départ, tous les produits scalaires sont nuls : les cinq candidats ont donc chacun une probabilité de 0,2. La perte associée à like vaut :
L’article 03 a établi le gradient de l’entropie croisée par rapport aux logits Softmax. En appliquant la règle de chaîne aux produits scalaires, le gradient par rapport au vecteur d’entrée devient :
\[\nabla_{e_w}\ell = \sum_{j=0}^{M-1}\bigl(q_j-\mathbf1[j=c]\bigr)u_j.\]La fonction indicatrice vaut un uniquement pour le contexte réellement observé c. Comme les cinq vecteurs de sortie de notre exemple ont une somme nulle, le gradient est (−1,0). Avec un taux d’apprentissage de 0,5 :
\[e_{\mathrm{cats}}^{\mathrm{new}} =(0,0)-0.5(-1,0)=(0.5,0).\]En recalculant les scores et probabilités, la probabilité de like augmente jusqu’à environ 0.313728, tandis que la perte descend à environ 1.159228.
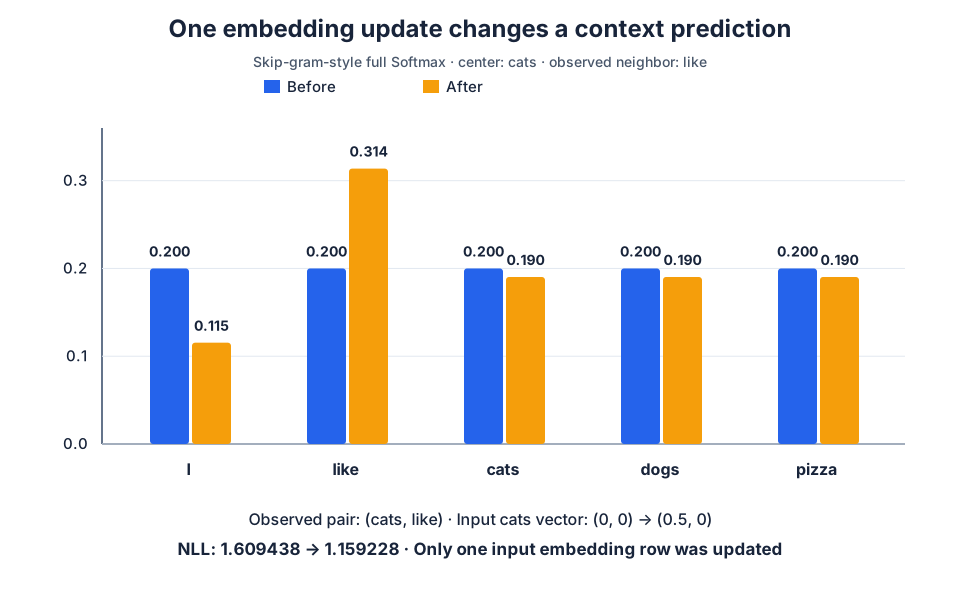
Une étape de gradient définie explicitement : ni embeddings préentraînés, ni trajectoire d’entraînement mesurée. Aucun regroupement sémantique n’a été inventé.
Nous n’avons pas déclaré que la première coordonnée devait signifier « aimer ». Cette étape rend simplement le contexte observé plus probable dans ce modèle particulier. Un entraînement complet traiterait de nombreuses paires observées et mettrait à jour les deux tables. Nous gardons U fixe uniquement pour rendre ce calcul transparent.
Comme la table d’entrée est partagée, la prochaine occurrence de cats récupérera la ligne mise à jour, au lieu de créer un nouveau vecteur.
La géométrie utile résulte des contraintes de l’objectif d’apprentissage. Les coordonnées individuelles ne portent pas d’étiquettes sémantiques immuables. Appliquer la même rotation orthogonale aux vecteurs d’entrée et de sortie préserverait tous les produits scalaires ; les prédictions resteraient identiques.
Word2Vec n’a pas toujours besoin d’évaluer tout le vocabulaire
Le Softmax complet aide à comprendre le mécanisme, mais nécessite un score pour chaque candidat. Word2Vec a également utilisé le Softmax hiérarchique et introduit le negative sampling : les paires observées et des paires tirées d’une distribution de bruit sont utilisées dans un objectif ressemblant à une classification binaire. Une paire tirée comme « négative » n’est pas nécessairement impossible en langue naturelle.7
Le negative sampling modifie l’objectif d’entraînement. Ce n’est pas simplement un Softmax complet dont on aurait supprimé quelques termes du dénominateur. Notre exemple avec Softmax complet construit la compréhension de base, sans prétendre à une identité des objectifs.
5. GloVe et fastText : changer l’exploitation des données ou le partage des paramètres
Word2Vec nous montre comment la prédiction peut façonner les vecteurs. Mais prédire individuellement des paires de mots n’est pas le seul usage possible des cooccurrences ; attribuer une ligne indépendante à chaque mot complet n’est pas non plus la seule façon d’organiser les paramètres.
GloVe ajuste des statistiques agrégées de cooccurrence
GloVe commence par des comptes de cooccurrence recueillis à l’échelle du corpus. Notons toujours C_ij le compte entre un mot i et un contexte j, et e_i, u_j deux ensembles de vecteurs à apprendre. Ajoutons des biais scalaires b_i, c_j et une fonction de pondération non négative ω. Sur les paires de compte strictement positif, l’objectif s’écrit :
\[J= \sum_{i,j:C_{ij}>0} \omega(C_{ij}) \left(e_iu_j^\top+b_i+c_j-\ln C_{ij}\right)^2.\]Il s’agit d’une erreur quadratique pondérée : un produit scalaire entre vecteurs, additionné de biais, doit approcher le logarithme du compte de cooccurrence. La pondération contrôle la contribution de chaque compte. Ce n’est ni une copie brute d’un tableau de fréquences ni une entropie croisée calculée sur chaque voisin.5
Skip-gram transforme les cooccurrences en exemples de prédiction ; GloVe ajuste directement des statistiques agrégées. Les deux utilisent des indices proches, mais des objectifs différents. Aucun ne découle de manière unique de la notion abstraite de « sens ».8
fastText partage des paramètres entre fragments de caractères
Dans une table indexée uniquement par mots complets, les vecteurs d’entrée de cat et cats peuvent être totalement indépendants. Leur proximité orthographique n’intervient pas directement dans la paramétrisation.
La méthode de vecteurs de mots fastText apprend des vecteurs pour les n-grammes de caractères et les combine pour représenter les mots. Pour simplifier, prenons seulement des trigrammes, avec les marqueurs de frontière < et > :
cat  → <ca, cat, at>
cats → <ca, cat, ats, ts>
Ces fragments se chevauchent : les deux mots contiennent <ca et cat et partagent donc les paramètres associés. La méthode d’origine comprend aussi une caractéristique correspondant au mot complet et plusieurs longueurs de n-grammes, omises ici.9
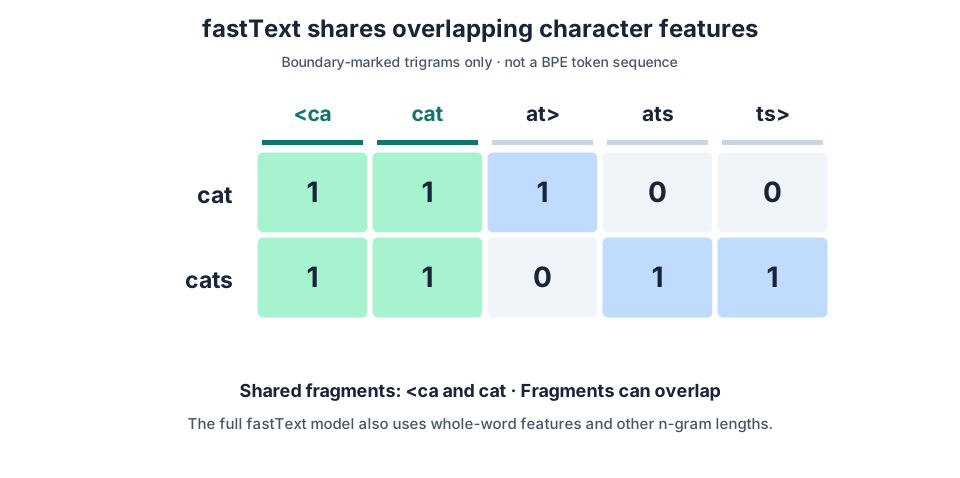
La valeur 1 signifie que le fragment est présent. Ce tableau ne représente pas une séquence de tokens et n’affiche que des fragments de longueur trois.
Notons G(w) l’ensemble des caractéristiques employées pour le mot w, et a_g le vecteur de la caractéristique g. On peut écrire leur combinaison :
\[e_w=\sum_{g\in G(w)}a_g.\]Même si un mot complet n’a jamais été vu à l’entraînement, ses fragments de caractères peuvent fournir une représentation. Cela permet de traiter des formes inconnues, mais ne garantit pas que leur sens puisse être déduit de leur orthographe.9
Les n-grammes de caractères de fastText et les tokens de sous-mots du BPE remplissent des fonctions différentes. Les premiers combinent plusieurs fragments qui peuvent se chevaucher pour représenter un mot ; les seconds découpent le texte en une séquence d’unités discrètes. Le terme commun de « sous-mot » peut masquer cette différence.
Word2Vec, GloVe et fastText proposent donc différentes réponses à un même problème : apprendre des représentations utiles à partir de données, avec des objectifs et des granularités de partage distincts.
6. Que désigne un « embedding » dans un LLM ?
Distinguons comment un vecteur a été appris de la manière dont il est récupéré lors d’un calcul.
Pour une consultation classique de table, si les paramètres sont fixes, le même ID renvoie toujours la même ligne. C’est en ce sens que les vecteurs de mots classiques sont dits statiques : la consultation ne recalcule pas le vecteur selon la phrase courante. Naturellement, les paramètres peuvent changer pendant l’entraînement.
Un LLM peut également employer une table d’embeddings de tokens apprise. Que son vocabulaire contienne des mots, des sous-mots ou des fragments basés sur des octets, la relation de consultation est identique. Ses vecteurs peuvent être entraînés conjointement avec l’objectif de prédiction du langage ; il n’est pas nécessaire de préentraîner Word2Vec séparément.410
La table d’entrée et les représentations internes dépendantes du contexte sont pourtant deux objets différents. Comparons :
I like
They like
Si like correspond au même token ID, la consultation seule renvoie la même ligne. En revanche, après le traitement de ces deux préfixes, la représentation cachée de like peut différer, car le contexte traité n’est plus le même.
L’embedding d’entrée est une ligne d’une table de paramètres. Une représentation contextualisée est calculée pour cette entrée précise. Le fait qu’elle varie avec le contexte n’oblige pas à modifier les paramètres d’embedding pendant l’inférence. Nous expliquerons le calcul qui produit cette contextualisation dans l’article suivant.10
La sortie du modèle doit également transformer une représentation cachée en scores sur le vocabulaire. Certaines architectures choisissent de partager la table d’entrée avec les poids de sortie. Si le vecteur caché ligne h possède la même largeur que l’embedding, et si nous omettons le biais, cela peut s’écrire :
\[z=hE^\top.\]Le résultat est un score par token candidat, pas une seule ligne récupérée de la table. Le partage de poids est un choix architectural, pas l’inverse mathématique de la consultation d’embedding.11
Les embeddings de phrases et de documents employés en recherche d’information constituent encore un autre niveau. Un texte de longueur variable doit être encodé et résumé en un vecteur de taille fixe ; des objectifs d’entraînement spécifiques peuvent rendre les similarités vectorielles adaptées à la recherche. Sentence-BERT est un exemple de cette démarche. On ne trouve pas une phrase arbitraire sous la forme d’une ligne directement indexable dans la table des tokens.12
Ainsi, « embedding » peut désigner les paramètres d’entrée d’un token, la représentation contextualisée d’une position, ou le vecteur résumant une phrase ou un document. Employer le même nom ne rend pas ces objets interchangeables, ni chaque vecteur automatiquement pertinent pour la recherche sémantique.
7. Nous avons des vecteurs. Où est l’ordre des mots ?
Il reste une question : la position.
Supposons de nouveau une tokenisation par mots et comparons :
dog bites man
man bites dog
Si nous additionnons simplement leurs trois embeddings, les deux phrases produisent le même vecteur, puisque l’addition ne dépend pas de l’ordre. Ce ne sont pas les vecteurs qui sont mauvais : c’est l’opération d’agrégation choisie qui a effacé l’ordre.
Placer un token sur une certaine ligne d’une matrice et faire utiliser cet indice de ligne par les calculs sont deux choses différentes. Il faut donner au modèle un indice exploitable sur la position du token, plutôt qu’exiger que le même vecteur lexical représente à lui seul toutes les positions possibles.
Embeddings de position absolue appris
Une solution consiste à attribuer des vecteurs entraînables aux positions absolues. Supposons une table couvrant jusqu’à L positions, avec d caractéristiques par position :
\[R\in\mathbb R^{L\times d}, \qquad p_i=R[i,:].\]Si x_i est l’ID du token à la position i, on peut choisir d’additionner les représentations :
\[h_i^{(0)}=E[x_i,:]+p_i.\]Le même token à des positions différentes peut alors recevoir des représentations initiales différentes. E est indexée par l’identité du token ; R par sa position. L’addition conserve la largeur du vecteur. Il s’agit d’un choix de modélisation, non d’une nécessité imposée par la théorie des probabilités. Le Transformer original examinait aussi bien les embeddings de position appris que les encodages sinusoïdaux fixes.10
Une table apprise offre des paramètres aux différentes positions, mais la présence d’une ligne pour une position peu rencontrée à l’entraînement ne garantit pas qu’elle sera bien utilisée.
Encodages sinusoïdaux fixes
Une autre solution calcule des vecteurs de position à partir de fonctions, sans apprendre de table supplémentaire. Soit d un nombre pair, i une position commençant à zéro, et r un entier allant de zéro à d/2−1 :
\[p_{i,2r} = \sin\left(\frac{i}{10000^{2r/d}}\right),\] \[p_{i,2r+1} = \cos\left(\frac{i}{10000^{2r/d}}\right).\]Chaque paire de coordonnées partage une fréquence ; les différentes paires varient à des vitesses différentes. Le Transformer original utilisait cet encodage fixe. Le nombre 10000 est une constante d’échelle choisie pour cette construction, pas une valeur mathématiquement imposée par l’idée de position.10
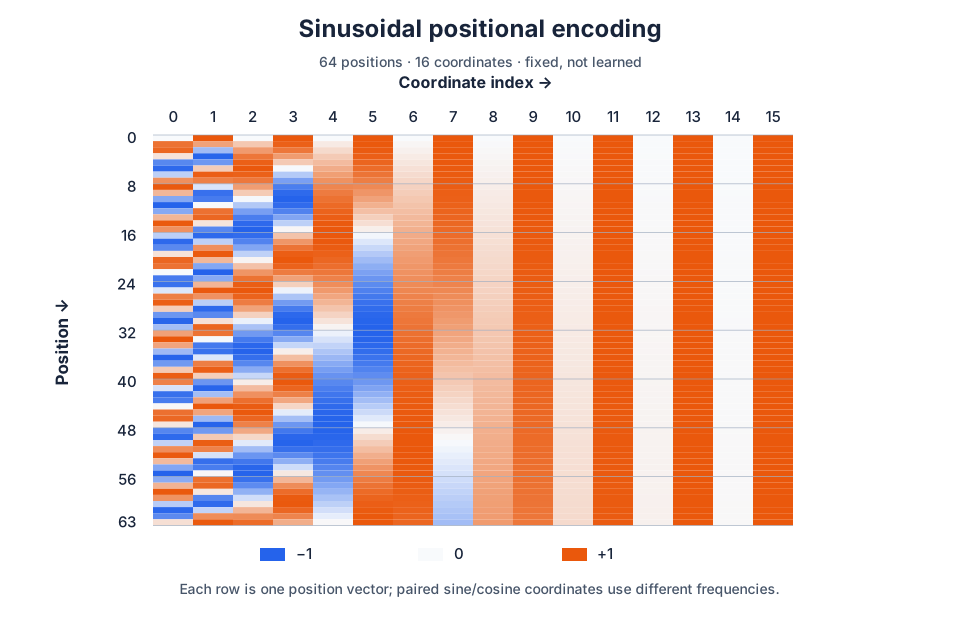
Les lignes sont les positions ; les colonnes, les coordonnées. Les valeurs proviennent de la formule et non d’un entraînement.
Des positions voisines possèdent ainsi des différences numériques structurées, plutôt que des identités arbitraires sans lien. Les formules d’addition des angles du sinus et du cosinus permettent également de décrire certains décalages fixes par des relations linéaires. Mais pouvoir calculer un encodage pour une position plus éloignée ne garantit pas que le modèle entraîné fonctionnera correctement sur un contexte plus long. Une formule définie à une certaine position et une capacité de généralisation à cette position sont deux questions distinctes.
Une limite subtile mérite d’être vérifiée : ajouter un vecteur de position suffit-il pour que toute agrégation conserve l’ordre des mots ?
Non. Si nous additionnons immédiatement toutes les positions :
\[\sum_i\bigl(E[x_i,:]+p_i\bigr) = \sum_i E[x_i,:]+\sum_i p_i.\]Deux phrases de même longueur ne différant que par une permutation des tokens ont toujours le même résultat.
L’encodage positionnel fournit une information utilisable. Les calculs suivants doivent effectivement l’exploiter avant de perdre la correspondance entre tokens et positions. Les vecteurs lexicaux et positionnels ne suffisent donc pas, à eux seuls, à expliquer un modèle de langage complet.
La position n’est pas toujours ajoutée aux embeddings d’entrée
Les termes positional embedding et positional encoding se chevauchent souvent. Il est plus utile de demander si la représentation est apprise, si elle exprime une position absolue ou relative, et à quel stade du calcul elle intervient.
Certaines méthodes injectent la position relative lors de la comparaison entre positions d’une séquence. RoPE applique des rotations dépendant des positions dans une opération de comparaison ultérieure ; ALiBi ajoute aux scores de comparaison un biais lié à la distance entre positions, au lieu d’ajouter une nouvelle table à l’embedding d’entrée.1314
Une véritable dérivation de ces mécanismes exige le calcul de l’Attention, que nous aborderons dans l’article suivant. La distinction est essentielle : tous les mécanismes de position ne prennent pas la forme « token embedding + positional embedding ». Notre exemple d’addition insensible à l’ordre ne prouve pas non plus que toute architecture sans vecteurs positionnels explicites est incapable de prendre l’ordre en compte.
8. Que manque-t-il encore une fois le texte transformé en vecteurs ?
Nous savons désormais transformer un texte en matrice numérique de T lignes et d colonnes : T est le nombre de tokens émis par le tokenizer, d la largeur des représentations. Chaque ligne a une origine définie. La fonction de perte peut modifier les paramètres de la table et le modèle peut choisir comment introduire la position.
Reprenons I like et They like. Si like correspond au même token ID et occupe la même position, sa consultation d’embedding suivie de la même addition positionnelle donne toujours le même vecteur initial.
Ces deux opérations ne lui ont pas permis de lire I ou They.
L’embedding transforme les symboles discrets en représentations numériques qui peuvent être apprises. À lui seul, il ne permet pas à une position d’interagir avec son contexte. L’article suivant examinera comment une position peut récupérer des informations à d’autres positions et intégrer ces informations à sa propre représentation.
Les figures sont des exemples construits, pas des embeddings préentraînés ni des résultats expérimentaux. Calculs reproductibles.
-
Hugging Face, Tokenization algorithms, présentation des méthodes, des vocabulaires et des variantes au niveau des octets. ↩ ↩2
-
Rico Sennrich, Barry Haddow et Alexandra Birch, Neural Machine Translation of Rare Words with Subword Units, ACL 2016, §3.2. Les quatre fusions de cet article constituent un exemple pédagogique défini et vérifié indépendamment. ↩
-
PyTorch, torch.nn.Embedding. L’équivalence avec un vecteur one-hot découle directement de la multiplication matricielle. ↩
-
Yoshua Bengio, Réjean Ducharme, Pascal Vincent et Christian Jauvin, A Neural Probabilistic Language Model, JMLR 3:1137–1155, 2003. ↩ ↩2
-
Jeffrey Pennington, Richard Socher et Christopher Manning, GloVe: Global Vectors for Word Representation, EMNLP 2014, §2–3, équation 8. ↩ ↩2
-
Tomas Mikolov, Kai Chen, Greg Corrado et Jeffrey Dean, Efficient Estimation of Word Representations in Vector Space, 2013, §3 et figure 1. ↩ ↩2
-
Tomas Mikolov et al., Distributed Representations of Words and Phrases and their Compositionality, NeurIPS 2013, §2. L’étape illustrée ici garde U fixe pour isoler le gradient du vecteur d’entrée ; elle ne reproduit pas l’entraînement complet de Word2Vec. ↩ ↩2
-
Stanford NLP, GloVe project. ↩
-
Piotr Bojanowski, Edouard Grave, Armand Joulin et Tomas Mikolov, Enriching Word Vectors with Subword Information, TACL 5:135–146, 2017, §3.2. L’illustration ne montre que les trigrammes de caractères. ↩ ↩2
-
Ashish Vaswani et al., Attention Is All You Need, NeurIPS 2017, §3.4–3.5. Cet exemple d’entrée additive simplifie les mises à l’échelle et l’architecture complète. ↩ ↩2 ↩3 ↩4
-
Ofir Press et Lior Wolf, Using the Output Embedding to Improve Language Models, EACL 2017. ↩
-
Nils Reimers et Iryna Gurevych, Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks, EMNLP-IJCNLP 2019. ↩
-
Jianlin Su et al., RoFormer: Enhanced Transformer with Rotary Position Embedding, 2021 ; révision en 2023. ↩
-
Ofir Press, Noah A. Smith et Mike Lewis, Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation, 2021 ; ICLR 2022. ↩