First Principles of LLMs & RL · Article 06 · Article précédent
Note d’écriture : les idées et le matériau initial sont les miens. ChatGPT a aidé à la rédaction, à l’édition, à la traduction, aux vérifications numériques et à la création des figures originales et des sources d’animation.
D’une requête de lecture à la self-attention, aux Query, Key et Value
Dans l’article précédent, Felix avait laissé un carnet bleu dans la salle de réunion. La personne qui cherchait le carnet s’intéressait au lieu ; celle qui voulait l’identifier, à sa couleur. Cette distinction nous a conduits à un mécanisme de lecture : conserver un ensemble de représentations, leur attribuer des scores à partir de l’état courant, puis combiner les informations selon ces poids.
Dans ce modèle encoder–decoder, la requête provenait de l’état du decoder. Mais les positions d’une phrase peuvent elles aussi avoir besoin du contexte. Un pronom doit être relié à une personne mentionnée auparavant ; la représentation d’un verbe peut avoir besoin d’informations sur son sujet.
Cette fois, nous allons laisser ces positions émettre les requêtes. Avant d’introduire les noms Query, Key et Value, décomposons une lecture.
1. Trouver une information et la récupérer sont deux opérations distinctes
Reprenons la même phrase :
Felix left the blue notebook in the meeting room yesterday.
Imaginons que nous organisions manuellement ces informations en fiches faciles à retrouver. Une fiche porte les étiquettes « carnet, emplacement » et contient « salle de réunion ». Une autre porte les étiquettes « carnet, couleur » et contient « bleu ».
Pour répondre à « Où est le carnet ? », il faut d’abord repérer la fiche qui correspond à la requête, puis récupérer ce qu’elle fournit.
| Que cherche-t-on ? | Quels indices permettent de trouver la fiche ? | Que récupère-t-on ? |
|---|---|---|
| Où est le carnet ? | carnet, emplacement | salle de réunion |
| De quelle couleur est le carnet ? | carnet, couleur | bleu |
« Cette fiche concerne un emplacement » aide à la retrouver, mais ne précise pas encore lequel. Le même type d’indice pourrait accompagner une autre fiche contenant « bureau ».
Les caractéristiques utilisées pour trouver une information ne sont pas nécessairement le contenu transmis une fois qu’on l’a trouvée.
Donnons maintenant un nom aux trois rôles.
La Query est la requête de lecture courante. Dans cet exemple, elle exprime que nous cherchons l’emplacement du carnet.
La Key est la représentation par laquelle un contenu candidat participe à l’appariement. Ici, « carnet, emplacement » fournit les indices à comparer avec la requête.
La Value est ce que ce candidat apporte lorsqu’il est lu. Ici, elle précise qu’il s’agit de la salle de réunion.
Ce tableau est une analogie organisée à la main. Un modèle réel ne transforme pas d’abord la phrase en fiches étiquetées dans une langue humaine. Dans un Transformer, les Query, Key et Value sont des vecteurs ; leurs relations d’appariement et leur contenu transmis résultent de calculs apprenables.1
L’analogie préserve une distinction de fonctions, pas les étiquettes elles-mêmes. Une Key et une Value peuvent contenir des informations communes. Elles ne sont pas nécessairement une version « courte » et une version « complète » du même contenu. Les séparer permet simplement d’apprendre des représentations adaptées, respectivement, à l’appariement et à la transmission.
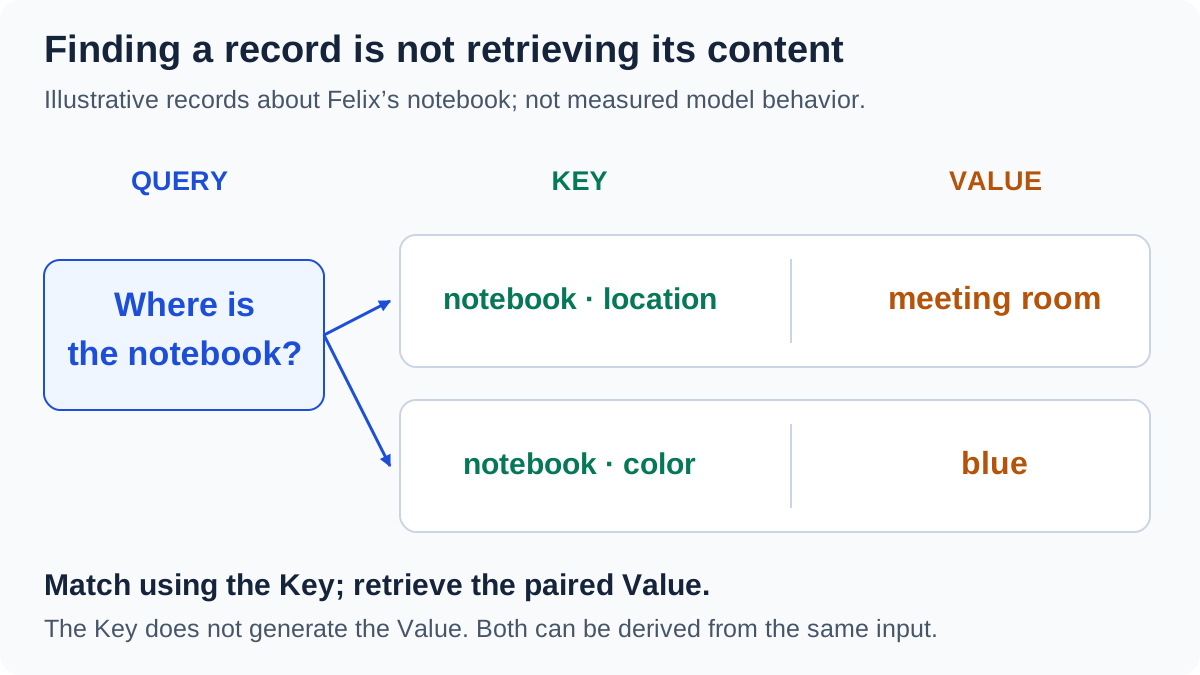
Les fiches illustrent des fonctions, pas des étiquettes sémantiques attribuées manuellement à l’intérieur d’un modèle. La progression visuelle partant d’une requête s’inspire de la vidéo de 3Blue1Brown sur l’attention ; les figures, les exemples numériques et le code d’animation sont originaux.2
2. Quand la requête vient de l’intérieur de la phrase
Jusqu’ici, un lecteur extérieur posait la question. Allongeons légèrement la phrase :
Felix left the blue notebook in the meeting room because he was in a hurry.
Pour un lecteur humain, Felix fournit un indice pour interpréter he. On peut en tirer une exigence de conception : la position qui traite he doit disposer d’un moyen de lire les informations antérieures concernant une personne.
Avec les mêmes rôles, on peut décrire grossièrement le comportement souhaité : la position de he émet une requête concernant une personne pertinente ; les positions antérieures fournissent des indices à comparer ; la lecture rapporte des informations vectorielles sur les candidats pour les calculs suivants.
Cela ne suppose pas que le modèle produise littéralement une phrase comme « Trouve la personne désignée par ce pronom ». Cela ne signifie pas non plus qu’une seule opération d’attention résout la coréférence. C’est un exemple de besoin d’information, pas une observation tirée d’un modèle entraîné. La « requête » doit finalement être calculée à partir de la représentation déjà disponible à la position courante.
Chaque position peut donc jouer deux rôles. Comme lectrice, elle demande des informations aux autres positions. Comme source, elle leur fournit une Key et une Value.
Lorsque les requêtes et le contenu lu proviennent du même ensemble de représentations de séquence, on parle de Self-Attention. Self désigne cette origine commune, et non une règle selon laquelle une position ne pourrait lire qu’elle-même. Si la requête vient du decoder et le contenu de l’encoder, la lecture relie deux séquences : on parle généralement de Cross-Attention.1
Cette distinction est indépendante de la règle de scoring. On peut déterminer l’origine des requêtes, puis choisir séparément un score additif ou un produit scalaire. La Self-Attention n’impose pas logiquement une formule particulière.
Souvenons-nous de I like et They like dans l’article 04. Si like possède le même identifiant de token et la même position, un lookup indépendant suivi de l’ajout du même vecteur de position produit toujours la même représentation initiale.
Le résultat suivant n’est pourtant pas obligé d’être identique. Une même requête initiale peut récupérer des contenus différents face à des Keys et des Values différentes. Le modèle n’a pas besoin d’avoir déjà compris tout le contexte pour commencer à le lire.
3. Transformer ces rôles en calculs apprenables
Commençons par une seule position.
Notons xᵢ le vecteur de la position i à l’entrée de la couche courante, de largeur d_model. Comme dans l’article précédent, les vecteurs individuels sont des colonnes :
\[x_i\in\mathbb R^{d_{\mathrm{model}}}.\]À la première couche, il peut combiner un embedding de token et des informations de position. Plus en profondeur, il résulte des calculs précédents. Ici, xᵢ est un vecteur, pas un identifiant discret de token.
Trois projections linéaires offrent un moyen simple et apprenable de donner trois rôles à cette entrée. Notons leurs paramètres W_Q, W_K et W_V :
\[q_i=W_Q^\top x_i, \qquad k_i=W_K^\top x_i, \qquad v_i=W_V^\top x_i.\]Une projection linéaire recombine les coordonnées de l’entrée. Elle n’a pas à savoir à l’avance quelle dimension signifie « personne » ou « lieu ». L’entraînement détermine si ces projections forment des appariements et des contenus utiles à la tâche. Nous étudions ici une seule famille de projections et sa lecture élémentaire, sans biais, dropout ni projection de sortie ultérieure.1
Notons d_k la dimension des Query et des Key, et d_v celle des Value. Les paramètres ont les formes suivantes :
\[W_Q,W_K\in\mathbb R^{d_{\mathrm{model}}\times d_k}, \qquad W_V\in\mathbb R^{d_{\mathrm{model}}\times d_v}.\]Les Query et les Key doivent avoir la même dimension pour le produit scalaire direct utilisé ci-dessous. Les Value ne participent pas à ce produit ; leur dimension peut donc être choisie séparément.
Une distinction mérite d’être soulignée : chaque position possède son propre vecteur Query, mais pas ses propres paramètres de projection Query. Toutes les positions de cette couche utilisent le même W_Q. Les projections Key et Value partagent elles aussi leurs paramètres respectifs. Des entrées différentes peuvent produire des vecteurs différents.
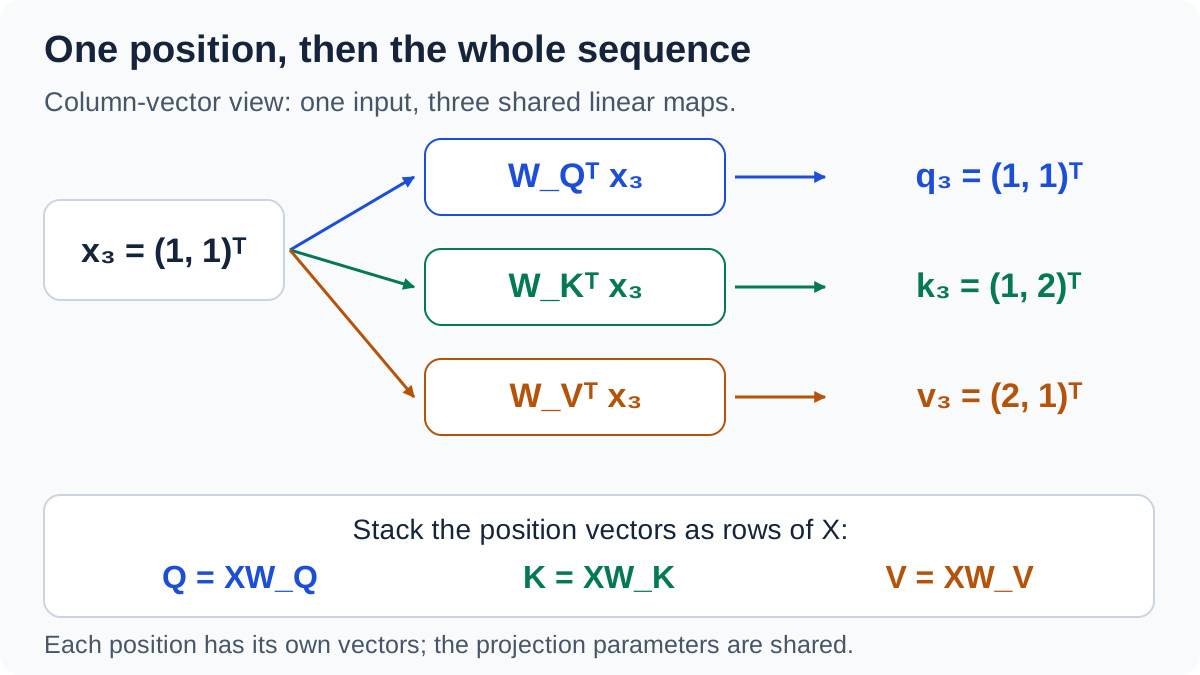
Les vecteurs individuels sont des colonnes ; leurs transposées sont empilées en lignes pour représenter la séquence. L’entrée construite x₃ illustre les trois rôles sans attribuer de sens lexical à ses coordonnées.
Comment une requête est-elle comparée à un candidat ?
Pour la requête qᵢ à la position i et l’indice candidat kⱼ à la position j, considérons le produit scalaire :
\[q_i^\top k_j = \sum_{r=1}^{d_k}q_{ir}k_{jr}.\]Si l’on imagine provisoirement les coordonnées comme des caractéristiques comparables, cette opération multiplie l’orientation de la requête sur chaque coordonnée par la valeur correspondante du candidat, puis additionne ces contributions.
Cela explique le calcul, pas l’interprétation d’une représentation entraînée. Rien ne garantit que chaque coordonnée corresponde à une propriété linguistique nommable. Le produit scalaire dépend aussi de la norme des vecteurs ; il n’est pas automatiquement une similarité sémantique.
En remplaçant les vecteurs par leurs projections, la partie apprenable devient visible :
\[q_i^\top k_j = x_i^\top W_QW_K^\top x_j.\]Les entrées ne sont donc pas simplement comparées dans un espace sémantique fixe et intrinsèquement correct. Les matrices apprises déterminent comment leurs directions participent à l’appariement.
Dans l’exemple linguistique, la relation entre he et Felix ne tient pas seulement à une ressemblance entre les mots. Une position cherche une information pertinente sur une personne ; une autre peut la fournir. On cherche une compatibilité utile à cette lecture, pas seulement le mot le plus semblable au mot courant.
On pourrait aussi se passer des projections indépendantes et calculer directement les produits scalaires entre entrées. Mais les scores bruts vérifieraient alors :
\[x_i^\top x_j=x_j^\top x_i.\]Des projections Query et Key indépendantes n’imposent pas cette symétrie. Elles permettent à la relation « la position i lit la position j » de différer de la relation inverse. Cela concerne les scores bruts : même des scores symétriques peuvent donner des poids asymétriques après normalisation ligne par ligne, car les dénominateurs des lignes peuvent différer.
La séparation des Value répond à une autre question. Même après avoir décidé où lire, les informations transmises en aval ne doivent pas nécessairement utiliser les coordonnées qui ont servi à calculer l’appariement.
4. Des scores d’appariement à une lecture
Le produit scalaire fournit un score, pas encore un coefficient de mélange final. Examinons d’abord son échelle, puis la manière dont ces scores doivent combiner le contenu.
Pourquoi ajuster l’échelle quand la dimension augmente ?
L’article précédent utilisait déjà le Softmax. Il est sensible aux écarts relatifs : des écarts suffisamment grands peuvent concentrer les poids sur quelques positions.
Or, le nombre de produits additionnés augmente avec la dimension des Query et Key. Pour isoler cet effet, supposons, dans cette analyse idéalisée, que toutes les composantes de q et k sont mutuellement indépendantes, de moyenne nulle et de variance unitaire.
Pour le produit sur une coordonnée :
\[\mathbb E[q_rk_r]=0, \qquad \mathbb E[q_r^2k_r^2] = \mathbb E[q_r^2]\mathbb E[k_r^2] =1.\]Donc :
\[\operatorname{Var}(q_rk_r)=1.\]Les produits sur des coordonnées différentes sont eux aussi indépendants sous ces hypothèses. Leurs variances s’additionnent :
\[\operatorname{Var}(q^\top k)=d_k, \qquad \operatorname{Std}(q^\top k)=\sqrt{d_k}.\]Ce qui s’additionne avec la dimension est la variance. L’écart-type en est la racine carrée. Voilà pourquoi le facteur d’échelle fait intervenir cette racine, et non directement la dimension.
Diviser par cette échelle d’écart-type donne une variance unitaire sous les hypothèses indiquées :
\[\operatorname{Var}\!\left(\frac{q^\top k}{\sqrt{d_k}}\right)=1.\]Définissons ainsi le score utilisé pour la lecture :
\[e_{ij}=\frac{q_i^\top k_j}{\sqrt{d_k}}.\]C’est la motivation du Transformer original pour le scaled dot-product attention : éviter que la seule augmentation de la dimension pousse le Softmax vers des régions où les gradients sont très faibles. Les Query et Key réelles proviennent de représentations apprises et peuvent même venir de la même position. Elles ne satisfont pas nécessairement les hypothèses d’indépendance, et ce facteur ne garantit pas une variance unitaire pendant tout l’entraînement.1
Peut-on multiplier directement les scores par les Values ?
Oui. Il faut simplement accepter les propriétés de ce choix.
Prenons un exemple scalaire sans interprétation linguistique. Deux candidats ont les scores 2 et 1 ; leurs Values valent 10 et 20. En utilisant les scores directement comme coefficients :
\[o_{\mathrm{raw}}=2\times10+1\times20=40.\]Ajoutons 100 aux deux scores. Leur écart reste égal à 1, mais le résultat devient :
\[o_{\mathrm{raw}}'=102\times10+101\times20=3040.\]Il n’y a pas de contradiction mathématique. Le mélange par scores bruts utilise à la fois leur niveau absolu et leurs écarts relatifs.
Si une lecture doit dépendre seulement des scores relatifs, il faut une autre transformation des scores en coefficients. Le Softmax est un choix possible. Notons aᵢⱼ le poids attribué par la position i au candidat j :
\[a_{ij} = \frac{\exp(e_{ij})}{\sum_{m=1}^{n}\exp(e_{im})}.\]Ici, n est le nombre de positions candidates. Supposons pour l’instant qu’elles soient toutes visibles, que leurs scores soient finis et qu’il existe au moins un candidat. Alors :
\[a_{ij}>0, \qquad \sum_{j=1}^{n}a_{ij}=1.\]Le Softmax est insensible à un décalage commun. Nos deux vecteurs de scores donnent donc les mêmes poids :
\[\operatorname{softmax}([2,1]) = \operatorname{softmax}([102,101]) \approx[0.731059,\;0.268941].\]Le contenu récupéré devient :
\[o \approx 0.731059\times10+0.268941\times20 \approx12.689414.\]On choisit ici une lecture normalisée plutôt qu’un mélange linéaire arbitraire. Pour des Values fixées, des coefficients positifs dont la somme vaut un produisent une combinaison convexe. Avec des Values vectorielles, le résultat appartient à leur enveloppe convexe. Il ne peut pas croître arbitrairement du seul fait que la somme des coefficients augmente.
Cela ne démontre pas que toute attention doit utiliser le Softmax. On peut choisir une autre transformation, puis examiner si elle autorise des coefficients négatifs, les normalise et contrôle l’échelle de sortie. Une opération matricielle légale et un comportement de lecture souhaité sont deux questions différentes.
L’article 02 proposait un autre point de vue : répartir une probabilité en arbitrant entre scores élevés et entropie conduit à une forme Softmax. Remplacer les valeurs d’action fixées de cet exemple par les scores d’appariement donne la même structure mathématique. Cela interprète la règle d’allocation à scores fixés ; cela ne signifie pas que l’attention exécute séparément une procédure d’entraînement RL.
Pourquoi la requête ne disparaît-elle pas pendant la normalisation ?
L’article 05 présentait un contre-exemple. Supprimer tanh de son score additif ne laissait qu’une somme linéaire d’un terme de requête et d’un terme candidat. La contribution de la requête devenait un décalage commun à tous les candidats, supprimé par le Softmax.
Ici, l’interaction est multiplicative. Pour deux candidats visibles j et m, le rapport des poids donne directement :
\[\begin{aligned} \log\frac{a_{ij}}{a_{im}} &=e_{ij}-e_{im}\\ &=\frac{q_i^\top(k_j-k_m)}{\sqrt{d_k}}. \end{aligned}\]Changer la Query peut modifier les scores relatifs des candidats, donc leurs poids relatifs de lecture. Son rôle n’est plus limité à ajouter le même décalage partout.
C’est une manière de faire dépendre conjointement le score de la requête et du candidat, pas l’unique remplacement possible du score additif. Si les deux Key sont identiques, aucune Query ne peut les distinguer avec cette règle. Si la variation de la Query est orthogonale à leur différence, leur poids relatif ne change pas non plus.
On récupère enfin le contenu avec ces poids :
\[o_i=\sum_{j=1}^{n}a_{ij}v_j.\]Dans l’analogie des fiches, la Key aide à déterminer si la fiche correspond à la demande ; la Value détermine ce qu’elle apporte. Le Softmax ne modifie pas cette répartition des rôles. Il permet de mélanger continûment plusieurs candidats au lieu de commencer par sélectionner une seule fiche.
5. Calculer toutes les positions ensemble
Jusqu’ici, nous avons suivi un seul lecteur. Une séquence complète répète le même type de lecture.
Supposons que la séquence courante contienne n positions de tokens. Transposons les vecteurs d’entrée et empilons-les en lignes :
\[X= \begin{bmatrix} x_1^\top\\ x_2^\top\\ \vdots\\ x_n^\top \end{bmatrix} \in\mathbb R^{n\times d_{\mathrm{model}}}.\]Ici, n est la longueur de la séquence courante, pas la taille du vocabulaire du tokenizer.
Appliquons les mêmes projections à chaque ligne :
\[Q=XW_Q, \qquad K=XW_K, \qquad V=XW_V.\]Chaque ligne de Q, K et V contient la transposée d’une Query, d’une Key ou d’une Value. Les formes sont :
\[Q,K\in\mathbb R^{n\times d_k}, \qquad V\in\mathbb R^{n\times d_v}.\]« Par token » et « sur toute la séquence » ne sont donc pas deux explications concurrentes. Mathématiquement, chaque position applique indépendamment les projections partagées ; informatiquement, on peut regrouper ces opérations en multiplications matricielles. Ces projections ne mélangent pas elles-mêmes les positions dans cette couche. La comparaison de toutes les Query avec toutes les Key réalise l’interaction entre positions pour cette lecture.
Regroupons les scores, normalisons chaque ligne et récupérons les Values :
\[\boxed{ O= \operatorname{softmax}_{\mathrm{row}}\!\left( \frac{QK^\top}{\sqrt{d_k}} \right)V }\]QKᵀ a la forme n × n. La ligne i contient les scores du lecteur i pour tous les candidats ; la colonne j indique comment tous les lecteurs évaluent le candidat j. O a la forme n × d_v, avec un vecteur récupéré par ligne.3
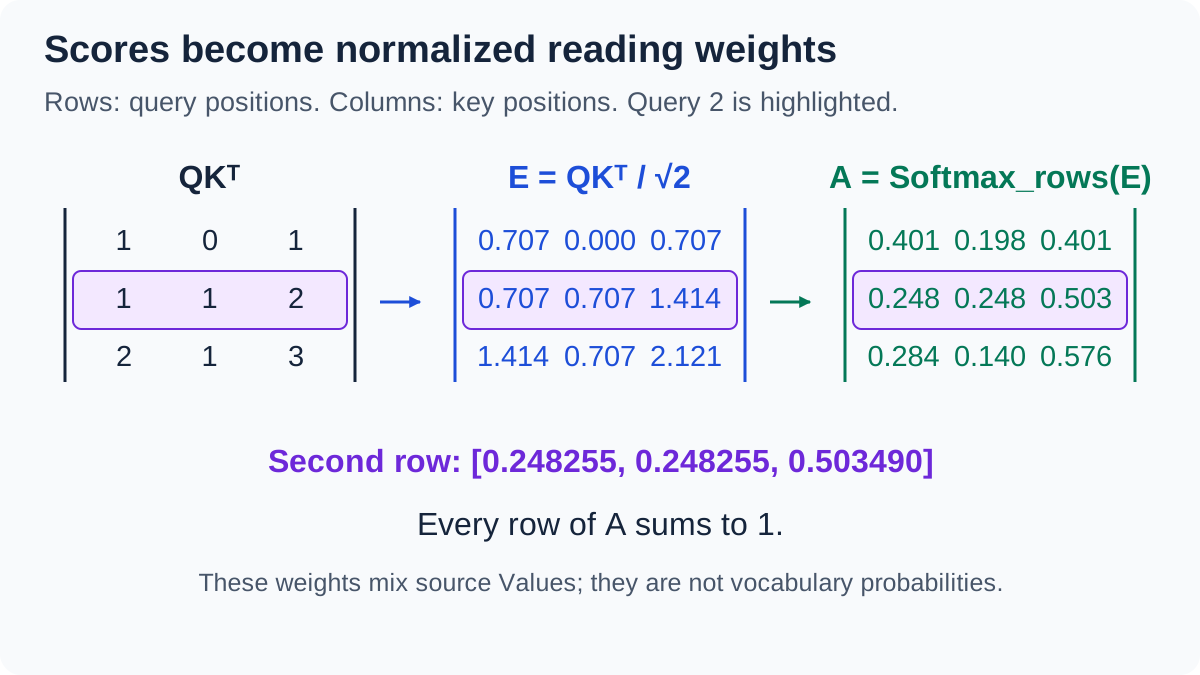
Cette figure anticipe le calcul complet ci-dessous. Les trois lignes sont divisées par √2 avant leur normalisation séparée ; le violet met en évidence la Query 2.
Refaire le calcul sur trois positions
Calculons maintenant un exemple construit. Les positions sont numérotées : nous ne les présenterons pas comme de vrais embeddings de Felix, notebook ou meeting room. Toutes les entrées et matrices de projection sont choisies à la main.
Prenons trois positions et des entrées, Query, Key et Value à deux dimensions :
\[n=3, \qquad d_{\mathrm{model}}=d_k=d_v=2.\]Les entrées et paramètres sont :
\[X= \begin{bmatrix} 1&0\\ 0&1\\ 1&1 \end{bmatrix}, \qquad W_Q= \begin{bmatrix} 1&0\\ 0&1 \end{bmatrix},\] \[W_K= \begin{bmatrix} 1&1\\ 0&1 \end{bmatrix}, \qquad W_V= \begin{bmatrix} 2&0\\ 0&1 \end{bmatrix}.\]On obtient :
\[Q= \begin{bmatrix} 1&0\\ 0&1\\ 1&1 \end{bmatrix}, \qquad K= \begin{bmatrix} 1&1\\ 0&1\\ 1&2 \end{bmatrix}, \qquad V= \begin{bmatrix} 2&0\\ 0&1\\ 2&1 \end{bmatrix}.\]Calculons d’abord tous les produits scalaires :
\[QK^\top= \begin{bmatrix} 1&0&1\\ 1&1&2\\ 2&1&3 \end{bmatrix}.\]Suivons uniquement la position 2. Ses scores mis à l’échelle pour les trois candidats valent :
\[e_2= \frac{1}{\sqrt2}[1,1,2] \approx[0.707107,\;0.707107,\;1.414214].\]Le Softmax donne :
\[a_2\approx[0.248255,\;0.248255,\;0.503490].\]Combinons les trois Values avec ces coefficients :
\[\begin{aligned} o_2 &\approx 0.248255\begin{bmatrix}2\\0\end{bmatrix} + 0.248255\begin{bmatrix}0\\1\end{bmatrix} + 0.503490\begin{bmatrix}2\\1\end{bmatrix}\\ &\approx \begin{bmatrix} 1.503490\\ 0.751745 \end{bmatrix}. \end{aligned}\]Les coordonnées des Key ont produit les coefficients ; celles des Value sont effectivement additionnées. À Q/K fixés, modifier les Values conserve les poids mais peut changer le vecteur récupéré.
Même un poids de mélange de 70 % ne signifie pas qu’une position ait 70 % de chances d’être « l’explication correcte ». Les poids décrivent les coefficients de combinaison de cette lecture ; ils ne constituent pas une probabilité calibrée de justesse sémantique.
Ce ne sont pas non plus des probabilités du prochain token. Les candidats sont des positions d’entrée, pas des éléments du vocabulaire. Ici, o₂ est un vecteur à deux dimensions. Les calculs suivants doivent encore transformer la représentation du modèle en distribution prédictive sur le vocabulaire.
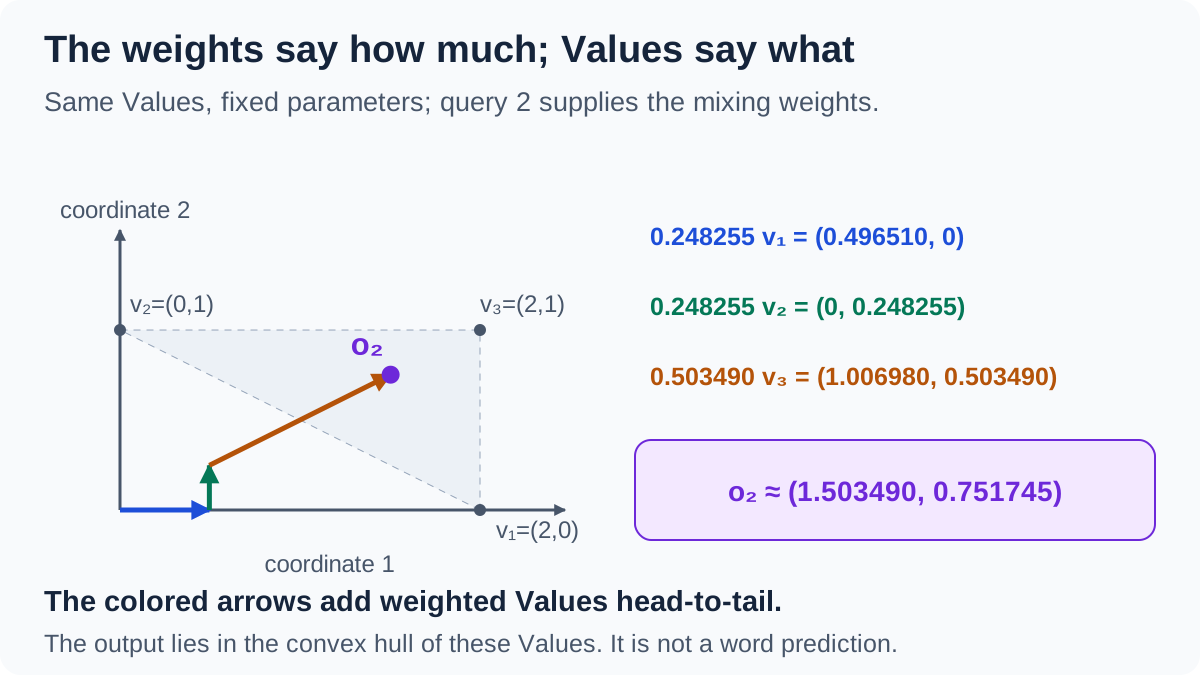
Les flèches colorées montrent une addition de vecteurs dans un seul calcul avant, pas une trajectoire d’entraînement. Les calculs utilisent la pleine précision ; les nombres affichés sont arrondis.
6. Calculer ensemble n’autorise pas à lire le futur
L’exemple précédent permettait à chaque position de lire toutes les autres. Cela illustre la lecture d’une entrée complète, mais pas la règle de visibilité nécessaire à la génération autorégressive.
Pour clarifier les indices, notons t₁ à tₙ les tokens discrets d’entrée, et conservons xᵢ pour le vecteur correspondant. Adoptons cette convention : la position i a reçu le token tᵢ, et sa représentation aide à prédire le token suivant, tᵢ₊₁. La distribution conditionnelle visée est :
\[p_\theta(t_{i+1}\mid t_{1:i}).\]La position i peut donc lire sa propre position et les précédentes, mais pas la suivante, qui contiendrait déjà la réponse.
Pendant l’entraînement, le texte complet est présent dans les données, mais le modèle doit respecter cette contrainte. Le Transformer original combine un décalage entre tokens d’entrée et cibles avec un masquage des connexions d’attention interdites.1
Avec notre convention d’indices, définissons le masque causal :
\[M_{ij}= \begin{cases} 0,&j\le i,\\ -\infty,&j>i. \end{cases}\]Puis calculons :
\[A= \operatorname{softmax}_{\mathrm{row}}\!\left( \frac{QK^\top}{\sqrt{d_k}}+M \right).\]L’exponentielle correspondant à moins l’infini vaut zéro : la normalisation ne porte donc que sur les candidats visibles. Chaque ligne doit conserver au moins une position visible. Autoriser la lecture de soi-même satisfait cette condition ici.
Revenons à la deuxième ligne de l’exemple numérique. La position 3 n’est plus visible, et les scores deviennent :
\[\left[ \frac1{\sqrt2}, \frac1{\sqrt2}, -\infty \right].\]Les poids et la sortie deviennent :
\[a_2^{\mathrm{causal}}=[0.5,\;0.5,\;0], \qquad o_2^{\mathrm{causal}}= \begin{bmatrix} 1\\ 0.5 \end{bmatrix}.\]Les deux premiers poids valaient environ 0.248255 chacun ; ils valent maintenant 0.5. Une fois le futur masqué, les positions restantes se répartissent tout le poids.
C’est pourquoi mettre simplement à zéro les poids futurs après le Softmax ne produit pas la même lecture normalisée. Les annuler puis renormaliser les poids conservés est équivalent en arithmétique exacte. Nous utilisons ici la formulation où le masque précède le Softmax.3
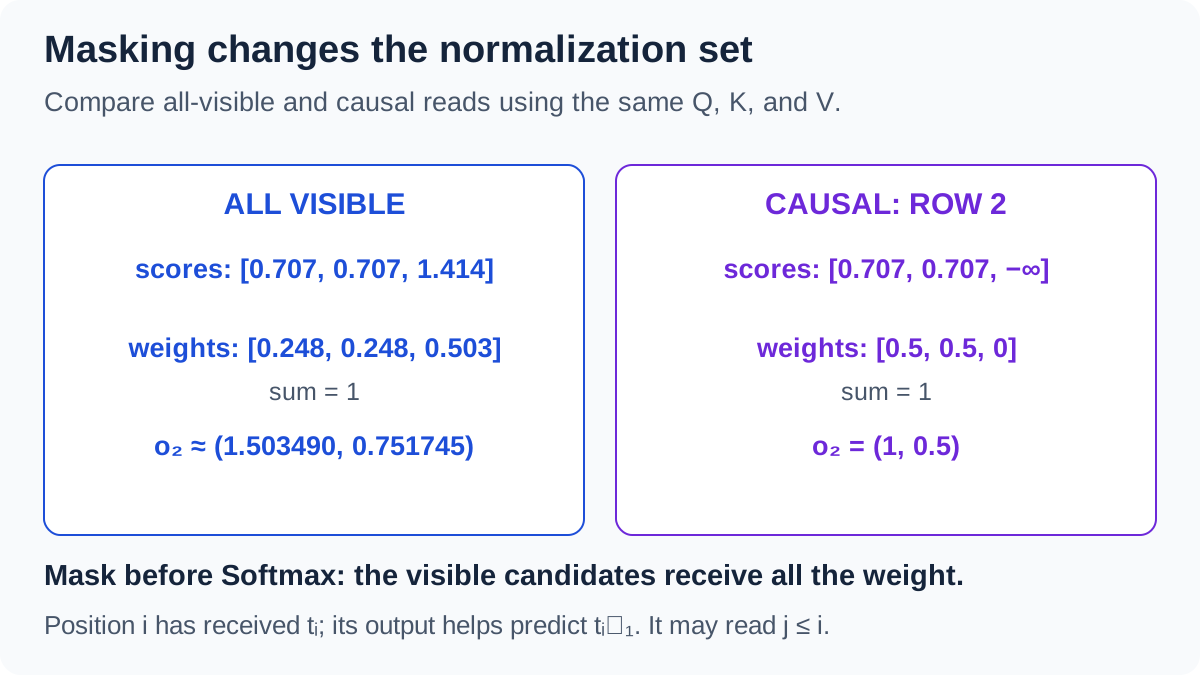
Seule la visibilité change entre la lecture complète et la lecture causale. La position i a reçu son token courant et aide à prédire le suivant ; elle peut donc se lire elle-même.
Les colonnes qu’une ligne est autorisée à lire et la possibilité de calculer plusieurs lignes simultanément sont deux questions distinctes. Dès que les entrées de cette couche sont disponibles, les positions peuvent calculer leurs lectures en parallèle, tandis que le masque limite leurs sources d’information. Dans un modèle causal standard, les couches précédentes doivent elles aussi respecter la visibilité. Un masque ajouté seulement à la dernière couche ne peut pas effacer une fuite d’information future survenue plus tôt.
Le numéro d’une ligne matricielle ne fournit pas non plus, à lui seul, une représentation de position. Avec uniquement les opérations de contenu ci-dessus, sans masque ni mécanisme de position, permuter les lignes d’entrée permute les lignes de sortie de la même manière. Cette équivariance par permutation découle directement du calcul ; elle ne signifie pas que la sortie connaît le numéro de position d’origine de chaque token.
Nous retrouvons ainsi l’article 04 : un mécanisme de position fournit une information exploitable par le calcul. Un masque causal limite séparément les connexions par lesquelles l’information circule ; il n’est pas un encodage vectoriel de position.
7. Pourquoi ces projections apprendraient-elles quelque chose d’utile ?
Nous n’avons pour l’instant défini qu’une structure calculable. Des paramètres aléatoires ne garantissent pas un lien entre he et Felix.
Le signal d’apprentissage vient toujours de la perte de prédiction des articles précédents. La lecture influence la prédiction ultérieure, les scores influencent la lecture, et les Query et Key influencent les scores. On peut remonter ces dépendances jusqu’aux paramètres des projections.
Notons la perte L et le gradient arrivant sur la lecture à la position i par le vecteur colonne gᵢ :
\[g_i=\nabla_{o_i}\mathcal L.\]Pour cette lecture, gardons provisoirement les Values fixes. La dérivation du Softmax et de la somme pondérée donne, pour un candidat visible j :
\[\frac{\partial\mathcal L}{\partial e_{ij}} = a_{ij}\,g_i^\top(v_j-o_i).\]C’est la même relation locale que dans l’article 05. Augmenter le score d’un candidat déplace légèrement le résultat vers sa Value. Le gradient reçu détermine l’effet de ce déplacement sur la perte.
Le produit scalaire fournit les étapes suivantes de la propagation en arrière :
\[\nabla_{q_i}e_{ij}=\frac{k_j}{\sqrt{d_k}}, \qquad \nabla_{k_j}e_{ij}=\frac{q_i}{\sqrt{d_k}}.\]Le gradient peut ensuite traverser les projections pour atteindre W_Q et W_K. La projection Value reçoit ses gradients par l’effet du contenu récupéré sur la perte.
Ce sont des dérivées locales des opérations présentées ici. L’entraînement complet combine les contributions d’autres positions, chemins de calcul et échantillons. Rien ne garantit qu’une mise à jour particulière rapproche un poids d’une interprétation grammaticale humaine.
La prédiction est supervisée ; la lecture reçoit un signal d’apprentissage par son effet sur cette prédiction.
Revenons à I like et They like. La représentation initiale de like peut être identique, mais un contexte disponible différent peut produire une lecture différente. Le calcul part de projections partagées, effectue un appariement dépendant du contenu et renvoie un vecteur lié au contexte visible.
Ce vecteur n’est pas encore la représentation mise à jour complète. Que devient l’information déjà présente à cette position ? Un seul ensemble de poids suffit-il pour plusieurs relations ? Comment le contenu récupéré entre-t-il dans la couche suivante ?
Le prochain article place cette lecture dans un bloc Transformer capable de conserver un chemin direct depuis l’entrée, de combiner plusieurs lectures et de poursuivre la transformation de l’information.
Les exemples, figures et animations ne sont pas des résultats de modèles entraînés. Vérifications numériques et des gradients · Générateur des figures statiques · Entrées numériques communes.
-
Ashish Vaswani et al., Attention Is All You Need, NeurIPS 2017, §3.1–3.2 et §3.4–3.5. Article original. Référence pour les rôles Q/K/V, les projections partagées, le scaled dot-product, la self/cross-attention et le masquage. Les fiches, la phrase prolongée sur Felix, les entrées numériques et les paramètres sont des constructions pédagogiques originales. Les rapports de scores, la précision sur la symétrie, l’équivalence des masquages et les gradients locaux découlent des opérations indiquées, et ne sont pas des résultats d’entraînement rapportés dans l’article. ↩ ↩2 ↩3 ↩4 ↩5
-
Grant Sanderson, Attention in transformers, step-by-step, Deep Learning Chapter 6, 3Blue1Brown, 7 avril 2024. Vidéo · Adaptation textuelle officielle. La progression de l’intuition vers le flux de données a inspiré l’approche visuelle ; aucune image de la vidéo ni aucun code d’animation n’ont été copiés. Ici, les vecteurs de séquence sont empilés en lignes avec un Softmax par ligne ; certaines figures de la leçon utilisent la convention transposée, avec des vecteurs empilés en colonnes. ↩
-
PyTorch, torch.nn.functional.scaled_dot_product_attention, documentation officielle du calcul et des formes. Référence pour vérifier la mise à l’échelle, le masque, le Softmax par ligne et l’agrégation des Value. Les formules élémentaires présentées ici omettent le dropout. ↩ ↩2