First Principles of LLMs & RL · Article 06 · 上一篇
写作说明:想法与初始材料来自我本人。ChatGPT 协助了草稿整理、编辑、翻译、数值核查,以及原创图示与动画源码的制作。
From a Reading Request to Self-Attention, Queries, Keys, and Values — First Principles of LLMs & RL · Article 06
上一篇文章里,Felix 把蓝色笔记本留在了会议室。面对同一句话,寻找笔记本的人关心地点,辨认笔记本的人关心颜色。我们由此建立了一种读取机制:保存一组表示,根据当前状态计算匹配分数,再按权重组合信息。
在那个 encoder–decoder 模型中,读取请求来自 decoder 的状态。但句子中的位置本身也可能需要上下文。一个代词需要与前面出现的人物建立联系,一个动词的表示可能需要包含主语的信息。
这次,我们要把读取请求交给这些位置。不过,在给它们配上 Query、Key、Value 三个名字之前,先把一次读取拆开看。
1. 找到信息与取回信息,是两个不同的工作
仍然看这个句子:
Felix left the blue notebook in the meeting room yesterday.
假设我们手工把其中的信息整理成几张便于查找的资料卡。某张卡的检索标签是“笔记本、存放位置”,卡片内容是“会议室”;另一张的标签是“笔记本、颜色”,内容是“蓝色”。
当我们问“笔记本在哪里”,需要先判断哪张卡与这个请求匹配,再取回它所提供的内容。
| 这次想查什么 | 候选记录用什么线索参与匹配 | 匹配后取回什么 |
|---|---|---|
| 笔记本在哪里? | 笔记本、存放位置 | 会议室 |
| 笔记本是什么颜色? | 笔记本、颜色 | 蓝色 |
“这是一条位置信息”帮助我们找到记录,却还没有回答“具体在哪里”。同一类检索线索,也可以对应另一张内容为“办公室”的卡片。
用于找到信息的特征,不必就是找到以后要传递的内容。
现在给三个角色命名。
Query 是当前的读取请求。 在例子里,它表达我们正在查找笔记本的位置。
Key 是候选内容用来参与匹配的表示。 在例子里,“笔记本、存放位置”提供了与请求比较的线索。
Value 是这条候选在被读取时提供的内容。 在例子里,它告诉我们具体地点是会议室。
这张表只是人为整理的检索示意。真实模型不会先把句子转换成这样一套带中文标签的资料卡。Transformer 中的 Query、Key、Value 都是向量;匹配关系和传递内容通过可学习的计算形成。1
这个类比要保留的是功能的区分,不是标签本身。Key 和 Value 可以包含重叠的信息;它们也不一定是一份内容的“简略版”和“完整版”。分开这两个角色,只是允许模型为匹配与传递内容分别学习合适的表示。
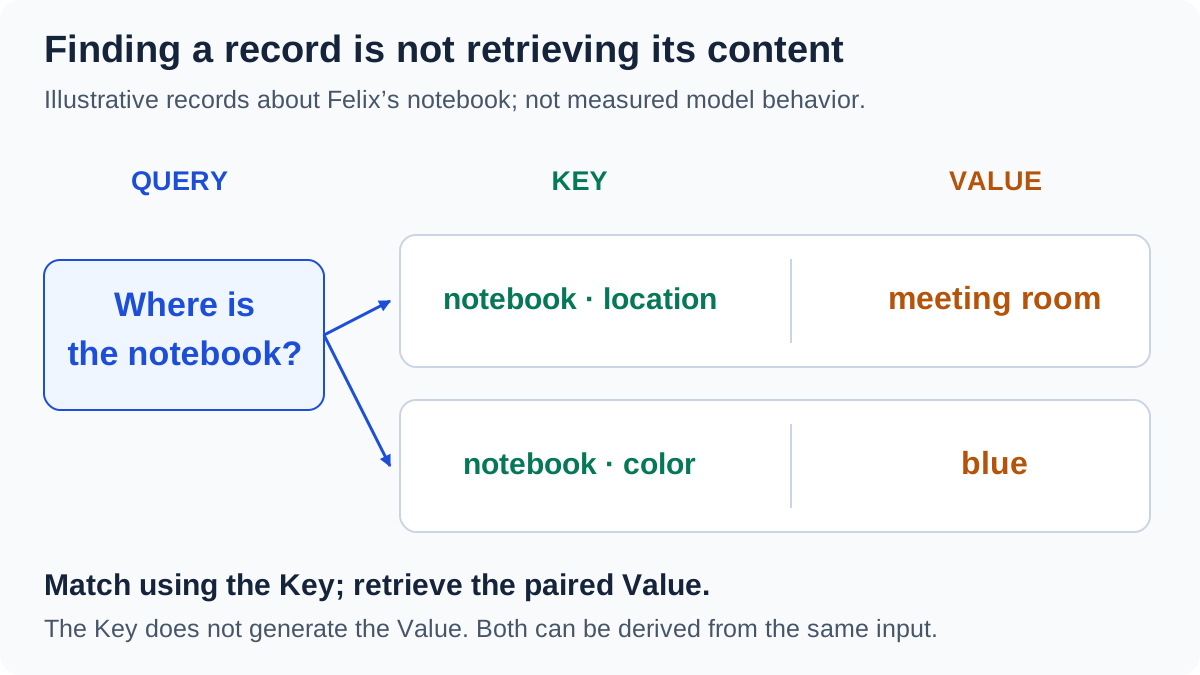
资料卡是功能类比,不是模型内部的人工语义标签。图示与动画的请求优先讲解顺序参考了 3Blue1Brown 的 attention 视频;全部画面与数值为本文独立制作。2
2. 当请求来自句子内部
到这里,提出问题的还是一个外部读者。现在把句子稍微延长:
Felix left the blue notebook in the meeting room because he was in a hurry.
对于人类读者,前文的 Felix 为理解 he 提供了线索。我们可以据此提出一个模型设计要求:处理 he 的位置,应当有办法读取前面的人物信息。
沿用刚才的角色区分,可以把它粗略描述为:he 所在位置发出一个寻找相关人物线索的请求;前面的各个位置提供可供比较的线索;读取结果带回一些有关候选人物的向量信息,交给后续计算。
这里没有预设模型真的生成了一句“请找到这个代词指的是谁”,也没有声称一次 attention 就完成了指代消解。这是一个说明信息需求的例子,而不是某个训练后模型的观测结果。所谓“请求”,最终仍然要由当前位置已有的表示计算出来。
于是,每个位置都有两种身份。它可以作为读者,按照自己的请求读取其他位置;也可以作为信息来源,向其他读者提供 Key 和 Value。
当请求与被读取内容都来自同一组序列表示时,这种组织方式叫 Self-Attention。Self 指的是信息来源相同,不是只允许一个位置读取它自己。若请求来自 decoder,而被读取内容来自 encoder,则是跨序列的读取,通常称为 Cross-Attention。1
这与怎样计算匹配是两回事。我们可以讨论请求来自哪里,也可以另外选择 additive scoring 或 dot-product scoring。Self-Attention 并不在逻辑上强迫我们采用某一条评分公式。
还记得 Article 04 的 I like 与 They like 吗?假定 like 的 token ID 和位置相同,独立的 embedding lookup 加上相同的位置向量,仍会得到相同的初始表示。
这并不意味着它接下来只能得到相同的结果。相同的初始请求,面对不同的 Keys 和 Values,也可以读到不同的内容。 模型不必先把上下文全部理解完,才有资格开始读取上下文。
3. 把三个角色变成可以学习的计算
先只看一个位置。
令 xᵢ 表示第 i 个位置在当前层入口处的向量,表示宽度为 d_model。沿用上一篇的约定,单个位置的向量写成列向量:
\[x_i\in\mathbb R^{d_{\mathrm{model}}}.\]在第一层,它可以来自 token embedding 和位置信息的组合;在更深的层,它已经是前面计算产生的表示。这里的 xᵢ 是向量,不是离散的 token ID。
要让同一个输入承担三种角色,一个简单、可学习的办法是使用三组线性投影。用 W_Q、W_K、W_V 分别表示它们的参数,得到:
\[q_i=W_Q^\top x_i, \qquad k_i=W_K^\top x_i, \qquad v_i=W_V^\top x_i.\]线性投影会重新组合输入的各个坐标。它并不需要事先知道哪一维是“人物”、哪一维是“地点”;这些投影是否形成对任务有用的匹配与内容表示,由训练来决定。本文只讨论一组投影对应的基础读取,不加入偏置、dropout 或后续输出投影。1
令 d_k 为 Query 和 Key 的维度,d_v 为 Value 的维度,则参数形状是:
\[W_Q,W_K\in\mathbb R^{d_{\mathrm{model}}\times d_k}, \qquad W_V\in\mathbb R^{d_{\mathrm{model}}\times d_v}.\]Query 与 Key 要在下面的点积中直接比较,所以二者维度相同。Value 不参与这个点积,它的维度可以另外选择。
还有一个容易混淆的区别:每个位置有自己的 Query 向量,但不是每个位置都有一套独立的 Query 参数。 在这里,同一层的所有位置使用相同的 W_Q;Key 和 Value 的投影也分别共享参数。输入不同,计算出的向量可以不同。
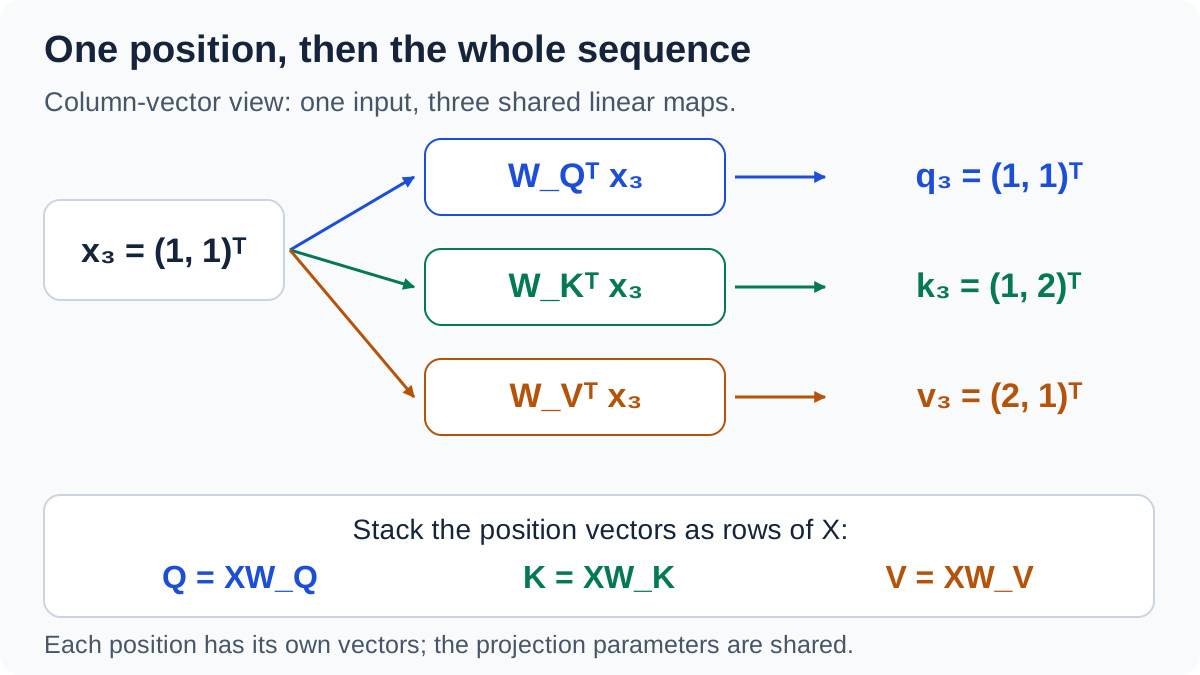
单向量采用列向量约定,整段序列按行堆叠。这里用手工输入 x₃ 展示三种角色;不声称坐标有具体词义。
一个请求怎样与候选匹配?
对于位置 i 的请求 qᵢ,以及位置 j 的候选线索 kⱼ,考虑点积:
\[q_i^\top k_j = \sum_{r=1}^{d_k}q_{ir}k_{jr}.\]如果暂时把每个坐标想成一种可比较的特征,那么这一步就是:把请求在各个坐标上的取向,与候选在相应坐标上的取值逐项相乘,再加起来。
这个解释只是在说明运算。它不保证真实向量的坐标具有能够单独命名的语言学意义。点积还受向量长度影响,也不自动等于语义相似度。
把投影代进去,可以看见训练到底能够改变什么:
\[q_i^\top k_j = x_i^\top W_QW_K^\top x_j.\]输入向量并不是在一个固定、天然正确的语义空间里直接比较。中间的可学习矩阵决定了哪些输入方向怎样参与匹配。
在语言例子里,he 与 Felix 的关系也不只是“两个词很相似”。一个位置需要寻找相关人物,另一个位置可能提供人物信息。我们希望学到的是适合这次读取的匹配,而不只是找到与当前词最相似的词。
当然,也可以不做这两种独立投影,直接计算输入之间的内积。但那样的原始分数满足:
\[x_i^\top x_j=x_j^\top x_i.\]独立的 Query、Key 投影不要求原始分数保持这种对称性。它允许“位置 i 如何读取位置 j”与反过来的匹配采用不同关系。这说的是原始分数;即使原始分数矩阵对称,后续逐行归一化的权重也未必对称,因为不同的行可以有不同的归一化分母。
Value 的分离则回答另一件事:即使已经确定从某个位置读取,交给下游的也不必是刚才用于计算匹配的那组坐标。
4. 从匹配分数到一次读取
点积提供了分数,但分数还不是最终的读取系数。我们先处理它的尺度,再决定怎样根据分数组合内容。
为什么维度增加时,要调整分数的尺度?
上一篇已经使用过 Softmax。它对分数的相对差距敏感:差距很大时,权重容易集中到少数位置。
而点积包含的乘积项数量,会随 Query、Key 的维度增加。为了看清这种影响,做一个理想化分析:假设 q、k 的所有分量相互独立,均值为零,方差为一。
对于同一坐标上的乘积,有:
\[\mathbb E[q_rk_r]=0, \qquad \mathbb E[q_r^2k_r^2] = \mathbb E[q_r^2]\mathbb E[k_r^2] =1.\]所以:
\[\operatorname{Var}(q_rk_r)=1.\]不同坐标的乘积项在这些假设下也相互独立,求和后的方差因此为:
\[\operatorname{Var}(q^\top k)=d_k, \qquad \operatorname{Std}(q^\top k)=\sqrt{d_k}.\]注意,随维度相加的是方差;标准差要再开平方。这就是缩放中出现平方根,而不是直接出现维度本身的原因。
将点积除以这个标准差尺度,在上述假设下会得到单位方差:
\[\operatorname{Var}\!\left(\frac{q^\top k}{\sqrt{d_k}}\right)=1.\]因此,把用于读取的分数定义为:
\[e_{ij}=\frac{q_i^\top k_j}{\sqrt{d_k}}.\]这是原始 Transformer 解释 scaled dot-product attention 的动机:避免分数仅因维度变大,就把 Softmax 推向梯度很小的区域。实际 Query、Key 来自可学习的表示,甚至可以来自同一个位置,因此不保证满足刚才的独立性假设;缩放也不保证训练中的分数始终具有单位方差。1
直接用分数乘以内容,不可以吗?
可以。只是我们必须接受这种选择带来的性质。
为了单独观察这一点,取一个与语言无关的标量例子。两个候选的分数为 2 和 1,它们的 Values 分别为 10 和 20。直接把分数当作系数,得到:
\[o_{\mathrm{raw}}=2\times10+1\times20=40.\]现在给两个分数都加上 100。两者仍相差 1,但结果变成:
\[o_{\mathrm{raw}}'=102\times10+101\times20=3040.\]这不构成数学矛盾。它只是说明:raw-score mixing 同时使用分数的绝对基线和相对差距。
如果我们希望一次读取只由候选之间的相对分数决定,就需要另一种从分数到系数的映射。Softmax 是一种选择。记 aᵢⱼ 为位置 i 分给候选 j 的权重:
\[a_{ij} = \frac{\exp(e_{ij})}{\sum_{m=1}^{n}\exp(e_{im})}.\]这里 n 是参与读取的候选位置数;暂时假定所有位置都可见、分数有限且至少有一个候选。权重因此满足:
\[a_{ij}>0, \qquad \sum_{j=1}^{n}a_{ij}=1.\]Softmax 对共同偏移不敏感,所以刚才的两组分数得到相同的权重:
\[\operatorname{softmax}([2,1]) = \operatorname{softmax}([102,101]) \approx[0.731059,\;0.268941].\]现在读到的内容是:
\[o \approx 0.731059\times10+0.268941\times20 \approx12.689414.\]这里选择的是一种归一化的读取,而不是任意的线性混合。 对固定的 Values,非负且总和为一的系数使结果成为它们的凸组合。若 Values 是向量,结果位于这些向量的凸包内;它不会仅仅因为系数总和增大就被任意放大。
这并不证明所有 attention 都必须使用 Softmax。我们完全可以选择另一种分数到权重的映射,再分析它允许负权重吗、是否归一化、怎样控制输出尺度。合法的矩阵运算与我们想要的读取性质,是两个不同的问题。
Article 02 还给过另一个视角:对候选分配概率时,在偏向高分与保留 entropy 之间做权衡,会得到 Softmax 形式。将那里固定的动作价值换成这里的匹配分数,可以得到同样的数学结构。这是对固定分数下分配规则的解释,不意味着 attention 另外运行了一轮 RL 训练。
为什么这次请求不会在归一化中消失?
Article 05 有过一个反例:把 additive scorer 中的 tanh 去掉,只剩请求项与候选项的线性相加,请求的贡献就成了所有候选共享的偏移,随后被 Softmax 消掉。
现在用的是乘性交互。对于两个可见候选 j 和 m,直接利用 Softmax 的比值关系:
\[\begin{aligned} \log\frac{a_{ij}}{a_{im}} &=e_{ij}-e_{im}\\ &=\frac{q_i^\top(k_j-k_m)}{\sqrt{d_k}}. \end{aligned}\]改变 Query,可以改变两个候选的相对分数,进而改变相对读取权重。 它不再只能给所有候选添加同一个偏移。
这是一种让请求与候选共同决定分数的方式,不是从 additive attention 推导出的唯一替代。如果两个 Keys 完全相同,任何 Query 都无法通过这条评分规则区分它们;如果 Query 的变化恰好与二者差向量正交,二者的相对权重也不会因此改变。
最后,用这些权重取回内容:
\[o_i=\sum_{j=1}^{n}a_{ij}v_j.\]回到资料卡的例子,Key 参与的是“这一条与请求匹配吗”,Value 参与的是“这一条具体向读取结果贡献什么”。Softmax 没有改变这个分工,只是让读取可以连续地混合多个候选,而不必先硬选出唯一的一张卡。
5. 把所有位置一起算出来
到目前为止,我们一直站在一个读者的位置上看计算。整段序列其实只是在重复同一种读取。
设当前序列有 n 个 token 位置,把各个输入列向量转置后,依次放进矩阵的行:
\[X= \begin{bmatrix} x_1^\top\\ x_2^\top\\ \vdots\\ x_n^\top \end{bmatrix} \in\mathbb R^{n\times d_{\mathrm{model}}}.\]这里 n 是当前序列的长度,不是 tokenizer 词表的大小。
对每一行使用同一组投影,可以一次写成:
\[Q=XW_Q, \qquad K=XW_K, \qquad V=XW_V.\]其中 Q、K 的每一行分别存放一个 Query、Key 的转置,V 的每一行存放一个 Value 的转置。形状为:
\[Q,K\in\mathbb R^{n\times d_k}, \qquad V\in\mathbb R^{n\times d_v}.\]因此,这并不是“逐 token 计算”和“整个 sequence 计算”二选一。数学上,各位置独立应用共享投影;实现上,可以把它们合并成一次矩阵乘法。 Q/K/V 的投影本身不混合当前层不同位置的信息;随后比较所有 Query 与所有 Key,才发生本次读取的位置间交互。
把所有分数排在一起,再逐行归一化,最终得到:
\[\boxed{ O= \operatorname{softmax}_{\mathrm{row}}\!\left( \frac{QK^\top}{\sqrt{d_k}} \right)V }\]QKᵀ 的形状是 n × n:第 i 行是读者 i 对所有候选的分数,第 j 列是候选 j 被各个读者评分的结果。输出 O 的形状是 n × d_v,每一行对应一次读取所得的向量。3
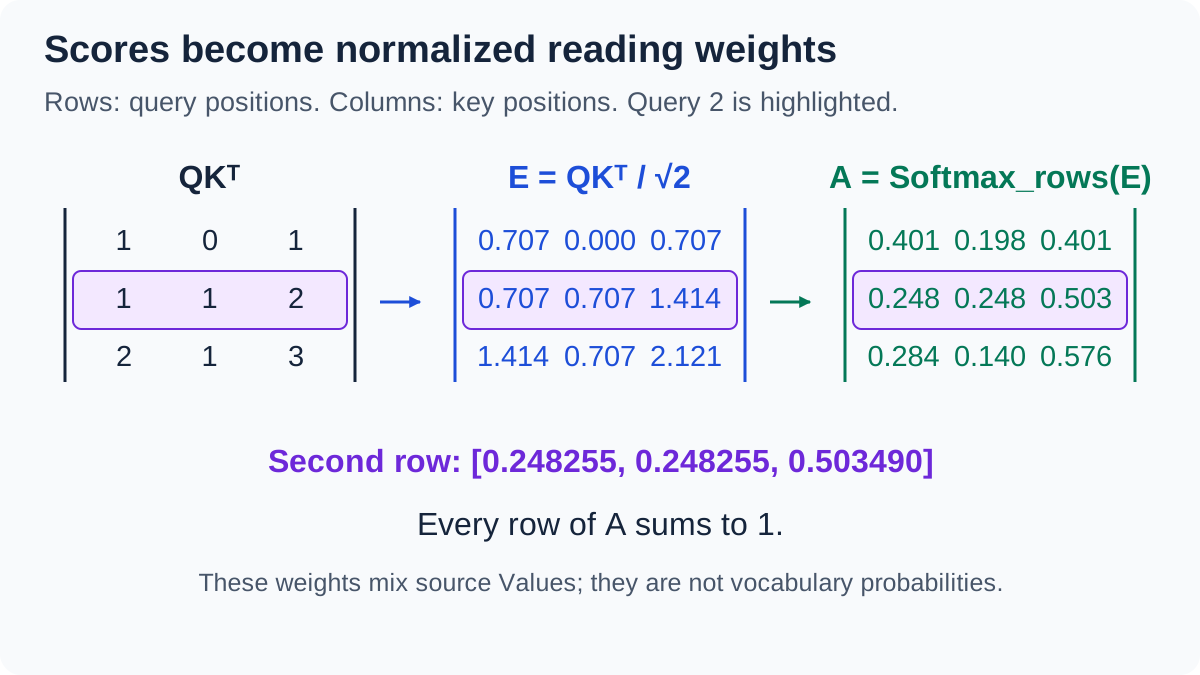
此图预览下一小节的完整算例。三行都先除以 √2,再各自归一化;紫色标出第二个 Query。
用三个位置复算
下面用一个构造例子复算。三个位置只用编号,不把它们冒充为 Felix、notebook 或 meeting room 的真实 embeddings。所有输入和投影矩阵都是手工指定的。
取三个位置、二维输入,以及二维的 Query、Key、Value:
\[n=3, \qquad d_{\mathrm{model}}=d_k=d_v=2.\]输入和参数为:
\[X= \begin{bmatrix} 1&0\\ 0&1\\ 1&1 \end{bmatrix}, \qquad W_Q= \begin{bmatrix} 1&0\\ 0&1 \end{bmatrix},\] \[W_K= \begin{bmatrix} 1&1\\ 0&1 \end{bmatrix}, \qquad W_V= \begin{bmatrix} 2&0\\ 0&1 \end{bmatrix}.\]于是:
\[Q= \begin{bmatrix} 1&0\\ 0&1\\ 1&1 \end{bmatrix}, \qquad K= \begin{bmatrix} 1&1\\ 0&1\\ 1&2 \end{bmatrix}, \qquad V= \begin{bmatrix} 2&0\\ 0&1\\ 2&1 \end{bmatrix}.\]先计算全部点积:
\[QK^\top= \begin{bmatrix} 1&0&1\\ 1&1&2\\ 2&1&3 \end{bmatrix}.\]只跟踪第二个位置。它对三个候选的缩放分数为:
\[e_2= \frac{1}{\sqrt2}[1,1,2] \approx[0.707107,\;0.707107,\;1.414214].\]Softmax 得到:
\[a_2\approx[0.248255,\;0.248255,\;0.503490].\]再根据这些系数组合三个 Values:
\[\begin{aligned} o_2 &\approx 0.248255\begin{bmatrix}2\\0\end{bmatrix} + 0.248255\begin{bmatrix}0\\1\end{bmatrix} + 0.503490\begin{bmatrix}2\\1\end{bmatrix}\\ &\approx \begin{bmatrix} 1.503490\\ 0.751745 \end{bmatrix}. \end{aligned}\]这条计算中,Key 的坐标用于得到系数,Value 的坐标才是最后被相加的内容。若保持 Q/K 不变,只更换 Values,权重不变,但读到的向量可以改变。
即使一个位置获得了 70% 的混合权重,也不能因此说它有 70% 的概率是“正确解释”。权重描述这一次读取的组合系数;它没有独立校准语义正确性的含义。
权重也不是下一个 token 的预测概率。它的候选是输入位置,不是输出词表。这里得到的 o₂ 是二维向量;模型还要经过后续计算,才会形成词表上的预测分布。
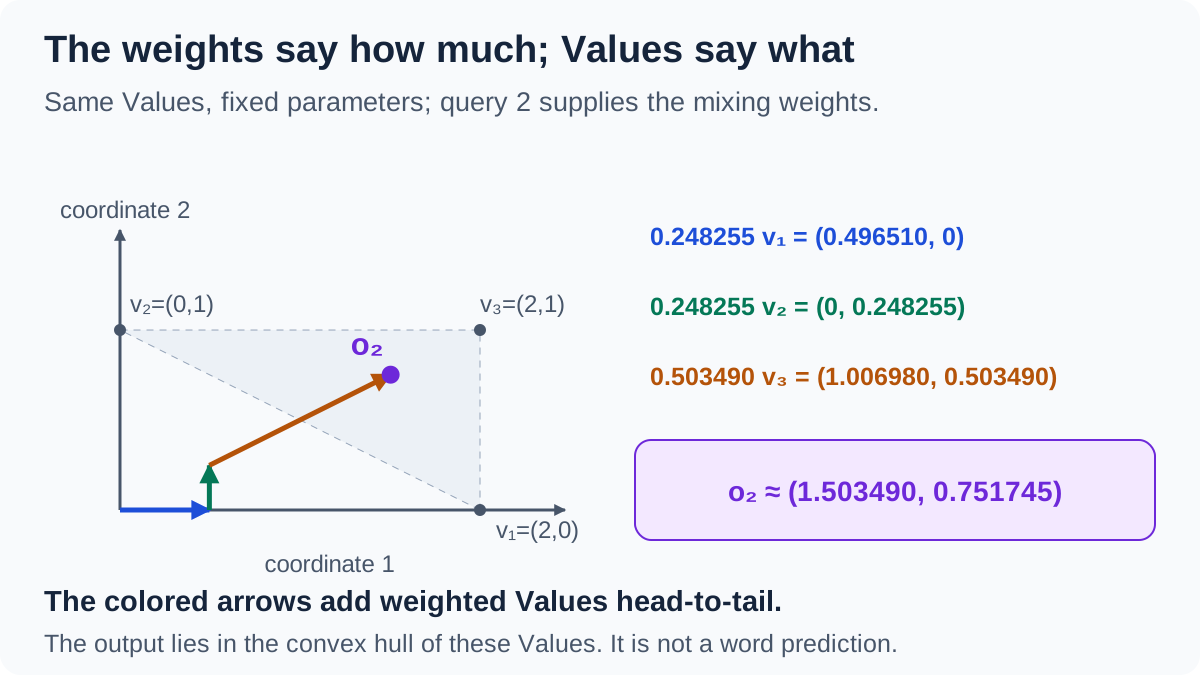
彩色箭头表示一次前向计算中的加权向量相加,不是训练轨迹。完整精度用于计算,画面中的数值经过舍入。
6. 同时计算,不等于可以读取未来
刚才的例子让三个位置互相可见。这适合说明完整输入上的读取,却还不是自回归生成所需要的可见性规则。
为了避免索引混淆,用 t₁ 到 tₙ 表示离散的输入 tokens,仍用 xᵢ 表示对应的向量。本文采用这样的预测约定:位置 i 已经接收到 token tᵢ,它产生的表示用于预测下一个 token tᵢ₊₁。 目标条件分布是:
\[p_\theta(t_{i+1}\mid t_{1:i}).\]因此,位置 i 可以读取自己和以前的位置,却不能读取已经包含答案的下一个位置。
训练时整段文本虽然已经在数据里,模型仍须遵守这个约束。原始 Transformer 通过输入与目标的错位,以及对非法 attention 连接的遮挡,维护自回归可见性。1
在我们的索引约定下,定义 causal mask:
\[M_{ij}= \begin{cases} 0,&j\le i,\\ -\infty,&j>i. \end{cases}\]然后计算:
\[A= \operatorname{softmax}_{\mathrm{row}}\!\left( \frac{QK^\top}{\sqrt{d_k}}+M \right).\]负无穷对应的指数为零,所以归一化只在可见候选之间进行。每一行至少要留有一个可见位置;这里允许读取自身,因此满足这个条件。
回到数值例子的第二行。位置 3 不再可见,分数变成:
\[\left[ \frac1{\sqrt2}, \frac1{\sqrt2}, -\infty \right].\]读取权重与输出随之变成:
\[a_2^{\mathrm{causal}}=[0.5,\;0.5,\;0], \qquad o_2^{\mathrm{causal}}= \begin{bmatrix} 1\\ 0.5 \end{bmatrix}.\]注意,原来前两项各约为 0.248255,现在各为 0.5。遮住未来以后,剩余位置重新分配了全部权重。
这也是为什么不能只在 Softmax 后把未来位置清零、就把剩下的数当作同一个归一化读取。若清零后再重新归一化,在精确算术下可以得到等价结果;本文采用的是 Softmax 前加 mask 的写法。3
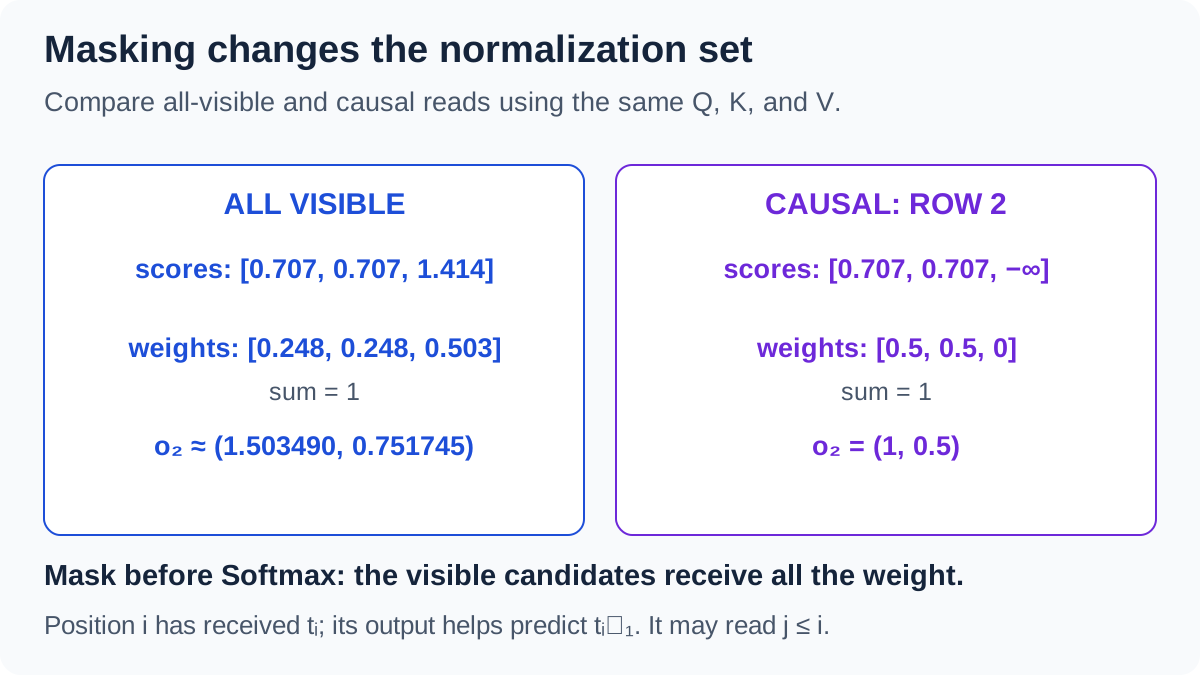
这里只对比完整可见与 causal 两种读取。位置 i 已接收当前 token,帮助预测下一个 token,因此允许读取自身。
一行能读取哪些列,与多行能否同时计算,是不同的问题。 只要这一层的输入已经准备好,各位置可以并行计算自己的读取,而 mask 限制每一行的信息来源。在标准 causal 模型中,前面的层也必须遵守相应的可见性规则;最后一层加一个 mask,不能清除早先已经泄露的未来信息。
至于位置本身,也不能仅靠矩阵的行号凭空获得。若只有前面那组不含位置信息、也无遮罩的内容匹配运算,重排输入行只会使输出相应重排。这是从运算直接得到的 permutation equivariance,并不代表输出已经知道各个 token 原来位于第几位。
这正好接回 Article 04:位置机制提供可以被使用的信息。Causal mask 则另行限制信息可沿哪些连接流动;它不等同于向量形式的位置编码。
7. 这些投影为什么会学到有用的东西?
目前我们只规定了一个可计算的结构。给它随机参数,并不能保证它会把 he 与 Felix 联系起来。
学习信号仍然来自前几篇反复使用的预测损失。读取结果影响后续预测,匹配分数影响读取结果,Query 和 Key 又影响匹配分数。我们可以沿着这条计算路径,把损失的局部变化传回投影参数。
把这一点具体写出来。令损失为 L,并将传回位置 i 读取结果的梯度记为列向量 gᵢ:
\[g_i=\nabla_{o_i}\mathcal L.\]在这一次读取中,暂时保持 Values 不变。对可见候选 j,Softmax 与加权和的求导给出:
\[\frac{\partial\mathcal L}{\partial e_{ij}} = a_{ij}\,g_i^\top(v_j-o_i).\]这与 Article 05 得到的是同一种局部关系:提高一个候选的分数,会把读取结果往这个 Value 的方向拉近一点;这样的移动对损失有什么影响,由传回来的梯度决定。
点积评分又提供了继续向前传递的路径:
\[\nabla_{q_i}e_{ij}=\frac{k_j}{\sqrt{d_k}}, \qquad \nabla_{k_j}e_{ij}=\frac{q_i}{\sqrt{d_k}}.\]再经过线性投影,梯度就能够到达 W_Q 和 W_K。Value 的投影则通过被读取内容对损失的影响获得梯度。
这些是本次读取的局部导数,由本文公式直接得到。完整训练还要合并其他位置、其他路径和样本的贡献;不能据此保证某一次参数更新就让一个权重更符合人类对语法的判断。
我们监督的是预测,读取方式通过它对预测的影响得到学习信号。
现在再回到 I like 与 They like。初始的 like 可以有相同的向量,但它面对的上下文不同,一次读取就有可能带回不同的信息。真正的计算从共享投影开始,经过内容相关的匹配,最后得到一个与可见上下文有关的向量。
这个向量还不是完整的新表示。当前位置原本的信息怎么办?一组读取权重能否兼顾不同的关系?读回来的内容怎样进入下一层?
下一篇从这里继续:把一次读取放进一个能够保留原表示、组合多种读取结果并继续变换信息的 Transformer block。
数值例子、图示与动画不代表训练后模型的实验结果。数值与梯度复算 · 静态图生成源码 · 共享数值输入。
-
Ashish Vaswani et al., Attention Is All You Need, NeurIPS 2017,§3.1–3.2、§3.4–3.5。原文:arXiv HTML。本文参考其中 Q/K/V 的角色、共享线性投影、scaled dot-product、self/cross-attention 与 masking 的定义。资料卡、Felix 的延长例句、数值输入与参数均为独立构造的教学材料;分数比值、对称性限定、mask 等价关系及局部梯度由本文所写运算直接推导,并非原论文报告的训练结果。 ↩ ↩2 ↩3 ↩4 ↩5
-
Grant Sanderson, Attention in transformers, step-by-step, Deep Learning Chapter 6, 3Blue1Brown,2024-04-07。视频 · 官方文字版。参考其从直觉到数据流的教学顺序;本文未复制视频帧或动画源码。本文把序列向量按行堆叠、逐行做 Softmax;该课程的部分画面采用列向量堆叠的转置约定。 ↩
-
PyTorch,torch.nn.functional.scaled_dot_product_attention 官方文档,计算定义与形状说明。用于对照缩放、mask、逐行 Softmax 与 Value 加权的计算顺序;本文的基础公式省略 dropout。 ↩ ↩2